Polskie napisy w Qwen-Image-2.1: pięć testów z ogonkami, znak po znaku
Ogonki nie są problemem - problemem są długie wyrazy. Model nie gubi kreski nad literą, tylko podmienia całe litery.
👁 119 przeczytań
- Qwen-Image-2.1 poprawnie odtworzył polskie ogonki w 4 z 5 testów, w tym słowo ŻÓŁĆ z czterema znakami diakrytycznymi naraz.
- Błędy nie polegały na gubienia ogonków, lecz na podmianie całych liter: W na V, E na A, Ż na Ź - głównie w rzadkich polskich słowach.
- Najdłuższy bezbłędny napis miał 29 znaków w dwóch wierszach, a każdy obraz generował się lokalnie na RTX 4090 w około 44 sekundy.
Modele obrazowe od lat wykładają się na polskich ogonkach: Ł traci kreskę, Ż gubi kropkę, Ę zamienia się w E. Puściłem przez Qwen-Image-2.1 pięć szyldów po polsku i policzyłem znak po znaku, co wyszło. Wynik mnie zaskoczył, ale nie w tę stronę, w którą się spodziewałem.
Werdykt w jednym akapicie
Ogonki nie są problemem - problemem są długie wyrazy. Na pięć testów trzy wyszły bezbłędnie, w tym najtrudniejsze polskie słowo świata, czyli „ŻÓŁĆ” z kompletem czterech znaków diakrytycznych. Napis na 29 znaków bez ogonków też przeszedł bez jednej pomyłki. Sypnęło się dopiero tam, gdzie model musiał napisać długie, rzadkie słowo - i wtedy nie gubił kreski nad literą, tylko podmieniał całe litery: W na V, E na A. To jest zupełnie inny rodzaj błędu, niż wszyscy się spodziewają, i ma inne obejście.
Wyniki testu, znak po znaku
| Zamówiony napis | Znaków | Co wyszło | Ocena |
|---|---|---|---|
| ŻÓŁĆ | 4 | ŻÓŁĆ | bezbłędnie |
| POZDROWIENIA Z ŁODZI | 20 | POZDROWIENIA Z ŁODZI | bezbłędnie |
| ZAKAZ WJAZDU - TEREN PRYWATNY | 29 | ZAKAZ WJAZDU - TEREN PRYWATNY | bezbłędnie |
| ŚWIEŻE PIECZYWO CODZIENNIE | 26 | ŚWIEŻE PIECZYWO CODZIANNIE | jedna litera |
| KSIĘGARNIA POD ŻÓŁWIEM | 22 | KSIĘGARNIA POD ŹÓLVIEM | trzy błędy |
Wszystko wygenerowane lokalnie, wariantem int8, po 25 kroków, przy pierwszym podejściu - bez dobierania ziarna i bez powtórek.
Test pierwszy: ŻÓŁĆ, czyli cztery ogonki naraz
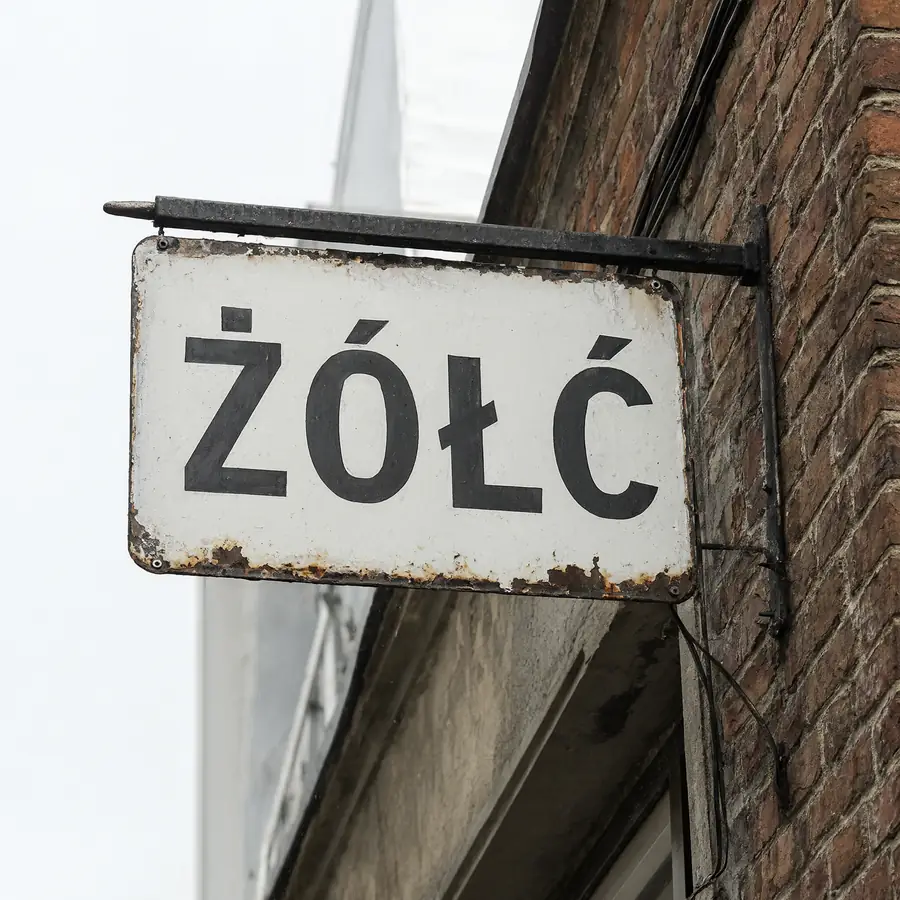
Emaliowany szyld z napisem ŻÓŁĆ. Wszystkie cztery znaki diakrytyczne poprawne: kropka nad Ż, kreska nad Ó, kreska w Ł, kreska nad Ć.
To jest słowo, na którym wykłada się większość modeli, bo ma cztery różne znaki diakrytyczne w czterech literach. Qwen napisał je poprawnie za pierwszym razem: kropka nad Ż na miejscu, kreska nad Ó, przekreślone Ł, kreska nad Ć.
Co więcej, litery mają spójny krój, równe światła i realistyczne odpryski emalii. To nie jest napis doklejony do obrazu - to napis, który wygląda na pomalowany razem z tabliczką.
Test drugi: pocztówka z Łodzi
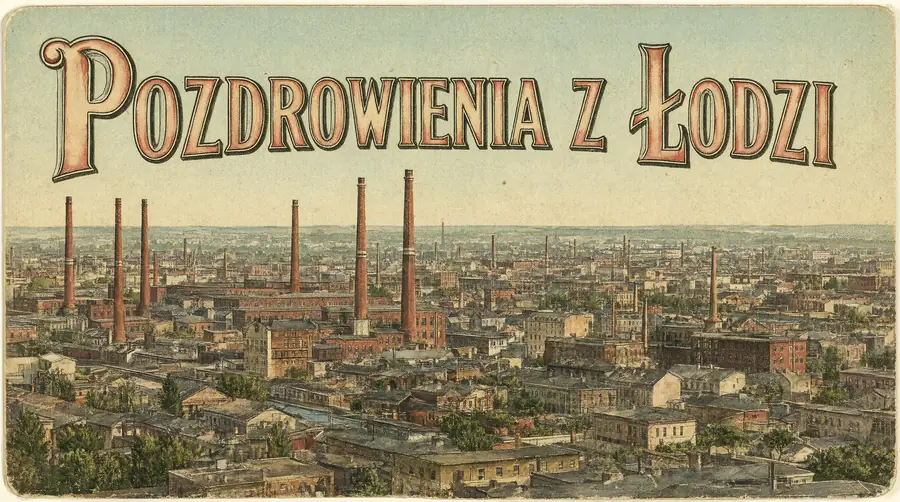
POZDROWIENIA Z ŁODZI w ozdobnym kroju z XIX-wiecznych pocztówek, z poprawnym Ł. W tle panorama miasta z kominami fabrycznymi.
Tu poprzeczka była wyżej: napis miał być w ozdobnym, wiktoriańskim kroju z cieniowaniem - a to zwykle rozsypuje litery diakrytyczne, bo kreska w Ł musi się wpisać w zdobiony korpus litery.
Wyszło bezbłędnie, razem z panoramą przemysłowej Łodzi, której nie było w moim poleceniu wprost - poprosiłem o „rzeczne miasto z ceglanymi kominami”, a model dołożył kontekst sam.
Test trzeci: długa tabliczka bez ogonków
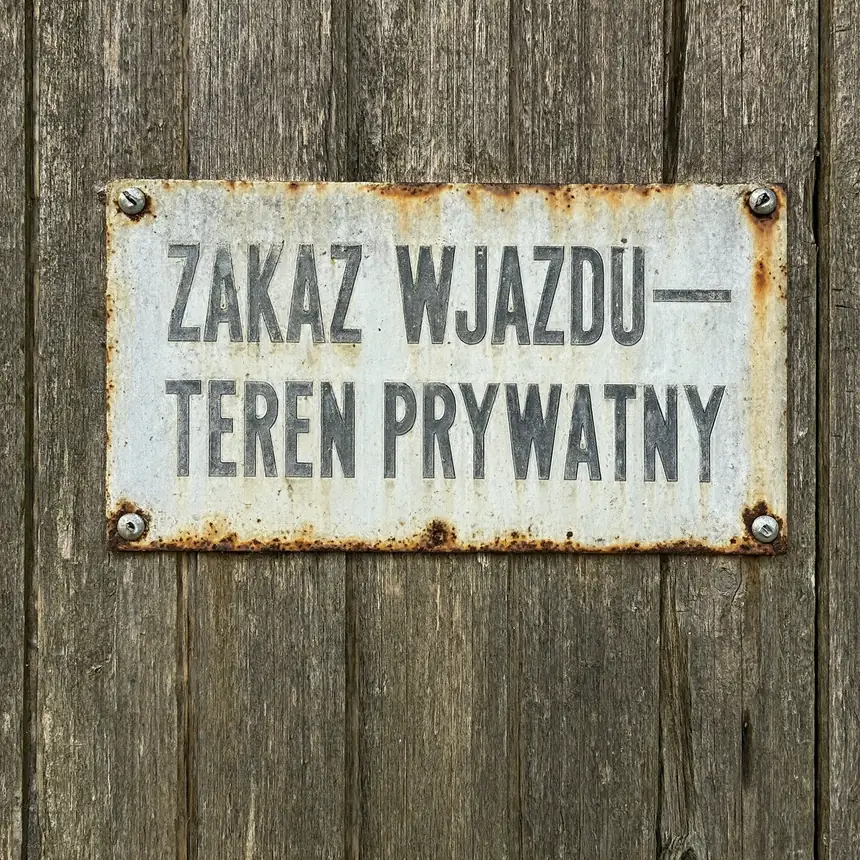
ZAKAZ WJAZDU - TEREN PRYWATNY, 29 znaków w dwóch wierszach, bez jednego błędu, razem z poprawnym myślnikiem.
Dwadzieścia dziewięć znaków w dwóch wierszach, z myślnikiem, w zwężonym kroju bezszeryfowym - bez jednej pomyłki. To jest test, który obala najprostsze wyjaśnienie („model się myli, bo napis jest długi”). Długość sama w sobie mu nie przeszkadza.
Gdzie to pękło
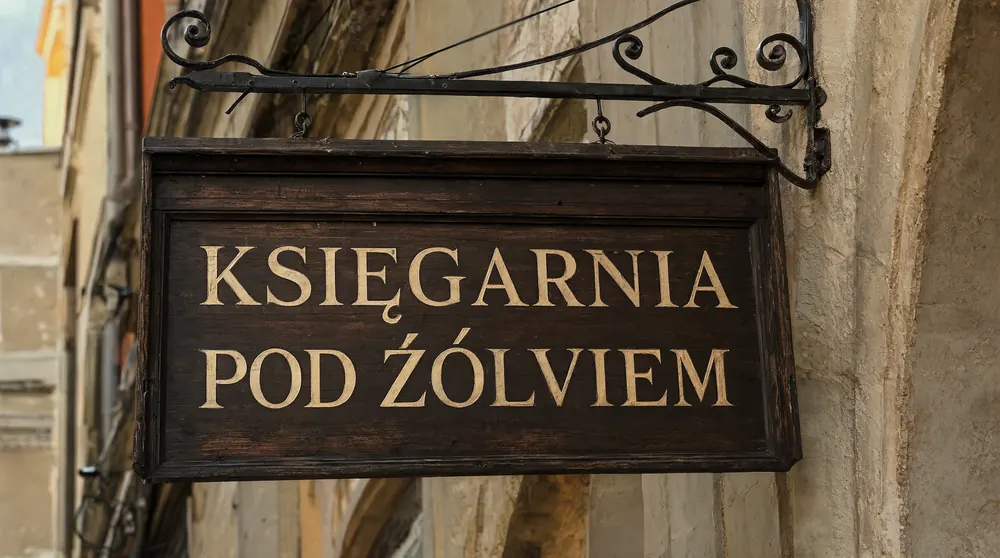
Szyld księgarni. Pierwszy wiersz idealny, w drugim Ż zamieniło się w Ź, a W w V - model podmienił litery, nie zgubił ogonków.
Pierwszy wiersz - „KSIĘGARNIA” - jest bez zarzutu, razem z Ę. Drugi miał brzmieć „POD ŻÓŁWIEM”, a wyszło „POD ŹÓLVIEM”. Trzy podmiany:
- Ż → Ź - kropka zamieniona na kreskę. Model wiedział, że nad literą coś ma być, ale wstawił nie ten znak.
- Ł → L - zgubiona kreska.
- W → V - i to jest najciekawsze, bo to nie ma nic wspólnego z ogonkami.
Podobnie w piekarni: „ŚWIEŻE” i „PIECZYWO” idealnie, ale „CODZIENNIE” wyszło jako „CODZIANNIE” - jedna samogłoska podmieniona, zero problemów z diakrytyką.
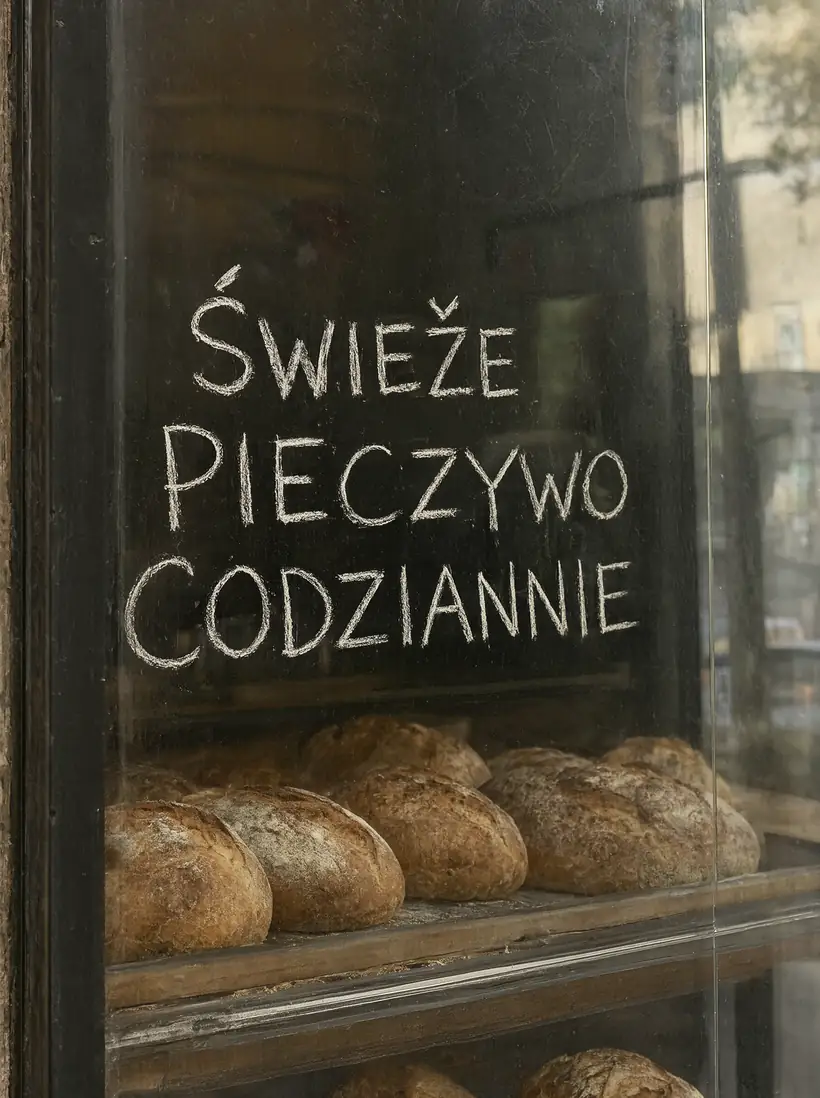
Kredowa tablica w piekarni. Ś i Ż poprawne, ale w trzecim wyrazie E zamieniło się w A.
Co z tego wynika - i to jest praktyczne
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Ogonki są dla tego modelu łatwiejsze niż rzadkie ciągi liter. W czterech na pięć testów wszystkie znaki diakrytyczne wyszły poprawnie. Błędy, które się pojawiły, to podmiany liter w wyrazach, których model widział w treningu mało: „żółwiem” i „codziennie” to nie są słowa z angielskiego internetu.
To jest mój wniosek z pięciu prób, nie twarde prawo: model radzi sobie z kształtem polskiej litery, bo to zadanie graficzne. Gorzej radzi sobie z zapamiętaniem dokładnej kolejności liter w długim, obcym dla siebie wyrazie - i wtedy podstawia literę wizualnie podobną.
Pięć zasad, które podnoszą skuteczność
- Trzymaj napis krótko. Do dwudziestu znaków w jednym bloku wychodzi niemal zawsze. Powyżej rośnie ryzyko podmiany litery.
- Dziel na wiersze. Dwa krótkie wiersze są bezpieczniejsze niż jeden długi - widać to po tabliczce z zakazem wjazdu.
- Pisz w poleceniu „reads exactly” i napis w cudzysłowie. Tak zbudowane były wszystkie moje testy.
- Sprawdzaj litery, nie ogonki. Odruchowo patrzysz na kreski nad literami, a błąd siedzi gdzie indziej. Przeczytaj napis głoska po głosce.
- Powtórz z innym ziarnem, zanim zmienisz polecenie. Przy 44 sekundach na obraz trzy podejścia to dwie minuty i zwykle jedno z nich jest czyste.
Czym to się różni od innych modeli
To jest opinia oparta na tych pięciu próbach, nie na porównaniu ich wszystkich w tych samych warunkach: poziom, na którym trzy z pięciu polskich napisów wychodzą bezbłędnie za pierwszym razem, jeszcze rok temu był nieosiągalny dla modeli otwartych. Producent wymienia poprawioną typografię jako jedną z czterech głównych zmian w tym wydaniu i akurat to widać.
Warto pamiętać o dwóch rzeczach z innych tekstów: model ma licencję niekomercyjną, a całość stawia się u siebie w godzinę.
Najczęstsze pytania
Czy Qwen-Image-2.1 pisze po polsku z ogonkami?
Tak. W moim teście cztery z pięciu napisów miały wszystkie znaki diakrytyczne poprawne, w tym „ŻÓŁĆ” z kompletem czterech.
Jak długi napis wychodzi bez błędu?
Do dwudziestu kilku znaków bardzo często. Najdłuższy bezbłędny w moim teście miał 29 znaków w dwóch wierszach.
Jakie błędy popełnia najczęściej?
Podmienia litery na wizualnie podobne: W na V, E na A, Ż na Ź. Rzadziej gubi sam ogonek.
Jak formułować polecenie z napisem?
Podaj napis w cudzysłowie i dopisz, że ma być odwzorowany dokładnie. Krótkie bloki i podział na wiersze pomagają bardziej niż dłuższy opis.
Czy da się to poprawić bez zmiany polecenia?
Zwykle tak - wystarczy powtórzyć z innym ziarnem. Przy 44 sekundach na obraz to tańsze niż przepisywanie polecenia.
Źródła i data sprawdzenia
Wszystkie obrazy w tym tekście wygenerowałem sam 22 września 2026 na RTX 4090, lokalnie, modelem Qwen-Image-2.1 w wariancie int8 przez ComfyUI: 25 kroków, próbnik euler, cfg 1.0, jedno ziarno dla całej serii, bez powtórek i bez retuszu. Ocena poprawności to mój odczyt napisów z wygenerowanych plików. Pięć prób to za mało na twarde wnioski statystyczne - traktuj tabelę jako wynik konkretnego testu, nie jako pomiar zdolności modelu. Opis zmian w wydaniu pochodzi z ogłoszenia producenta na qwen.ai.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Najczęstsze pytania
Czy Qwen-Image-2.1 poprawnie generuje polskie litery z ogonkami?
Tak, w 4 z 5 testów wszystkie znaki diakrytyczne wyszły poprawnie, w tym najtrudniejsze słowo ŻÓŁĆ z czterema różnymi ogonkami. Problemy pojawiły się wyłącznie przy rzadkich, długich wyrazach takich jak ŻÓŁWIEM i CODZIENNIE.
Jakie błędy robi Qwen-Image-2.1 przy polskich napisach?
Model podmienia całe litery na wizualnie podobne - W na V, E na A, Ż na Ź - a nie gubi ogonków. To inny rodzaj błędu niż powszechnie oczekiwany, bo model radzi sobie z kształtem polskiej litery jako zadaniem graficznym, ale myli kolejność liter w słowach rzadko spotykanych w anglojęzycznym internecie.
Jak sformułować polecenie, żeby Qwen-Image-2.1 poprawnie napisał polski tekst?
Należy podać napis w cudzysłowie z dopiskiem, że ma być odwzorowany dokładnie - tak zbudowane były wszystkie testy opisane w artykule. Podział na krótkie wiersze i ograniczenie jednego bloku do około 20 znaków dodatkowo zmniejsza ryzyko błędu.
Czy można poprawić błędny napis bez zmiany polecenia w Qwen-Image-2.1?
Tak, wystarczy powtórzyć generowanie z innym ziarnem. Przy czasie 44 sekund na obraz trzy podejścia zajmują około dwóch minut i zwykle jedno z nich jest bezbłędne.
Podobne tematy na Promptowym