Llama recenzja: tanie otwarte wagi, które Meta sama odstawiła na bok
Llama 4 Maverick zdobyła w moim teście pisania po polsku 62,9 pkt na 100, mniej niż GLM-5.3 i Mistral, choć 9 zadań kosztowało tylko 0,0019 USD. Od kwietnia 2025 roku Meta nie wydała nowej Llamy: czat Meta AI napędza dziś zamknięty Muse Spark, llama.com przekierowuje na stronę Muse, a Llama API wygaszono 6 lipca 2026. Do tego licencja Llamy 4 nie daje praw do modeli multimodalnych firmom i osobom z UE.
Plusy
- Wagi do pobrania za darmo, na własny serwer, bez wysyłania danych do Mety
- Bardzo tanie API: 9 zadań pisarskich kosztowało 0,0019 USD, Maverick od 0,1875 / 0,6525 USD za milion tokenów
- Okno 10 mln tokenów w Scout i 1 mln w Maverick
- Obraz na wejściu (tekst i obraz), architektura MoE z 17 mld aktywnych parametrów
- Łatwa korekta prawie bezbłędna: 21 z 22 poprawek w Maverick
Minusy
- 62,9 pkt w pisaniu po polsku, poniżej GLM-5.3 (64,4) i Mistrala (68,0)
- Błędy odmiany i kalki: „ze stal nierdzewną”, „wybór odkurzacz bezworkowy”, „przysługa w niełasce”
- Polski nie jest na liście 12 obsługiwanych języków Llamy 4
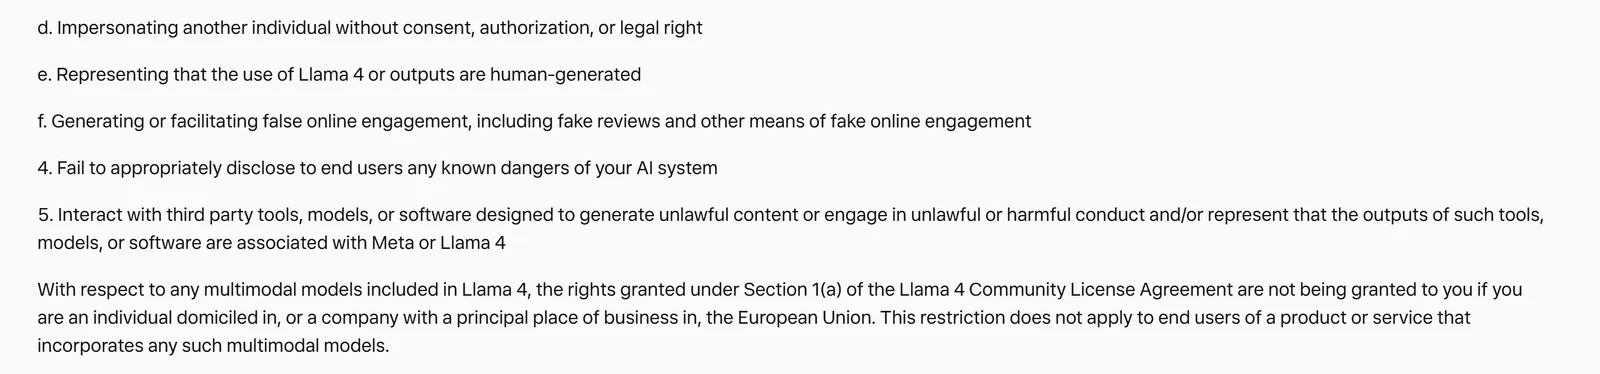
- Zapis w polityce użycia: brak praw do multimodalnych Llam 4 dla firm i osób z UE
- Meta nie rozwija już Llamy: brak nowej wersji od 5.04.2025, Llama API wyłączone 6.07.2026
- Wiedza tylko do sierpnia 2024 roku i brak trybu rozumowania
Dla kogo
- Zespoły, które mają już produkt na Llamie i nie chcą na razie migrować
- Programiści, którzy potrzebują najtańszego API do prostych zadań po angielsku: Scout od 0,10 / 0,30 USD za milion tokenów
- Kto potrzebuje bardzo długiego kontekstu w otwartym modelu: 10 mln tokenów w Llama 4 Scout
- Badacze i firmy spoza UE, które chcą modelu z otwartymi wagami na własnym serwerze
Nie dla kogo
- Kto pisze po polsku: 62,9 pkt wobec 74,1 u DeepSeek V4 Pro i 86,4 u GPT-6 Sol
- Polskie firmy, które chcą same uruchamiać Llamę 4: polityka użycia wyłącza prawa dla firm z siedzibą w UE przy modelach multimodalnych
- Kto chce uruchomić model na zwykłej karcie graficznej: Scout ma 109 mld parametrów i według Mety mieści się na jednym H100 po kwantyzacji int4
- Kto potrzebuje aktualnej wiedzy: dane treningowe kończą się w sierpniu 2024 roku
Llama recenzja: co zostało z Llamy we wrześniu 2026
Llama to rodzina modeli językowych Mety z otwartymi wagami, które każdy może pobrać i uruchomić na własnym serwerze. Przez dwa lata była najważniejszym otwartym modelem na świecie: w marcu 2025 roku Mark Zuckerberg ogłosił miliard pobrań, a w kwietniu Meta mówiła już o 1,2 mld. Na Llamie powstało też sporo polskich projektów, m.in. pierwsza generacja rządowego PLLuM.
Najnowsza wersja to wciąż Llama 4 z 5 kwietnia 2025 roku, w dwóch wariantach: Scout (17 mld aktywnych parametrów, 109 mld łącznie, 16 ekspertów, 10 mln tokenów kontekstu) i Maverick (17 mld aktywnych, 400 mld łącznie, 128 ekspertów, 1 mln tokenów). Oba przyjmują tekst i obraz, a odpowiadają tekstem.
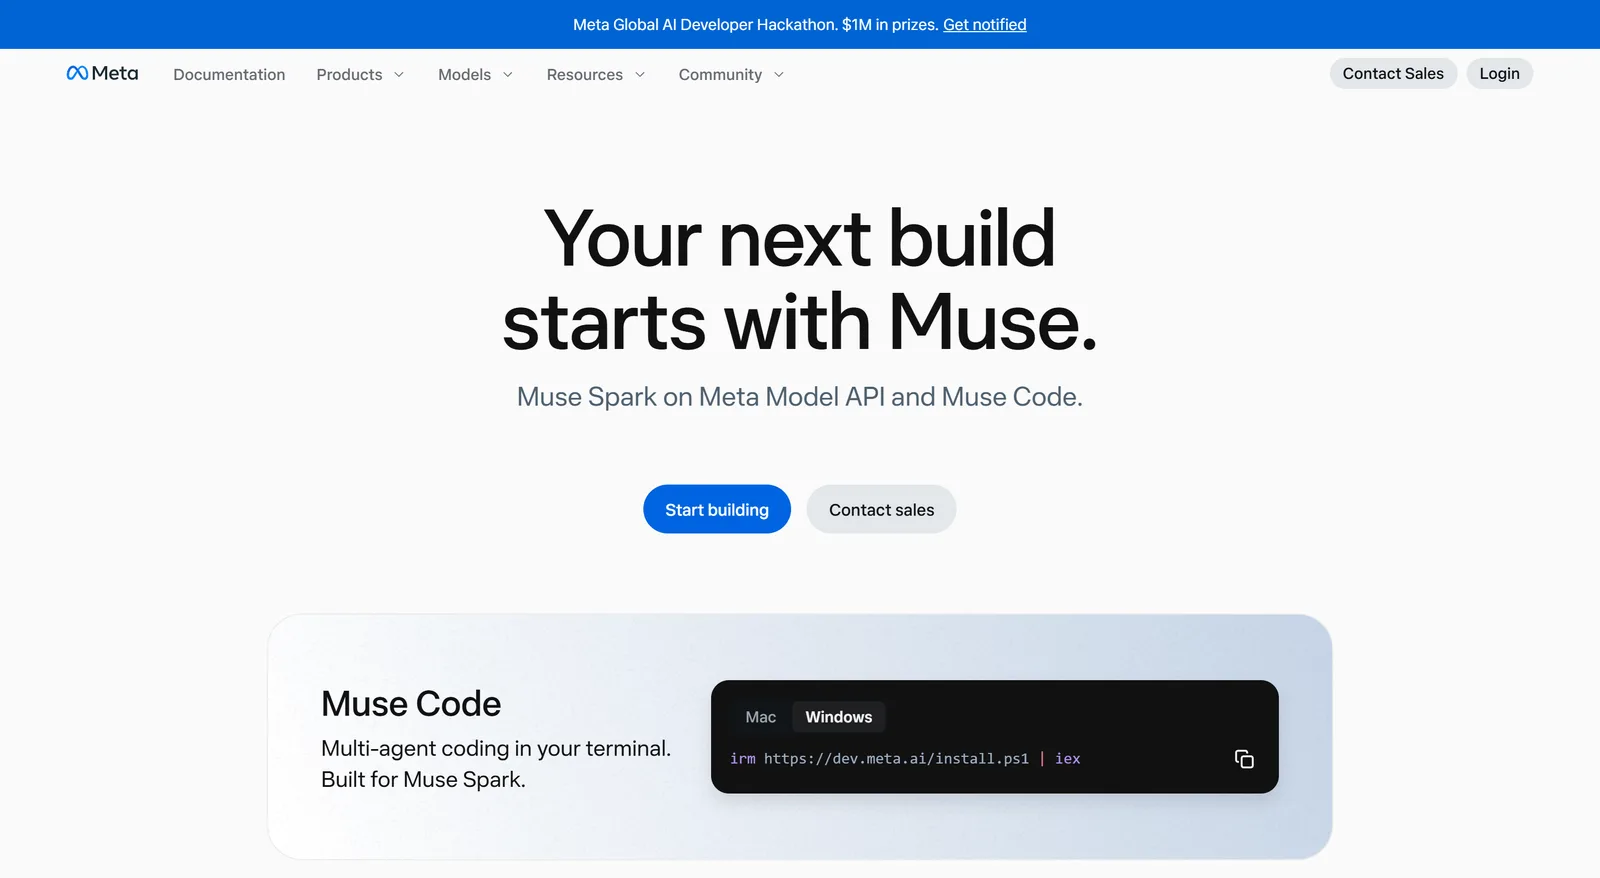
Od tamtej pory Meta nie wydała nowej Llamy. W kwietniu 2026 roku przedstawiła zamknięty model Muse Spark z nowego laboratorium Meta Superintelligence Labs, który napędza aplikację i stronę Meta AI. W lipcu wygaszono Llama API, a adres llama.com przekierowuje dziś na dev.meta.ai z hasłem „Your next build starts with Muse”. Otwarte wagi Meta wydała w sierpniu, ale już pod nową marką: Muse Glimmer 30B.
W tej recenzji oceniam więc Llamę 4 jako model, który możesz dziś pobrać albo wywołać przez API u pośredników. Aplikację Meta AI opisuję osobno, bo według Mety działa już na Muse Spark.
Llama 4 po polsku: mój test w Laboratorium
Llama 4 Maverick, Llama 4 Scout i dla porównania Muse Glimmer 30B przeszły 30 września przez te same 13 zadań co reszta mojego rankingu AI do pisania po polsku, na tych samych ustawieniach i limitach. Metodę opisałem w Laboratorium Promptowym.
Maverick zdobył 62,9 pkt na 100. Z 16 modeli rankingu niżej jest tylko Claude Haiku 4.5 (59,2). GLM-5.3 ma 64,4, Mistral Medium 3.5 68,0, a DeepSeek V4 Pro 74,1. Scout wypadł jeszcze słabiej, 57,9 pkt, najniżej w całym zestawieniu. Średnia ocen sędziów dla Mavericka to 5,59 na 10, a za naturalność tylko 4,63. Sędziowie powtarzali to samo: szablonowy styl, frazesy, kalki z angielskiego i teksty wyraźnie krótsze, niż kazało polecenie.
Najgorzej wypadł opis czajnika (4,22) z błędem „łączące nowoczesny design ze stal nierdzewną” i dopisanym „designem”, którego nie było w karcie produktu. W tytułach SEO Maverick dwa razy wstawił niegramatyczne „wybór odkurzacz bezworkowy”, a w przekładzie newslettera zamienił idiom na „przysługę w niełasce” i zostawił „follow-up” oraz „kickoff call” po angielsku. Post na LinkedIn zaczyna się od cudzysłowu i kończy zdaniem „jestem podekscytowany tym, co przyszłość przyniesie dla mojego sklepu”.
Lepiej wyszły zadania z twardą odpowiedzią. Łatwą korektę Maverick zrobił w 21 z 22 miejsc, a łatwy quiz o Polsce w 45 z 46. W trudnej korekcie poprawił tylko 20 z 30 błędów: przepuścił „cofnąć się do tyłu”, „powtórzył ponownie” i pomylone „bynajmniej”. W trudnym quizie uznał Wisłę za drugą co do długości rzekę Polski, podał 10 lat przedawnienia zamiast 6 i dał się złapać w pułapkę o „pierwszym prezydencie II RP wybranym w wyborach powszechnych”.
Scout dopisał do posta na LinkedIn chiński znak w środku polskiego słowa, a w quizach pomylił autorów „Lalki” (Fredro) i „Przedwiośnia” oraz wymyślił malarza „Bitwy pod Grunwaldem”, Mateusza Wietyszę. W obu quizach zdobył 68 z 94 punktów, a Maverick 88.
Mój test: Llama 4 po polsku w Laboratorium Promptowego
30.09.2026 przepuściłem Llama 4 Maverick, Llama 4 Scout i Muse Glimmer 30B przez te same 13 zadań co 16 modeli w rankingu: 9 zadań pisarskich, dwie korekty i dwa quizy o Polsce, przez OpenRouter, z tymi samymi limitami. Teksty ocenili w ciemno trzej sędziowie (Claude Opus 5.5, GPT-6 Sol, Gemini 3.1 Pro), a w puli były cztery kotwice z pierwszej rundy; ich wyniki różniły się od tamtych o 0-3 pkt, kolejność się nie zmieniła, a wyniki Llam przesunąłem o -1,1 pkt do skali rankingu.
| Zadanie | Llama 4 Maverick | Uwagi |
|---|---|---|
| Pisanie po polsku, 9 zadań | 62,9 pkt (surowo 64,0) | sędziowie 5,59 / 10: poprawność 7,11, naturalność 4,63, wykonanie 5,04; Scout 57,9, Glimmer 60,4 |
| Reguły z poleceń | 21 z 26 | za krótkie artykuł, opis, post i opowiadanie |
| Koszt 9 zadań pisarskich | 0,0019 USD | Mistral Medium 3.5: 0,4394 USD, GPT-6 Luna: 0,002 USD |
| Czas 9 zadań pisarskich | 211,2 s | przez OpenRouter (DigitalOcean i DeepInfra); Scout 70,3 s |
| Opis produktu | 4,22 / 10 | „ze stal nierdzewną”, dopisany „nowoczesny design” |
| Tytuły SEO | 5,22 / 10 | dwa razy „wybór odkurzacz bezworkowy”, wszystko małymi literami |
| Tłumaczenie newslettera | 5,00 / 10 | „przysługa w niełasce”, zostawione „follow-up” i „kickoff call” |
| Łatwa korekta | 21 z 22 | przepuścił błąd we frazeologizmie „w każdym razie” |
| Trudna korekta | 20 z 30 | zostawił „cofnąć się do tyłu”, „powtórzył ponownie” i pomylone „bynajmniej” |
| Quiz o Polsce, łatwy | 45 z 46 | największy park narodowy: Bieszczadzki zamiast Biebrzańskiego |
| Quiz o Polsce, trudny | 43 z 48 | druga rzeka to „Wisła”, przedawnienie 10 lat, pułapka z prezydentem; 2 odpowiedzi „3” bez jednostki odrzucone automatycznie |
| Llama 4 Scout, oba quizy | 68 z 94 | „Lalkę” napisał Fredro, „Przedwiośnie” Szczepan Szuman, „Bitwę pod Grunwaldem” Mateusz Wietysza |
Dlaczego Llama słabo pisze po polsku
Meta podaje w karcie modelu 12 obsługiwanych języków Llamy 4: arabski, angielski, francuski, niemiecki, hindi, indonezyjski, włoski, portugalski, hiszpański, tagalog, tajski i wietnamski. Polskiego na liście nie ma. Meta pisze, że w pretreningu było 200 języków, ale użycie w innych językach niż te 12 wymienia jako wykraczające poza zamierzone zastosowania, chyba że model dostroisz sam.
Drugi powód to wiek. Dane treningowe Llamy 4 kończą się w sierpniu 2024 roku, a model nie ma trybu rozumowania. Nowsze modele o podobnej cenie, jak DeepSeek V4.1 Flash czy GPT-6 Luna, piszą po polsku o 10-20 pkt lepiej. Muse Glimmer 30B, następca z otwartymi wagami, deklaruje ponad 100 języków, ale w moim teście dostał 60,4 pkt, niewiele więcej niż Scout. Poprawił za to trudną korektę (26 z 30).
To moja opinia: Llama była dobrym punktem wyjścia do dostrajania polskich modeli, ale jako gotowy model do polskich tekstów w 2026 roku już się nie broni.
Licencja Llamy i Unia Europejska: haczyk dla polskich firm
Llama 4 nie jest open source w ścisłym sensie. Działa na licencji Llama 4 Community License z trzema ważnymi warunkami:
- Limit 700 mln użytkowników. Jeśli twoje usługi miały w dniu premiery ponad 700 mln aktywnych użytkowników miesięcznie, musisz poprosić Metę o osobną licencję.
- Oznaczenie. Produkt z Llamą musi mieć widoczny dopisek „Built with Llama” i kopię licencji.
- Wyłączenie UE. W polityce dopuszczalnego użycia Meta pisze, że przy multimodalnych modelach Llamy 4 prawa z licencji nie są przyznawane osobom mieszkającym w UE ani firmom z główną siedzibą w UE. Zapis nie dotyczy użytkowników końcowych gotowego produktu z takim modelem.
Scout i Maverick są multimodalne, bo przyjmują obraz. W praktyce oznacza to, że polska firma, która chce sama pobrać Llamę 4 i wbudować ją w swój produkt, działa bez praw z licencji, a korzystanie z gotowej usługi z Llamą jest dozwolone. Nie jestem prawnikiem, więc to moje odczytanie tekstu polityki, a nie porada prawna.
Muse Glimmer 30B ma pod tym względem przewagę: jest na licencji Apache 2.0, bez limitu użytkowników i bez zapisu o UE.
Gdzie uruchomić Llamę w 2026 roku i ile to kosztuje
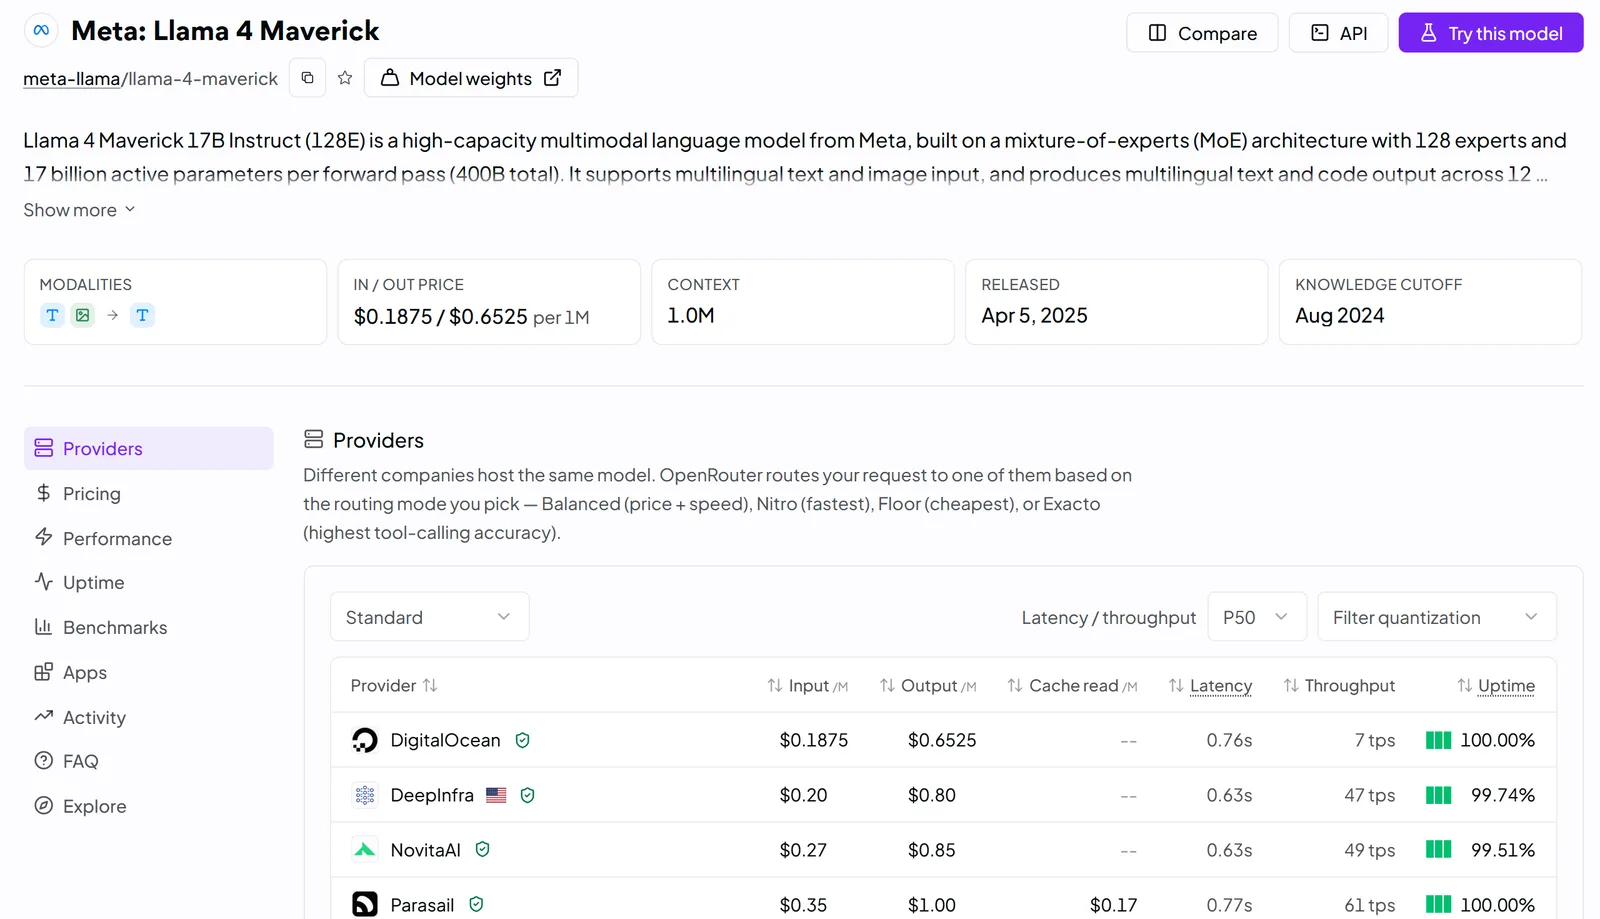
Przez API u pośredników. Meta wygasiła publiczny podgląd Llama API 6 lipca 2026 roku. Modele wciąż są u dostawców: w OpenRouterze Maverick kosztuje od 0,1875 USD za milion tokenów wejścia i 0,6525 USD wyjścia, a Scout od 0,10 / 0,30 USD. Część platform już się wycofuje: Groq wyłączył Mavericka 9 marca, a Scouta 17 lipca 2026 roku i poleca w zamian GPT-OSS 120B albo Qwen 3.6. W moim teście 9 zadań pisarskich na Mavericku kosztowało 0,0019 USD, czyli tyle co w GPT-6 Luna (0,002 USD), która pisze po polsku o 20 pkt lepiej.
Na własnym sprzęcie. Wagi pobierzesz za darmo, ale Llama 4 nie jest modelem na domowy komputer. Scout ma 109 mld parametrów i według Mety mieści się na jednej karcie H100 z 80 GB po kwantyzacji int4. Maverick w wersji FP8 potrzebuje całego serwera DGX z H100. Na mojej karcie RTX 4090 z 24 GB żadna Llama 4 się nie zmieści. Do lokalnej pracy po polsku lepsze są mniejsze modele z mojego testu lokalnych modeli na RTX 4090, np. Gemma 4 12B (72,3 pkt) czy Bielik, albo Muse Glimmer 30B, który według Mety mieści się w 24 GB.
W czacie. Nie ma oficjalnego czatu z Llamą 4. Meta AI, jedyny czat Mety, według firmy działa od kwietnia 2026 roku na Muse Spark.
Czy to się opłaca? To moja opinia: własny serwer ma sens tylko przy dużej skali i wymaganiu, żeby dane nie wychodziły z firmy. Przy małym ruchu API u pośrednika kosztuje ułamki centa, a przy dużym lepiej porównać koszt własnego GPU z tańszymi, nowszymi modelami. Jak to policzyć, pokazuję w tekście lokalny model czy API.
Prywatność i dane
Największa zaleta Llamy to możliwość uruchomienia jej u siebie. Wtedy teksty nie trafiają ani do Mety, ani do żadnego pośrednika. Przy API wszystko zależy od dostawcy: w OpenRouterze Mavericka obsługują m.in. DigitalOcean, DeepInfra, Novita, Parasail i Google Vertex, każdy na własnych zasadach przechowywania danych.
Dobrze też wiedzieć, na czym Llama się uczyła. Według karty modelu dane treningowe Llamy 4 obejmują publicznie udostępnione posty z Instagrama i Facebooka oraz rozmowy ludzi z Meta AI. Obniżam ocenę prywatności za zapis o UE w polityce użycia, bo właśnie firmom z Unii utrudnia uruchomienie modelu na własnym sprzęcie, czyli wariant najlepszy dla danych.
Muse Spark, Muse Glimmer i Meta AI: co zastąpiło Llamę
Muse Spark to zamknięty model Mety z 8 kwietnia 2026 roku, dziś w wersji 1.3. W moim teście po polsku dostał 75,5 pkt (75,3 w skali rankingu), czyli o 12,4 pkt więcej niż Llama 4 Maverick, ale wagi są zamknięte, a API kosztuje 1,25 / 4,25 USD za milion tokenów. Szczegóły są w tekście Muse Spark 1.3 od Mety.
Muse Glimmer 30B z 10 sierpnia 2026 roku to pierwszy otwarty model Mety od czasu Llamy 4: gęsty, 29,6 mld parametrów, kontekst ponad 131 tys. tokenów, wiedza do stycznia 2026 roku, licencja Apache 2.0. Meta pisze, że po kwantyzacji do około 4 bitów model językowy zajmuje mniej niż 20 GB i działa na karcie z 24 GB. W moim teście po polsku: 60,4 pkt, między Maverickiem a Scoutem.
Meta AI działa w Polsce od marca 2025 roku w WhatsAppie, Messengerze, Instagramie i na Facebooku, a po polsku mówi od listopada 2025 roku, kiedy do Polski trafiła też osobna aplikacja. Jest bezpłatna. Nie testowałem jej w tej recenzji, a Meta nie podaje, czy wersja dla UE działa już na Muse Spark. Aplikacja agenta Muse, którą Meta wypuściła we wrześniu, według doniesień prasowych działa tylko w USA i Kanadzie. Więcej w tekście Meta AI: co to jest i gdzie działa.
Czy warto wybrać Llamę? Opinia i alternatywy
Dla większości czytelników: nie. Do pisania po polsku przez API lepsze i podobnie tanie są DeepSeek (74,1 pkt) i GPT-6 Luna (82,8 pkt). Jeśli ważne są otwarte wagi, weź Qwena, DeepSeeka na licencji MIT albo Mistrala z Europy. Do pracy lokalnej po polsku sprawdź Bielika albo Gemmę 4.
Llama 4 ma sens, gdy masz już na niej produkt, potrzebujesz okna 10 mln tokenów w otwartym modelu albo robisz badania na znanym, dobrze opisanym modelu. To moja opinia: Meta sama przesunęła Llamę na boczny tor, więc nie budowałbym na niej nowego projektu w 2026 roku. O tym, dlaczego Meta w ogóle rozdawała Llamę za darmo, pisałem w tekście o Marku Zuckerbergu.
Llama: ceny i plany
| Plan | Cena | Co dostajesz |
|---|---|---|
| Wagi Llama 4 (Hugging Face, dev.meta.ai) | 0 zł | na licencji Llama 4 Community License; sprzęt i prąd po twojej stronie |
| Llama 4 Scout przez OpenRouter | 0,10 / 0,30 USD | za 1 mln tokenów wejścia / wyjścia, najtańszy dostawca 30.09.2026 |
| Llama 4 Maverick przez OpenRouter | 0,1875 / 0,6525 USD | najtaniej DigitalOcean; DeepInfra 0,20 / 0,80 USD, Google Vertex 0,35 / 1,15 USD |
| Meta Llama API | wyłączone | publiczny podgląd wygaszony 6.07.2026 |
| Muse Glimmer 30B (następca otwarty) | 0 zł za wagi, API od 0,35 / 1,50 USD | licencja Apache 2.0, OpenRouter |
| Muse Spark 1.3 (następca zamknięty) | 1,25 / 4,25 USD | tylko API Mety i OpenRouter, wagi zamknięte |
| Meta AI (czat) | 0 zł | w WhatsAppie, Messengerze, Instagramie, na Facebooku i w aplikacji Meta AI |
Meta nie ma polskiego cennika, bo Llamy nie sprzedaje: wagi są bezpłatne. Ceny API w USD bez podatku z OpenRoutera (odczyt 30.09.2026), różne u różnych dostawców. Informacja o wygaszeniu Llama API za dokumentacją Promptfoo, bo strona komunikatu Mety już nie działa. Ceny Muse z tekstu o Muse Spark na Promptowym (27.09.2026). źródło
Llama a konkurencja
| Llama | Mistral | DeepSeek | Qwen | |
|---|---|---|---|---|
| Producent | Meta (USA) | Mistral AI (Francja) | DeepSeek (Chiny) | Alibaba (Chiny) |
| Model w teście | Llama 4 Maverick | Mistral Medium 3.5 | DeepSeek V4 Pro | Qwen 3.8 Max |
| Licencja otwartych wag | Llama 4 Community License, wyłączenie UE dla modeli multimodalnych | zmodyfikowana MIT | MIT | Max zamknięty, mniejsze modele otwarte |
| API za 1 mln tokenów (wej. / wyj.) | 0,1875 / 0,6525 USD | 1,5 / 7,5 USD | 0,30 / 1,20 USD (V4.1 Flash) | 2 / 6 USD |
| Okno kontekstu | 1 mln (Scout: 10 mln) | 256 tys. | 1 mln | 1 mln |
| Oficjalny czat po polsku | nie (Meta AI działa na Muse Spark) | tak | tak | nie |
| Pisanie po polsku (mój test) | 62,9 | 68,0 | 74,1 | 75,9 |
| Trudna korekta (na 30) | 20 | 29 | 29 | 30 |
| Quiz o Polsce (na 94, sprawdzanie automatyczne) | 88 | 91 | 94 | 94 |
| Najnowszy model producenta | Llama 4, 5.04.2025 | Medium 3.5, 29.04.2026 | V4.1 Flash, 10.09.2026 | Qwen3.8 Max, 2.09.2026 |
Ciekawostki
- Adres llama.com przekierowuje dziś na dev.meta.ai, gdzie pierwszy nagłówek brzmi „Your next build starts with Muse”, a o Llamie przypominają dopiero linki w stopce.
- Przy premierze Llamy 4 Meta chwaliła się 2. miejscem Mavericka w LMArenie, ale była to niepubliczna „eksperymentalna wersja czatowa”. Zwykły Maverick, oceniony później przez LMArenę, zajął 32. miejsce (TechCrunch).
- W marcu 2025 roku Llama przekroczyła miliard pobrań, a w kwietniu 1,2 mld. Półtora roku później Meta wyłączyła własne Llama API.
- Według karty modelu Llama 4 Scout uczyła się na około 40 bln tokenów, prawie dwa razy więcej niż większy Maverick (około 22 bln).
- Pierwszą generację polskiego PLLuM wytrenowano na około 150 mld tokenów polskiego tekstu na bazie architektur Llama i Mistral.
Llama 4 ma sens tylko w wąskich przypadkach: gdy masz już działające wdrożenie na Llamie, potrzebujesz bardzo taniego API do prostych zadań po angielsku albo okna 10 mln tokenów w Scout. Do pisania po polsku wybrałbym DeepSeek, Kimi albo Qwena, a do pracy na własnym komputerze Gemmę 4 lub Bielika. Polska firma, która chce sama uruchamiać Llamę 4, powinna najpierw przeczytać politykę użycia z prawnikiem, bo zapis o UE obejmuje modele multimodalne, a obie Llamy 4 są multimodalne. Jeśli zostajesz przy Mecie, sprawdź Muse Glimmer 30B na licencji Apache 2.0.
Najczęstsze pytania
Czy Llama jest za darmo?
Wagi Llamy 4 można pobrać bezpłatnie, ale trzeba mieć mocny sprzęt: Scout mieści się na jednej karcie H100 z 80 GB po kwantyzacji. Przez API u pośredników Llama kosztuje od 0,10 USD za milion tokenów wejścia.
Czy Llama działa po polsku?
Rozumie i pisze po polsku, ale słabo: w moim teście Llama 4 Maverick zdobyła 62,9 pkt na 100, a Scout 57,9. Polskiego nie ma na liście 12 języków, które Meta oficjalnie obsługuje w Llamie 4.
Czy mogę używać Llamy 4 w firmie w Polsce?
Polityka użycia Llamy 4 nie przyznaje praw do modeli multimodalnych firmom z główną siedzibą w UE ani osobom mieszkającym w UE, a obie Llamy 4 są multimodalne. Zapis nie dotyczy użytkowników końcowych gotowego produktu. Przed wdrożeniem skonsultuj to z prawnikiem.
Jaka jest najnowsza wersja Llamy?
Llama 4 Scout i Maverick z 5 kwietnia 2025 roku. Od tamtej pory Meta nie wydała nowej Llamy: jej nowe modele to zamknięty Muse Spark i otwarty Muse Glimmer 30B.
Czy Meta AI to Llama?
Już nie. Według Mety od kwietnia 2026 roku aplikację i stronę Meta AI napędza Muse Spark. Meta nie podała, czy dotyczy to także wersji w Unii Europejskiej.
Czy Llama 4 zadziała na moim komputerze?
Raczej nie. Scout ma 109 mld parametrów, a Maverick 400 mld, więc nie zmieszczą się na karcie z 24 GB. Do pracy lokalnej lepsza jest Gemma 4 12B, Bielik albo Muse Glimmer 30B.
Llama czy Mistral: co wybrać?
Do pisania po polsku Mistral: 68,0 pkt wobec 62,9 w moim teście. Llama jest za to kilka razy tańsza w API (0,1875 / 0,6525 USD wobec 1,5 / 7,5 USD), a Mistral nie ma zapisu wyłączającego firmy z UE.
Źródła
- Meta: karta modelu Llama 4 (GitHub meta-llama/llama-models)github.com
- OpenRouter: Llama 4 Maverick, ceny i dostawcy (odczyt 30.09.2026)openrouter.ai
- Meta: Llama 4 Community Licensellama.com
- Meta: Llama 4 Acceptable Use Policy (zapis o UE)llama.com
- Promptfoo: Meta Llama API wycofane 6.07.2026promptfoo.dev
- Groq: wycofane modele (Llama 4 Maverick i Scout)console.groq.com
- Meta: Introducing Muse Spark (8.04.2026)about.fb.com
- Hugging Face: meta-models/Muse-Glimmer-30B (karta modelu)huggingface.co
- Meta: Europe, Meet Your Newest Assistant: Meta AI (marzec 2025)about.fb.com
- Telepolis: Meta AI po polsku (12.11.2025)telepolis.pl
- Meta: Celebrating 1 Billion Downloads of Llama (marzec 2025)about.fb.com
- TechCrunch: Meta's vanilla Maverick ranks below rivals (11.04.2025)techcrunch.com
- Promptowy: Ranking AI do pisania po polsku, 16 modelipromptowy.com
- Promptowy: Laboratorium Promptowe, metoda testupromptowy.com
- Promptowy: Muse Spark 1.3 od Mety, test po polskupromptowy.com
- Promptowy: 7 lokalnych modeli AI po polsku na RTX 4090promptowy.com
- Promptowy: PLLuM, polski model językowy państwapromptowy.com
Sprawdzone 30.09.2026. Ceny i limity zmieniają się często, dlatego przy każdej aktualizacji sprawdzam je u źródła.
Historia zmian
- Pełna recenzja od nowa: test Llama 4 Maverick, Scout i Muse Glimmer 30B w Laboratorium Promptowym, licencja i zapis o UE, wygaszenie Llama API, następcy Muse Spark i Muse Glimmer, ceny API, zrzuty i porównanie z Mistralem, DeepSeekiem i Qwenem.