InfiniteTalk w ComfyUI na RTX 4090: instalacja, ustawienia i błędy
Lokalny lip-sync polskiej piosenki zajął 1284 s dla klipu 20 s. Opisuję zestaw modeli, poprawki środowiska i próbę InfiniteTalk V2V na gotowym materiale.
👁 115 przeczytań
- InfiniteTalk na RTX 4090 z 20-sekundowym klipem polskiej piosenki obliczał się 1284 sekundy, czyli ponad 21 minut, przy użyciu WanVideoWrapper, bazy Wan 2.1 I2V 14B fp8 i 6 kroków.
- Kluczowe poprawki środowiska to naprawa hidden_states w wav2vec dla transformers 5.17, ustawienie merge_loras=False na Windowsie oraz kompatybilność torchaudio 2.11 nightly z torch 2.14 cu132.
- Wynik 832x480 przy 25 kl./s wykazał korelację lip-sync 0,471 dla pierwszych 15 sekund i wzrost do 0,366 po V2V przy 2 z 4 kroków z audio_scale równym 1,5.
Sprawdziłem InfiniteTalk w ComfyUI na RTX 4090 z fragmentem polskiej piosenki. Lokalny klip miał 20 s, a obliczenia trwały 1284 s, czyli ponad 21 minut. Po drodze pojawiły się problemy z transformers, torchaudio i scalaniem LoRA. Opisuję sprawdzony wariant oraz pliki potrzebne do jego złożenia, oddzielając zapis testu od proponowanych ustawień pamięci.
W skrócie
Użyłem WanVideoWrapper, bazy Wan 2.1 I2V 14B fp8, InfiniteTalk i lightx2v przy 6 krokach. Wynik 832×480 przy 25 kl./s dał korelację lip-sync 0,471 dla pierwszych 15 s. Najważniejsze poprawki środowiska dotyczyły hidden_states w wav2vec, zgodności torchaudio z torch oraz ustawienia merge_loras=False. To działający przypadek na tej karcie, bez gwarancji identycznego czasu w innym środowisku.
Co właściwie instaluję w ComfyUI
InfiniteTalk wykorzystałem przez ComfyUI-WanVideoWrapper. Ten dodatek łączy ładowanie modelu wideo, modułu InfiniteTalk i reprezentacji audio. Bazą opisanego wariantu jest Wan 2.1 I2V, dlatego nie podmieniam jej dowolnie na nowszą rodzinę Wan. Wspólna nazwa producenta nie oznacza zgodności wszystkich wag i węzłów.
Przy składaniu instalacji umieszczam repozytorium wrappera w katalogu custom_nodes używanej instalacji ComfyUI. Zależności z jego requirements.txt instaluję interpreterem przypisanym do tego samego ComfyUI. Unikam instalowania pakietów przypadkowym systemowym pipem, ponieważ wtedy biblioteka może istnieć na komputerze, a nadal pozostawać niewidoczna dla aplikacji.
Po instalacji dodatku i ponownym uruchomieniu ComfyUI wczytuję przykładowy workflow InfiniteTalk. Sprawdzam brakujące węzły przed pobieraniem kolejnych checkpointów. Przykład z dokumentacji korzysta z innego wariantu wag, więc dla fp8 trzeba świadomie dobrać loader i pliki. Samo przemianowanie checkpointu nie wykonuje konwersji.
Modele fp8 i rozmiary plików
Poniżej zestawiam wariant opisany w karcie narzędzia. Rozmiary pochodzą z zapisanych metadanych Hugging Face, a nie z pomiaru obciążenia karty. GB są dziesiętne. Nie sumuję tych wartości jako zapotrzebowania na VRAM, bo offload, bufory i kolejność wykonywania węzłów zmieniają wykorzystanie pamięci podczas pracy.
| Rola | Plik | Rozmiar |
|---|---|---|
| Baza wideo | Wan2_1-I2V-14B-480p_fp8_e4m3fn_scaled_KJ.safetensors | 16,643 GB |
| Moduł InfiniteTalk | Wan2_1-InfiniteTalk-Single_fp8_e4m3fn_scaled_KJ.safetensors | 2,714 GB |
| Encoder tekstu | umt5-xxl-enc-fp8_e4m3fn.safetensors | 6,731 GB |
| VAE | Wan2_1_VAE_bf16.safetensors | 0,254 GB |
| Encoder audio | wav2vec2-chinese-base_fp16.safetensors | 0,190 GB |
| CLIP Vision | clip_vision_h.safetensors | 1,264 GB |
Bazę i moduł InfiniteTalk przypisuję do models\diffusion_models, encoder tekstu do models\text_encoders, VAE do models\vae, a CLIP Vision do models\clip_vision. Położenie wav2vec ustalam zgodnie z loaderem audio. Nie wkładam go do katalogu tekstowego encodera tylko dlatego, że oba komponenty przetwarzają wejściowe dane.
W workflowie sprawdzam obecność WanVideoModelLoader, MultiTalkModelLoader, Wav2VecModelLoader, MultiTalkWav2VecEmbeds, WanVideoImageToVideoMultiTalk, WanVideoSampler i WanVideoVAELoader. Pełny checkpoint z natywnej ścieżki InfiniteTalk nie jest automatycznie zamiennikiem małego modułu ładowanego przez MultiTalkModelLoader. Różnice między formatami sprawdzam przed uruchomieniem grafu.
Lightx2v, wokal i czas na RTX 4090
W zarejestrowanej próbie zastosowałem lightx2v i 6 kroków. Nie przedstawiam tej liczby jako uniwersalnego ustawienia dla gołej bazy Wan. Skrócony sampling należy rozpatrywać razem z odpowiednim dodatkiem i konfiguracją. Raport nie zawiera pełnej nazwy pliku użytej LoRA, więc nie dopisuję konkretnego checkpointu jako pewnego elementu odtworzenia.
Do porównania wybrałem fragment od 14,5 do 34,5 s utworu „Kiedy po swojemu gram”. Przy przygotowaniu wejścia pilnuję wspólnego początku obrazu i wokalu, a finalny klip łączę z oryginalnym miksem. Wyseparowany głos pomaga sterować mimiką; nie powinien przypadkowo zastąpić pełnej piosenki w gotowym materiale.
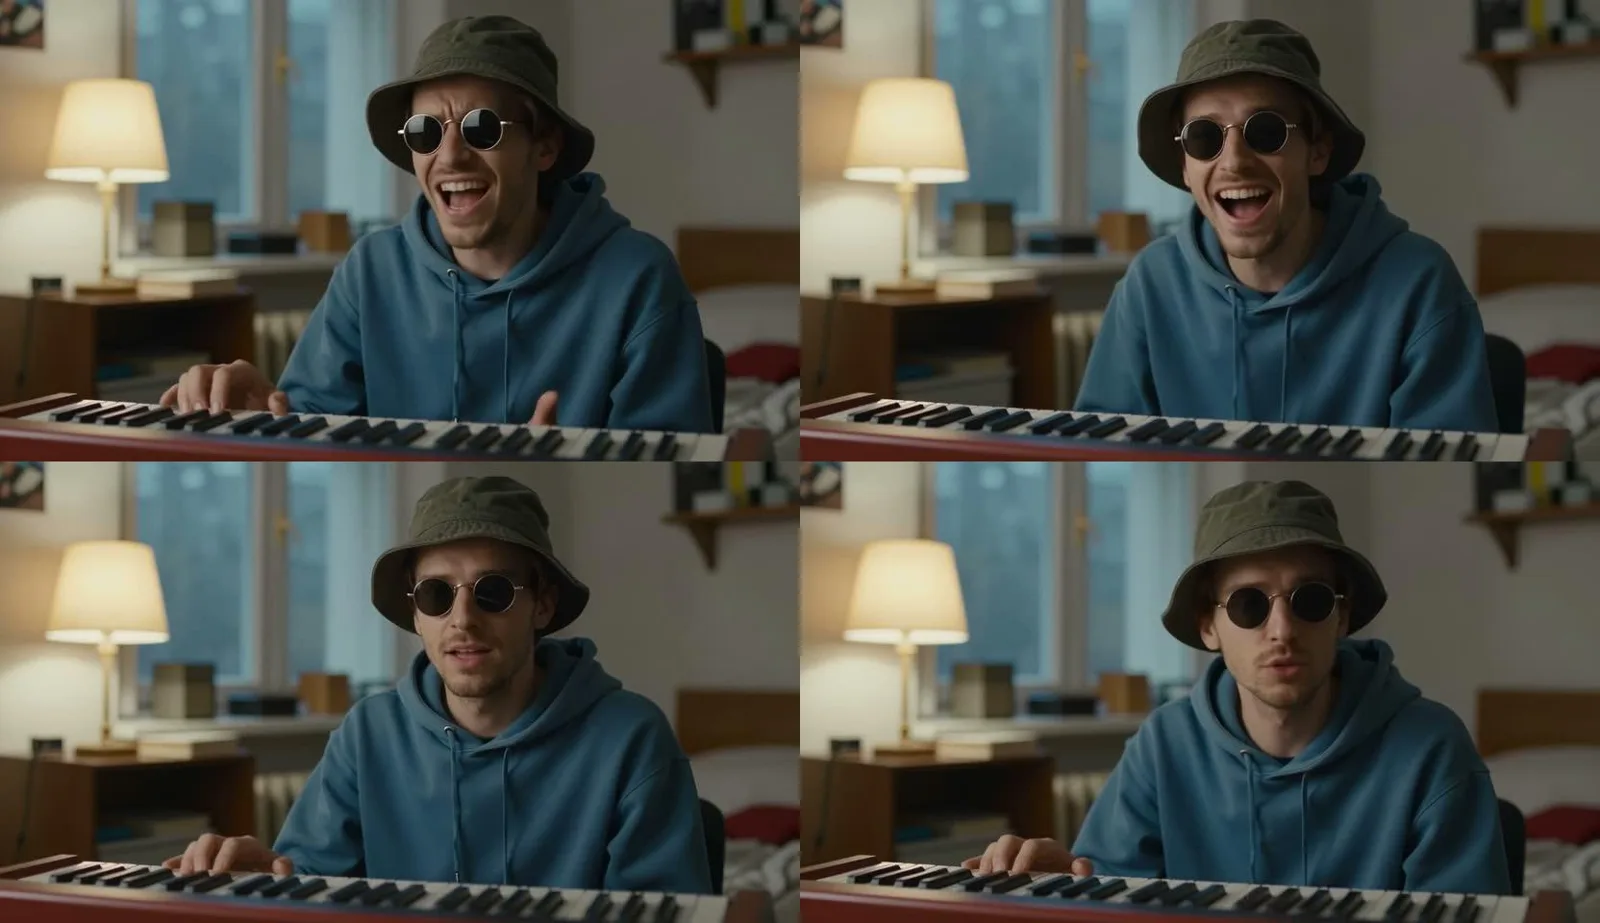
Czas 1284 s dotyczy klipu o długości 20 s. Korelacja otwarcia ust z głośnością wokalu wyniosła 0,471 na wspólnych pierwszych 15 s oraz 0,424 na całym fragmencie. Twarz była wykrywana w 100%. To pomiar MediaPipe z wokalem wydzielonym przez demucs, a nie ocena poprawności wszystkich polskich głosek.
Karta narzędzia proponuje offload encodera tekstu, block swap i osobne dekodowanie VAE. Traktuję je jako wskazówki do zarządzania pamięcią, ponieważ raport nie zapisuje kompletnego presetu ani szczytowego zużycia VRAM. Potwierdzone uruchomienie na RTX 4090 nie pozwala mi obiecać, że dowolna długość, rozdzielczość i graf zmieszczą się równie łatwo.
Transformers 5.x: łata dotycząca hidden_states
Wrapper wymagał poprawki dla transformers 5.17 w obsłudze hidden_states komponentu wav2vec. W zapisie testu pozostała nazwa kopii oryginału: nodes.py.orig-2110. To istotny trop diagnostyczny, gdy środowisko ładuje modele, ale zatrzymuje się przy przetwarzaniu audio. Problem dotyczył współpracy bibliotek, nie samego polskiego tekstu piosenki.
Notatka nie zawiera diffu tej łaty. Nie podaję więc wymyślonego fragmentu kodu ani numerów linii do podmiany. Przy odtwarzaniu tej konfiguracji potrzebny jest zapis poprawki albo zgodna wersja wrappera i transformers. Samo hasło „zaktualizuj wszystko” nie opisuje naprawy, którą potwierdziłem w teście.
Torchaudio, merge_loras i uruchomienie na Windows
W działającym zestawie zastosowałem torchaudio nightly 2.11 pod torch 2.14 cu132. Podaję te wersje jako zapis środowiska testowego, nie polecenie bezwarunkowej aktualizacji każdej instalacji. Przy problemach z importem audio porównuję interpreter, wydanie torch i odpowiadający mu pakiet torchaudio, zanim zacznę zmieniać wagi modelu.
Drugą przeszkodą było scalanie LoRA. Merge powodował access violation na Windows, dlatego użyłem merge_loras=False. To rozróżnienie ma znaczenie: wyłączyłem scalanie, a nie samą LoRA. Usunięcie dodatku i pozostawienie krótkiego samplingu zmieniłoby konfigurację, której wynik opisuję.
ComfyUI uruchamiałem z PYTHONUTF8=1. Przy odtwarzaniu środowiska ustawiam tę zmienną przed startem procesu. Zapisuję też wersje pakietów i zachowuję działający workflow, ponieważ późniejsza zmiana zależności może utrudnić ustalenie, czy problem pochodzi z audio, ładowania modelu, czy wykonania samplera.
V2V: poprawa ust na gotowym klipie
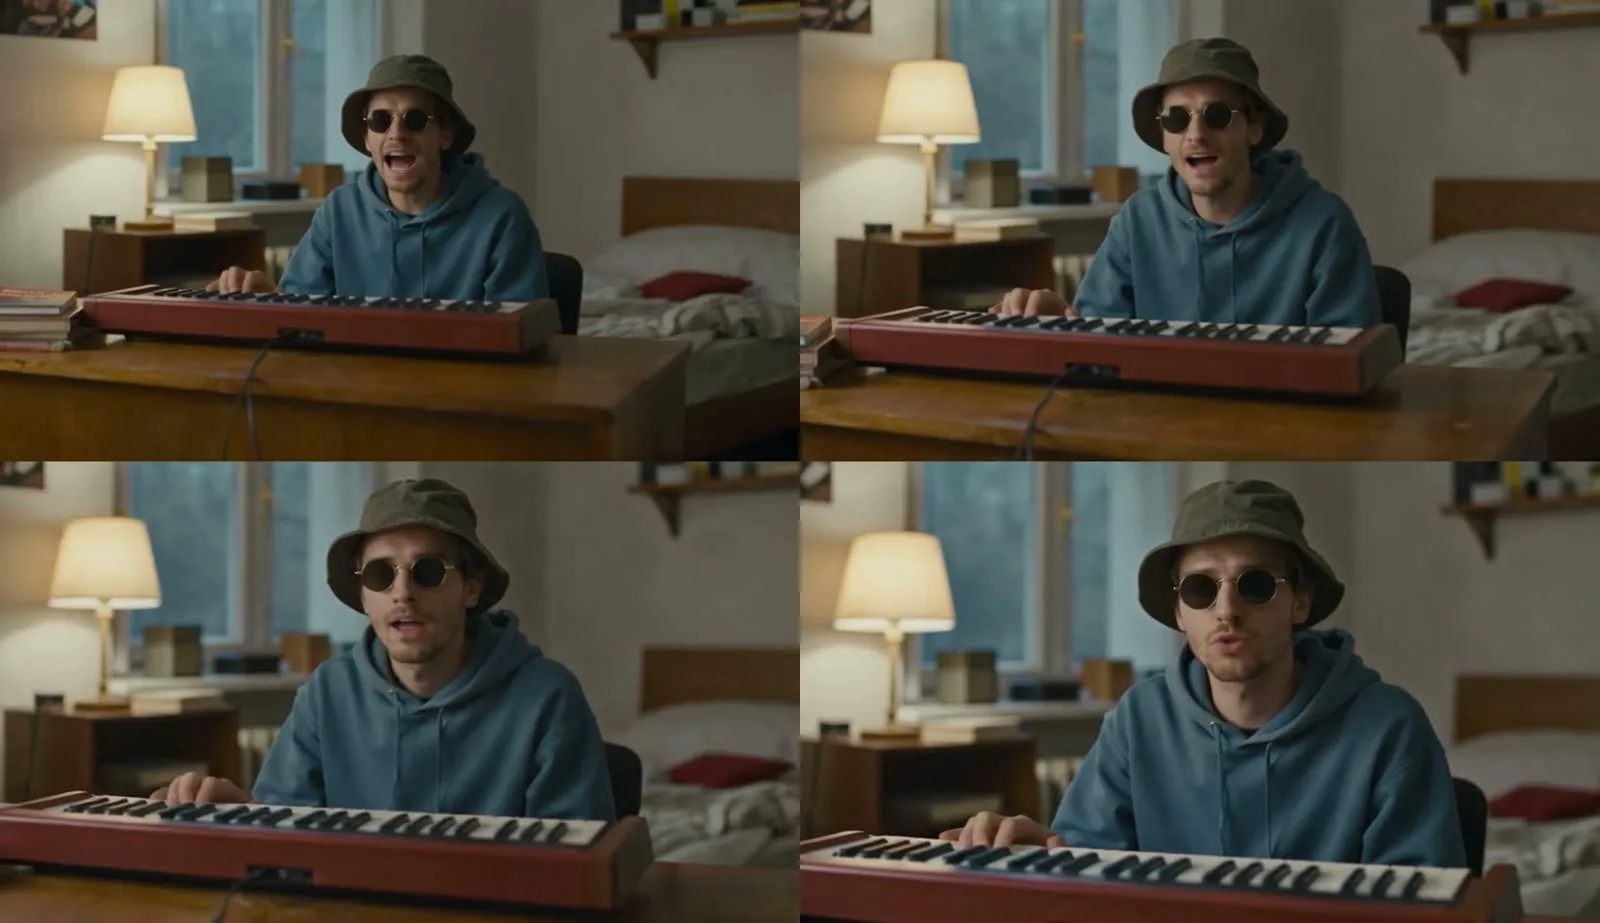
Sprawdziłem także V2V na materiale z Seedance 2.5. Przy 2 z 4 kroków i audio_scale równym 1,5 etap trwał dodatkowe 656 s. Korelacja wzrosła z 0,153 do 0,366, a wykrywanie twarzy wyniosło 77%. Wynik miał 832×480. To osobna konfiguracja, więc nie mieszam jej ustawień z bazową próbą lightx2v.
InfiniteTalk V2V może zmieniać mimikę i ruch, a nie tylko obszar ust. Dlatego po poprawce porównuję także tożsamość postaci i charakter wykonania. Lepszy wskaźnik synchronizacji nie wystarcza, jeśli tracę elementy obrazu, dla których wybrałem wcześniejszy klip. Zachowanie wersji wejściowej ułatwia taką ocenę.
Licencje elementów zestawu
W dokumentacji źródłowej InfiniteTalk, WanVideoWrapper i baza Wan 2.1 mają licencję Apache-2.0. Encoder TencentGameMate oraz wskazana konwersja Kijai deklarują MIT, a ComfyUI jest opisane jako GPL-3.0. Warunki sprawdzam osobno dla kodu, wag i dodatków. Sama licencja wrappera nie obejmuje automatycznie każdego załadowanego modelu.
Repozytorium LightX2V ma w zestawieniu Apache-2.0, lecz brak pełnej nazwy wykorzystanej LoRA ogranicza identyfikację konkretnego pliku. Podobnie dodatkowy separator wokalu wymaga własnej weryfikacji. Nie przenoszę też ograniczeń rodziny Hunyuan na encoder wav2vec wyłącznie z powodu nazwy Tencent.
Najczęstsze pytania
Czy InfiniteTalk działa z polską piosenką?
W opisanej próbie uzyskałem użyteczny wynik. Sprawdziłem konkretny fragment śpiewu, więc nie rozszerzam tego wniosku na każdą barwę głosu, tempo i artykulację.
Czy 21 minut obejmuje instalację?
Nie. Zapisane 1284 s opisuje obliczenia dla klipu. Pobieranie wag, przygotowanie środowiska i diagnozowanie błędów nie mają osobnego pomiaru w raporcie.
Czy mogę skopiować gotową łatę transformers?
W udostępnionym zapisie nie ma jej kodu. Jest informacja o obszarze naprawy i kopii oryginału. Do wiernego odtworzenia potrzebny jest właściwy diff, nie przypadkowa podmiana pliku.
Jeśli dopiero zaczynasz, najpierw zobacz ComfyUI: instalacja na Windowsie i Wan 2.2 lokalnie. Szerzej o modelach na własnej karcie piszę w przewodniku Lokalne AI.
Źródła i data sprawdzenia
- Pomiary i błędy: mój test na RTX 4090, 21.10.2026
- InfiniteTalk - repozytorium i licencja
- Wagi fp8 Kijai (Hugging Face)
- Workflow wrappera wskazany wyżej w tekście
Dane dotyczą stanu zapisanego podczas próby.
Sprawdzone 21 października 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym