FLUX 3 Max po polsku: 3 scenki sitcomu po 15 sekund. Test mowy, lip syncu i kosztu
Trzy scenki po 15 sekund i wersja z poleceniem po polsku: zrozumiałość mowy w Whisperze, lip sync, spójność postaci, czas i koszt w złotych.
👁 118 przeczytań
- FLUX 3 Max pozwala generować klipy od 5 do 20 sekund z dźwiękiem, a 15-sekundowy klip w 720p kosztuje podczas promocji 0,64 USD, czyli 2,48 zł.
- Whisper large-v3 rozpoznał polską mowę niemal bezbłędnie - jedyna różnica to słowo 'czat' zapisane jako 'czad', co wynika z identycznej wymowy, a nie błędu modelu.
- Model sam dzieli 15-sekundową scenę na kilka ujęć (plan ogólny, zbliżenie, reakcja) i zachowuje wygląd postaci przez cały klip bez dodatkowego montażu.
FLUX 3 Max robi klip od 5 do 20 sekund z dźwiękiem, więc sprawdziłem, czy da się nim zrobić krótki sitcom po polsku. 20 października wygenerowałem 3 scenki po 15 sekund i jedną 10-sekundową wersję z poleceniem napisanym w całości po polsku. Wszystkie postacie są fikcyjne, a każdą kwestię sprawdziłem lokalnym Whisperem. Mowa wyszła czysto w każdym klipie, lip sync jest wiarygodny w zbliżeniach, a 15 sekund kosztowało 0,64 USD, czyli 2,48 zł.
W skrócie (20.10.2026)
- Długość: FLUX 3 Max przyjmuje 5-20 s w jednym klipie. Ja robiłem po 15 s, bo 20 s w 720p kosztuje 0,85 USD.
- Polska mowa: Whisper large-v3 zapisał 20/20, 16/17 i 13/15 słów ze scenariusza. Jedyna różnica to „czat” zapisany jako „czad”, a te słowa brzmią po polsku tak samo.
- Lip sync: w zbliżeniach usta układają się zgodnie z kwestią, w planie ogólnym twarze są za małe, żeby to ocenić.
- Montaż: model sam dzieli 15 s na kilka ujęć (plan ogólny, zbliżenie, reakcja) i trzyma te same postacie.
- Czas: 35 s od wysłania do gotowego pliku za 15 s wideo, 21 s za 10 s.
- Wpadki: napis „Kodak Vision3” na identyfikatorze szefa (wziął go z opisu taśmy w poleceniu), postać schodzi po schodach zamiast wchodzić, słabe ziarno mimo opisu taśmy 16 mm.
Do ilu sekund robi film FLUX 3 Max
Według dokumentacji API na fal.ai FLUX 3 Max robi klip od 5 do 20 sekund, co sekundę, w 720p albo 1080p, w proporcjach od 21:9 do 9:16. Dźwięk jest włączony domyślnie. Płacisz za sekundę gotowego wideo, a do 7 listopada 2026 obowiązuje promocja (-75%).
Przeliczam po kursie średnim NBP z 20.10.2026: 1 USD = 3,8959 zł (tabela 204/A/NBP/2026). Kwoty bez VAT.
| Klip | 720p (promocja) | 1080p (promocja) | 720p po 7.11 |
|---|---|---|---|
| 10 s | 0,425 USD (1,66 zł) | 0,725 USD (2,82 zł) | 1,70 USD (6,62 zł) |
| 15 s | 0,6375 USD (2,48 zł) | 1,0875 USD (4,24 zł) | 2,55 USD (9,93 zł) |
| 20 s | 0,85 USD (3,31 zł) | 1,45 USD (5,65 zł) | 3,40 USD (13,25 zł) |
Na test miałem 3 USD, dlatego wybrałem 15 s w 720p: trzy pełne scenki i jedna krótsza wersja kontrolna. Pełnych 20 sekund nie generowałem. Szersze omówienie modelu, cen i szybkości jest w przewodniku FLUX 3 Max, a pomiar czasu generowania w tekście FLUX 3 Max: 10 sekund wideo w 12 sekund?
Jak testowałem
- Tryb tekst na wideo, 16:9, 720p (plik 1280×704, 24 kl./s), dźwięk włączony, rozwijanie polecenia zostawione domyślnie (reasoning_level high).
- Jedno podejście na scenę, bez losowania wersji i bez montażu. Na stronie są klipy w takiej postaci, w jakiej przyszły z API, tylko skompresowane.
- Polecenie po angielsku, kwestie po polsku w cudzysłowie, do tego dopisek, że postacie mówią po polsku powoli i wyraźnie. Na początku blok wyglądu taśmy 16 mm, na końcu zakaz napisów, logo i muzyki.
- Postacie fikcyjne, polskie realia: blok z lat 70., niedzielny obiad, open space w korporacji.
- Zrozumiałość mowy: Whisper large-v3 uruchomiony lokalnie na procesorze, język polski. Liczę, ile słów ze scenariusza pojawiło się w transkrypcji w tej samej kolejności.
- Lip sync, spójność postaci i humor oceniałem na oko, na kadrach co 2 s i seriach 6 klatek na sekundę z ust mówiącej postaci.
Wyniki
| Scenka | Mowa (Whisper) | Czas do pliku | Koszt |
|---|---|---|---|
| Klatka schodowa, paczka od kuriera (15 s) | 20/20 słów (100%) | 34,6 s | 2,48 zł |
| Obiad, dziadek pyta czatbota (15 s) | 16/17 słów (94,1%) | 35,3 s | 2,48 zł |
| Open space, szef i stażysta (15 s) | 13/15 słów (86,7%) | 35,7 s | 2,48 zł |
| Obiad, polecenie po polsku (10 s) | 16/17 słów (94,1%) | 21,3 s | 1,66 zł |
Wszystkie brakujące słowa to „czat”, które Whisper zapisał jako „czad” („Czadbocie”, „Czad przyjdzie jutro na zebranie”). W wymowie to te same głoski, więc model niczego tu nie przekręcił - to ograniczenie samej transkrypcji. Po uwzględnieniu tego wszystkie cztery klipy mówią dokładnie to, co było w scenariuszu. Samo generowanie (pole timings w odpowiedzi API) trwało 20,7-21,2 s na 15 s wideo i 9,2 s na 10 s. Reszta to rozwijanie polecenia, kodowanie i pobieranie.
Cały test kosztował 2,34 USD, czyli 9,11 zł.
Scenka 1: klatka schodowa i paczka od kuriera
- Mowa: bez jednego błędu, łącznie z „majtki w panterkę”.
- Lip sync: przez większość klipu plan ogólny, więc usta widać słabo. Ruszają się w czasie kwestii, ale tu nie da się tego rzetelnie ocenić.
- Humor: najlepsza puenta w teście. Model sam dorzucił na koniec zbliżenie na sąsiada z kartonem, z którego wystaje coś w panterkę, a sąsiad patrzy w kamerę.
- Wpadki: w poleceniu sąsiad wchodzi po schodach z zakupami, a w klipie schodzi. Dres ma trzy paski i logo podobne do znanej marki, choć nie prosiłem o żadną.
Polecenie do skopiowania:
Shot on 16mm Kodak Vision3 250D film: visible organic film grain, slight halation around practical lights, subtle gate weave, gentle exposure flicker, soft imperfect lens, slightly crushed blacks, no digital sharpness, no clean digital look, no CGI sheen, no skin smoothing. Mockumentary sitcom in the style of The Office: handheld documentary camera, small reframing and quick zooms, characters occasionally glance at the camera. A narrow stairwell in an old Polish apartment block from the 1970s, green oil-painted walls, worn terrazzo stairs, a dim bulb. A woman in her sixties in a floral house dress and slippers (Halina) stands in her doorway holding an opened cardboard parcel. A tired man in his forties in a tracksuit (Marek) comes up the stairs with grocery bags. Halina says: "Panie Marku, kurier zostawił u mnie pana paczkę." Marek takes the parcel and says: "Dziękuję, pani Halinko." Halina smiles innocently and says: "Nie ma za co. Ładne te majtki w panterkę." Marek freezes and looks at the camera in embarrassment. All dialogue is spoken in Polish, slowly and clearly, with natural pauses between lines. No subtitles, no captions, no on-screen text, no logos, no music. Natural room sound.
Scenka 2: dziadek pyta czatbota o pierogi
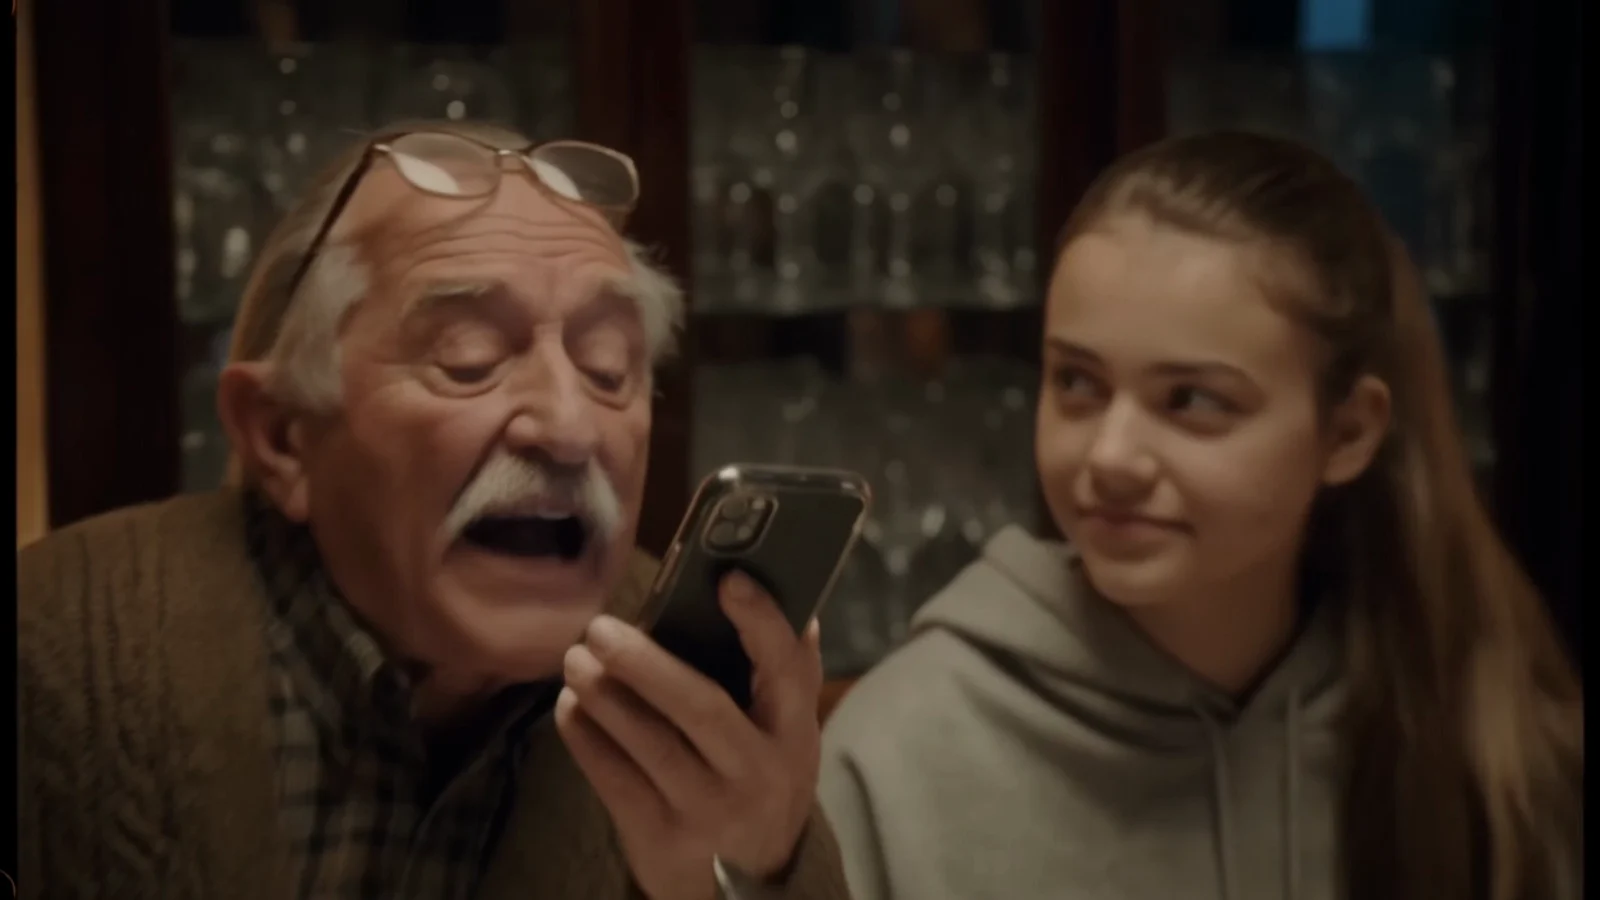
Klip jest na początku tekstu. Tu najlepiej widać, że FLUX 3 Max sam montuje scenę: plan ogólny stołu, szybkie zbliżenie na dziadka z telefonem, wnuczka obok, na koniec reakcja rodziny - jedna z kobiet zasłania usta serwetką. Dziadek i wnuczka wyglądają tak samo we wszystkich ujęciach.
- Mowa: 16/17 słów, jedyna różnica to „Czadbocie”.
- Lip sync: najlepszy w teście. W zbliżeniu dziadek wyraźnie otwiera i zaokrągla usta na kolejnych sylabach, w pauzach je zamyka.
- Wygląd: ciepłe światło lampy, meblościanka z kryształami, koronkowy obrus - polskie realia trafione. Ziarna taśmy prawie nie ma, obraz jest raczej czysty i miękki.
Shot on 16mm Kodak Vision3 250D film: visible organic film grain, slight halation around practical lights, subtle gate weave, gentle exposure flicker, soft imperfect lens, slightly crushed blacks, no digital sharpness, no clean digital look, no CGI sheen, no skin smoothing. Mockumentary sitcom in the style of The Office: handheld documentary camera, small reframing and quick zooms, characters occasionally glance at the camera. Sunday family dinner in a Polish living room: a table with a lace tablecloth, rosół soup in a tureen, a cabinet with crystal glasses in the background, warm lamp light. An elderly grandfather with a grey moustache and a cardigan holds a smartphone very close to his mouth and speaks loudly: "Czatbocie, jak babcia robiła pierogi?" His teenage granddaughter next to him sighs and says: "Dziadku, on nie znał babci." The grandfather puts the phone down, offended, and says: "To po co mu ten cały internet?" The rest of the family tries not to laugh. All dialogue is spoken in Polish, slowly and clearly, with natural pauses between lines. No subtitles, no captions, no on-screen text, no logos, no music. Natural room sound.
Scenka 3: szef, stażysta i raport z czatu
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
- Styl: najbliżej The Office - kamera z ręki, zbliżenia, na koniec stażysta patrzy prosto w obiektyw, tak jak w poleceniu.
- Lip sync: szef mówi ostatnią kwestię w zbliżeniu i usta zgadzają się z dźwiękiem. Pauza stażysty przed „czat” wyszła naturalnie.
- Wpadka: na identyfikatorze szefa widać napis „Kodak Vision3”. Model wziął nazwę taśmy z opisu wyglądu i nadrukował ją na rekwizycie. Jeśli opisujesz taśmę w poleceniu, dopisz, że to tylko styl obrazu, a nie napis.
Shot on 16mm Kodak Vision3 250D film: visible organic film grain, slight halation around practical lights, subtle gate weave, gentle exposure flicker, soft imperfect lens, slightly crushed blacks, no digital sharpness, no clean digital look, no CGI sheen, no skin smoothing. Mockumentary sitcom in the style of The Office: handheld documentary camera, small reframing and quick zooms, characters occasionally glance at the camera. A cheap open-space office in a Polish corporation: grey cubicles, fluorescent ceiling lights, a dying office plant, a water cooler. A balding manager in his fifties with a lanyard holds a printed report and stops at the desk of a young intern with headphones around his neck. The manager says: "Kuba, kto napisał ten raport?" The intern hesitates and says: "Ja. Znaczy... czat." The manager drops the report on the desk and says dryly: "To niech czat przyjdzie jutro na zebranie." The intern looks into the camera. All dialogue is spoken in Polish, slowly and clearly, with natural pauses between lines. No subtitles, no captions, no on-screen text, no logos, no music. Natural room sound.
Wariant: całe polecenie po polsku
Polecenie napisane w całości po polsku zadziałało tak samo dobrze jak angielskie z polskimi kwestiami w cudzysłowie: te same słowa w transkrypcji i ta sama jedyna różnica („Czadbocie”). Obsada wyszła inna (dziadek w swetrze w norweski wzór, przy stole chłopiec), bo każde wywołanie losuje postacie od nowa. W 10 sekundach trzy kwestie lecą szybciej, bez pauz na reakcję, więc żart słabiej wybrzmiewa. Na sitcom lepiej brać 15 s.
Nakręcone na taśmie 16 mm Kodak Vision3 250D: wyraźne organiczne ziarno, lekka halacja wokół lamp, delikatne drżenie klatki, miękki niedoskonały obiektyw, bez cyfrowej ostrości i bez wygładzania skóry. Sitcom w stylu paradokumentu jak The Office: kamera z ręki, drobne korekty kadru i szybkie zbliżenia. Niedzielny obiad rodzinny w polskim salonie: stół z koronkowym obrusem, rosół w wazie, w tle meblościanka z kryształami, ciepłe światło lampy. Starszy dziadek z siwym wąsem i w swetrze trzyma smartfon tuż przy ustach i mówi głośno: "Czatbocie, jak babcia robiła pierogi?" Wnuczka nastolatka obok wzdycha i mówi: "Dziadku, on nie znał babci." Dziadek odkłada telefon, obrażony, i mówi: "To po co mu ten cały internet?" Reszta rodziny powstrzymuje śmiech. Wszystkie kwestie po polsku, powoli i wyraźnie, z naturalnymi pauzami. Bez napisów, bez tekstu na ekranie, bez logo, bez muzyki.
Gdzie się sypie
- Napisy z polecenia: nazwa taśmy wylądowała na identyfikatorze. Model chętnie zamienia słowa z opisu w tekst w kadrze.
- Kierunek ruchu: postać zrobiła odwrotnie niż w poleceniu (schodzi zamiast wchodzić). Przy jednym podejściu na scenę warto liczyć się z poprawką.
- Analogowy wygląd: mimo opisu taśmy 16 mm, ziarna i halacji obraz wychodzi dość czysty. Ziarno lepiej dodać w montażu.
- Spójność między klipami: w ramach jednego klipu postacie się trzymają, ale nowe wywołanie to nowa obsada. Do serialu z tymi samymi bohaterami trzeba by użyć trybu obraz na wideo ze zdjęciem postaci.
- Logo: model sam dodał dres z paskami w stylu znanej marki. Do publikacji trzeba to wyłapać.
- Plan ogólny: gdy kamera stoi daleko, lip sync jest nie do sprawdzenia - jeśli dialog jest najważniejszy, poproś o zbliżenia.
Na tle innych modeli
We wrześniowym teście polskiej mowy na 10 modelach bez błędu mówiły tylko MiniMax H3 Max, Gemini Omni Flash 1.1 i Grok Imagine Video 1.5. Wan 3.0 miał 16,7% błędnych słów, Seedance 2.0 i 2.5 ponad połowę. Tam zdanie było trudniejsze, bo z łamańcem „W Szczebrzeszynie chrząszcz brzmi w trzcinie”, a sam FLUX 3 Max w moim pierwszym teście zlepił „W Szczebrzeszynie” w jedno słowo (2 błędy na 12).
W dialogu z codziennymi słowami FLUX 3 Max nie przekręcił żadnego wyrazu w trzech kwestiach na scenę, rozdzielonych między dwie mówiące postacie. Do tego sam przypisuje kwestie właściwym osobom i dokłada reakcje reszty obsady. Dla porównania ceny: Wan 3.0 przez API kosztuje 0,10 USD za sekundę w 720p, czyli 1,50 USD za 15 s, a FLUX 3 Max w promocji 0,64 USD. Po 7 listopada FLUX 3 Max podrożeje do 2,55 USD za 15 s.
Wnioski
- FLUX 3 Max nadaje się do krótkich scenek z polskim dialogiem: 2-3 kwestie w 15 sekundach wychodzą czysto i są zrozumiałe bez napisów.
- Najlepiej działa prosty żart z wyraźną puentą i zbliżeniem na koniec. Model sam dokłada reakcje i spojrzenie w kamerę.
- Na sitcom 15 s to rozsądna długość: 10 s jest za ciasno na pauzy, a 20 s kosztuje o jedną trzecią więcej.
- Zanim opublikujesz, obejrzyj klatka po klatce: napisy z polecenia, logo i odwrócone ruchy to typowe wpadki.
- Do serii z tymi samymi bohaterami sam tekst nie wystarczy - potrzebne zdjęcie postaci na start.
Najczęstsze pytania
Ile sekund ma najdłuższy klip w FLUX 3 Max?
20 sekund. Minimalnie 5 sekund, długość ustawia się co sekundę.
Czy FLUX 3 Max mówi po polsku?
Tak. W moich trzech scenkach i wersji z poleceniem po polsku każda kwestia była zrozumiała, a Whisper rozpoznał wszystkie słowa poza „czat”, które zapisał fonetycznie jako „czad”. Polski nie jest wymieniony w opisie modelu.
Ile kosztuje 15-sekundowa scenka?
0,6375 USD w 720p, czyli 2,48 zł po kursie NBP z 20.10.2026, do końca promocji 7 listopada 2026. W 1080p 1,0875 USD (4,24 zł).
Czy polecenie trzeba pisać po angielsku?
Nie musisz. Polecenie w całości po polsku dało tę samą jakość mowy. Ja i tak trzymam opis sceny po angielsku, a po polsku tylko kwestie w cudzysłowie, bo łatwiej wtedy oddzielić dialog od opisu.
Google · Twoje źródłaPromptowy wyżej w Twoim Google - jednym kliknięciemDodaj do preferowanych źródeł →Źródła
- Test własny 20.10.2026: 4 klipy FLUX 3 Max (text-to-video) przez API fal.ai, 720p, koszt 2,34 USD; transkrypcja Whisper large-v3 lokalnie.
- fal.ai: FLUX 3 Max Text to Video - karta i cennik (odczyt 20.10.2026).
- fal.ai: FLUX 3 Max Text to Video - dokumentacja API (długość 5-20 s, odczyt 20.10.2026).
- NBP: tabela A nr 204/A/NBP/2026 z 20.10.2026, USD 3,8959 zł.
- Wyniki odniesienia: test polskiej mowy na 10 modelach (28.09.2026) i FLUX 3 Max na 11 klipach (20.10.2026).
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym