Czyje są te słowa: nowy front wojny o własność w epoce AI
Konflikt o to, kto jest właścicielem wiedzy zamkniętej w modelach AI, to nie spór prawny - to spór o przyszły podział wartości w sieci.

👁 126 przeczytań
- Spór o własność w epoce AI dotyczy tego, że modele językowe destylują style i wzorce twórców bez żadnej umowy ani wynagrodzenia, nie naruszając formalnie prawa autorskiego.
- Mechanizm opt-out to pułapka, bo odwraca ciężar dowodu - to twórca musi bronić swojej pracy, a modele już wytrenowane na jego treściach nie "zapomną" jej po wypisaniu się.
- Najbardziej prawdopodobny scenariusz to podział rynku: wielcy wydawcy dostaną licencje i pieniądze, a indywidualni twórcy zostaną bez niczego, bo nie mają siły przetargowej.
Wyobraźmy sobie pisarkę, która przez piętnaście lat budowała swój styl. Nauczyła się rytmu zdania, własnego sposobu układania metafor, charakterystycznej szorstkości w dialogach. A potem ktoś pyta model językowy o „opowiadanie w stylu tej pisarki” i dostaje, w trzy sekundy, coś, co brzmi jak ona. Nie kopia - destylat. Pisarka nigdy nie podpisała żadnej umowy. Nigdy nie dostała ani złotówki. I formalnie rzecz biorąc, nikt nie ukradł jej ani jednego zdania. A jednak coś jej zabrano.
To jest sedno sporu, który nazwałem dla siebie wojną o własność w epoce AI. I uważam, że jest to najważniejszy konflikt gospodarczy nadchodzącej dekady - większy niż dyskusja o tym, czy AI zabierze nam pracę. Bo zanim cokolwiek nam zabierze, najpierw musiała coś od nas wziąć.
Trzy strony, które udają dwie
Publiczna narracja lubi przedstawiać ten spór jako pojedynek: twórca kontra firma technologiczna. Dawid kontra Goliat, artysta kontra maszyna. To wygodne, bo łatwe do opowiedzenia. Ale jest fałszywe, bo stron jest co najmniej trzy, a ich interesy nie układają się w prostą linię.
Pierwsza strona to twórcy - ci, którzy wyprodukowali surowiec. Teksty, zdjęcia, kod, muzykę, miliardy postów i komentarzy. To oni dostarczyli materiał, na którym modele się uczyły. Ich argument jest moralnie czysty: bez naszej pracy wasze modele byłyby puste.
Druga strona to firmy trenujące modele - te, które zainwestowały gigantyczne pieniądze w infrastrukturę, badania i ludzi. Ich argument brzmi inaczej, ale też nie jest głupi: nie kopiujemy waszych dzieł, my uczymy się z nich tak, jak człowiek uczy się czytając. Statystyczny wzorzec nie jest plagiatem.
I jest trzecia strona, najczęściej pomijana, a być może najważniejsza: my wszyscy, użytkownicy. Bo to my naciskamy enter i oczekujemy, że odpowiedź pojawi się natychmiast, za darmo albo za dwadzieścia dolarów miesięcznie. To nasz popyt napędza całą maszynę. Łatwo oburzać się na firmy, trudniej przyznać, że jesteśmy współwinni - korzystamy z owoców, których pochodzenia wolimy nie sprawdzać.
Dopóki będziemy opowiadać ten konflikt jako dwustronny, nie zrozumiemy go - bo prawdziwa walka toczy się o to, kto zostanie wykluczony z podziału tortu.
Czym właściwie jest „własność” wiedzy
Tu robi się trudno, i tu większość dyskusji się rozsypuje. Prawo autorskie chroni konkretną formę wyrazu - to zdanie, ten akapit, tę fotografię. Nie chroni stylu, idei, wiedzy ani faktów. Możesz napisać powieść detektywistyczną, nikt nie ma monopolu na gatunek. Możesz pisać jak Hemingway, krótkimi zdaniami, i jest to legalne.
Model językowy żyje dokładnie w tej szczelinie. Nie przechowuje twoich zdań - przechowuje statystyczne prawdopodobieństwo, że po jednym słowie pojawi się drugie. To nie jest archiwum, to jest skompresowana mapa wzorców. I tu firmy mają mocny argument: jeśli człowiek może czytać tysiąc kryminałów i napisać własny, dlaczego maszynie nie wolno?
Odpowiedź, którą uważam za kluczową, brzmi: bo skala zmienia naturę zjawiska. Jeden człowiek czytający tysiąc książek to kultura. Jeden system czytający dziesięć milionów książek i produkujący tekst dla stu milionów ludzi jednocześnie to coś innego - to przemysłowa ekstrakcja wartości z dorobku, który nigdy nie był pomyślany jako paliwo. Różnica między czytelnikiem a modelem jest taka, jak różnica między człowiekiem łowiącym ryby na wędkę a flotą trawlerów osuszających ocean. Ta sama czynność. Inny gatunek konsekwencji.
Nie kradnie się zdań. Kradnie się prawdopodobieństwo, że następne zdanie napiszesz właśnie ty - i że ktoś za to zapłaci tobie, a nie maszynie wytrenowanej na tobie.
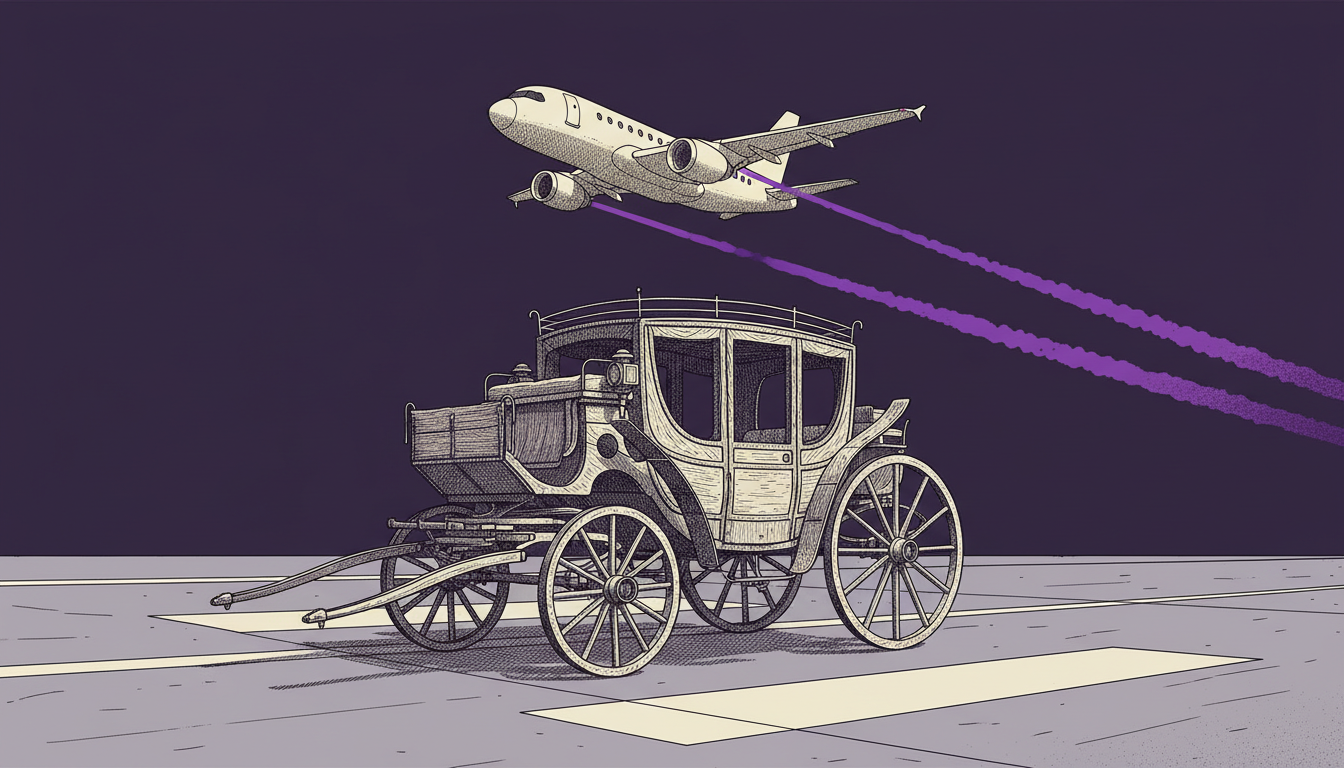
Dlatego uważam, że spór o własność w epoce AI nie da się rozstrzygnąć w ramach starego prawa autorskiego. Ono zostało napisane dla świata, w którym kopiowanie było kosztowne, a styl był nieuchwytny. Dziś kopiowanie jest darmowe, a styl da się wydestylować. To jak próba regulowania ruchu lotniczego przepisami o powozach konnych.
Interesy, które rządzą tym sporem
Żeby zrozumieć, dokąd to zmierza, trzeba odłożyć moralność i spojrzeć na interesy. Bo to one - nie poczucie sprawiedliwości - określą, jak skończy się ta wojna.
Wielkie firmy technologiczne mają interes w utrzymaniu obecnego stanu jak najdłużej. Każdy rok bez jasnych regulacji to rok darmowego surowca. Ich strategia jest klasyczna: działać szybko, ustanowić fakty dokonane, a potem negocjować z pozycji właściciela już zbudowanego imperium. Kiedy model jest już wytrenowany, nie da się go „odtrenować” - wiedza weszła w jego strukturę na zawsze. To daje im przewagę, której żaden sąd nie cofnie.
Wielcy posiadacze treści - wydawnictwa, agencje prasowe, koncerny medialne - mają interes inny niż im się oficjalnie przypisuje. Oni nie chcą zatrzymać AI. Oni chcą dostać za swój katalog godziwą cenę. I tu dzieje się rzecz znamienna: kiedy firma technologiczna podpisuje umowę licencyjną z dużym wydawcą, obie strony są zadowolone, a problem znika z nagłówków. Wielcy się dogadają. Zawsze się dogadują. Bo mają prawników, katalogi i siłę przetargową.
Przegrywa ten trzeci, niewidoczny twórca - indywidualny bloger, fotograf, programista, autor, którego dorobek rozpłynął się w zbiorze treningowym bez śladu i bez ceny. On nie ma z kim negocjować. Jego praca jest warta zero przy stole rozmów, choć w sumie - razem z milionami takich jak on - stanowi większość paliwa.
Najgorszy możliwy scenariusz to taki, w którym wielcy dostają licencje i pieniądze, a indywidualni twórcy dostają komunikat, że „ich wkład był nieistotny statystycznie”. A to jest właśnie scenariusz, ku któremu zmierzamy najszybciej.
Pułapka opt-outu
Co sam z tego zbudowałem
Osiem narzędzi, które powstały z problemów opisywanych na tym blogu - razem z tym, czego nie udało się dowieźć.
Pojawia się modne rozwiązanie: pozwólmy twórcom się wypisać. Mechanizm opt-out, znacznik „nie używaj mojej treści do trenowania”. Brzmi sprawiedliwie. Jest pułapką.
Po pierwsze, opt-out odwraca ciężar. To ja, twórca, muszę aktywnie bronić tego, co stworzyłem, zamiast firmy musieć aktywnie zapytać mnie o zgodę. To jak system, w którym dom jest twój, dopóki nie powiesisz tabliczki „proszę nie wchodzić” - a jeśli zapomnisz, każdy może się wprowadzić.
Po drugie, opt-out działa tylko w przód. Modele już wytrenowane na twojej pracy nie przestaną jej znać dlatego, że dziś podniosłeś rękę. Wypisanie się z przyszłości nie zwraca przeszłości.
Po trzecie, i to jest najbardziej cyniczne, opt-out tworzy iluzję wyboru tam, gdzie wyboru nie ma. Twórca, który chce być widoczny w sieci, musi w niej publikować. A publikować to znaczy karmić maszyny. Wybór między „bądź niewidoczny” a „bądź darmowym paliwem” nie jest wyborem. To ultimatum przebrane za wolność.
Co by było uczciwe, a co realne
Zwykle w tym miejscu autor proponuje czyste rozwiązanie i kończy z poczuciem misji. Ja nie mam czystego rozwiązania, bo go nie ma. Mam za to przekonanie, w którą stronę powinniśmy iść, i trzeźwą ocenę, czy tam pójdziemy.
Uczciwe byłoby uznanie, że trening na cudzej pracy tworzy zobowiązanie - nie zawsze do zapłaty za każdy okruch, bo to technicznie niemożliwe, ale do dzielenia się wartością. Wyobrażam sobie model, w którym firmy trenujące modele odprowadzają część przychodów do wspólnej puli, redystrybuowanej wśród twórców - coś jak organizacje zbiorowego zarządzania prawami, które od dawna działają w muzyce. Niedoskonałe, biurokratyczne, ale lepsze niż zero.
Realne jest natomiast co innego. Realne jest, że dojdzie do serii procesów sądowych, z których część firmy przegrają i zapłacą odszkodowania traktowane jak koszt prowadzenia biznesu. Realne jest, że wielcy posiadacze treści dostaną swoje licencje. Realne jest, że powstaną dwa internety: jeden zamknięty, płatny, chroniony przed scrapingiem, dla tych, których stać na mury, i drugi - otwarty, darmowy, wydojony do sucha. Realne jest, że indywidualny twórca zostanie z niczym, chyba że zacznie organizować się zbiorowo, bo pojedynczo nie ma żadnej siły.
Bo to jest, w gruncie rzeczy, stary konflikt w nowym opakowaniu. Tak samo rzemieślnicy przegrali z fabrykami w XIX wieku. Tak samo muzycy przegrali pierwszą rundę z cyfrową dystrybucją. Za każdym razem technologia najpierw bierze, potem rynek się układa, a na końcu prawo dogania rzeczywistość - spóźnione o całe pokolenie poszkodowanych.
Google · Twoje źródłaPromptowy wyżej w Twoim Google - jednym kliknięciemDodaj do preferowanych źródeł →Czego naprawdę dotyczy ten spór
Na koniec chcę powiedzieć rzecz, która brzmi mniej technicznie, a wydaje mi się najważniejsza. Ten spór tylko z pozoru dotyczy pieniędzy i praw autorskich. W rzeczywistości dotyczy tego, czy warto jeszcze tworzyć.
Bo jeśli każda wartościowa rzecz, którą stworzysz, w ciągu miesięcy stanie się anonimowym składnikiem systemu, który będzie produkował jej tańsze warianty bez końca, to gdzieś po drodze gaśnie sam motyw, dla którego ludzie tworzą. Nie chodzi tylko o to, że twórca nie dostanie pieniędzy. Chodzi o to, że przestanie istnieć jako rozpoznawalne źródło. Stanie się glebą, na której rośnie las podpisany cudzym nazwiskiem.
A kultura, która zniechęca ludzi do tworzenia oryginalnych rzeczy, w końcu zostaje bez nowego materiału do trenowania. Modele zaczynają uczyć się na własnych wynikach, jak fotokopia kopii, coraz bledsza. Ten spór ma więc drugie dno, o którym firmy technologiczne wolą nie myśleć: niszcząc twórców, podcinają gałąź, na której same siedzą.
Mój wniosek jest taki: to nie jest spór o przeszłe dzieła, lecz o to, kto sfinansuje powstawanie przyszłych. Jeśli nie znajdziemy sposobu, by wartość wracała do ludzi, którzy ją tworzą, dostaniemy świat technicznie zachwycający i twórczo jałowy - pełen idealnie gładkich tekstów, które nie mają już nikogo za sobą.
Pisarka z początku tego tekstu nie zniknie z dnia na dzień. Po prostu pewnego ranka odkryje, że jej styl jest dostępny dla wszystkich, a ona dla nikogo. I to jest cena, którą płacimy wspólnie, choć rachunek wystawiono tylko jej.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Najczęstsze pytania
Czy model językowy łamie prawo autorskie, generując tekst w stylu konkretnego pisarza?
Formalnie nie, bo prawo autorskie chroni konkretną formę wyrazu, a nie styl, idee ani wzorce językowe. Model przechowuje statystyczne prawdopodobieństwo następstwa słów, a nie archiwum cudzych zdań - i firmy technologiczne wskazują to jako główny argument prawny.
Na czym polega problem z mechanizmem opt-out dla twórców w kontekście trenowania AI?
Opt-out działa tylko w przód i nie przywraca pracy już wykorzystanej do trenowania modeli. Dodatkowo twórca, który chce być widoczny w sieci, musi w niej publikować, co oznacza, że wybór między niewidocznością a byciem darmowym surowcem nie jest realnym wyborem.
Kto realnie wygra spór o prawa do treści używanych do trenowania modeli AI?
Według analizy zawartej w artykule wielcy posiadacze treści - wydawnictwa i agencje medialne - dogadają się z firmami technologicznymi i dostaną licencje. Indywidualni twórcy, blogerzy i fotografowie nie mają siły przetargowej, więc najprawdopodobniej nie dostaną nic.
Jakie uczciwe rozwiązanie konfliktu między twórcami a firmami AI byłoby możliwe?
Autor artykułu wskazuje model zbliżony do organizacji zbiorowego zarządzania prawami działających w muzyce - firmy trenujące modele odprowadzałyby część przychodów do wspólnej puli redystrybuowanej wśród twórców. Sam ocenia to rozwiązanie jako niedoskonałe i biurokratyczne, ale lepsze niż brak jakiejkolwiek rekompensaty.

Podobne tematy na Promptowym