llms.txt: sprawdziłem w logach, czy boty AI go czytają
13 dni logów serwera: ponad 61 tys. zapytań od botów AI do strony i zero wejść na llms.txt. Co mówi Google, które podstrony czyta ChatGPT i jak sprawdzić to u siebie.
👁 124 przeczytań
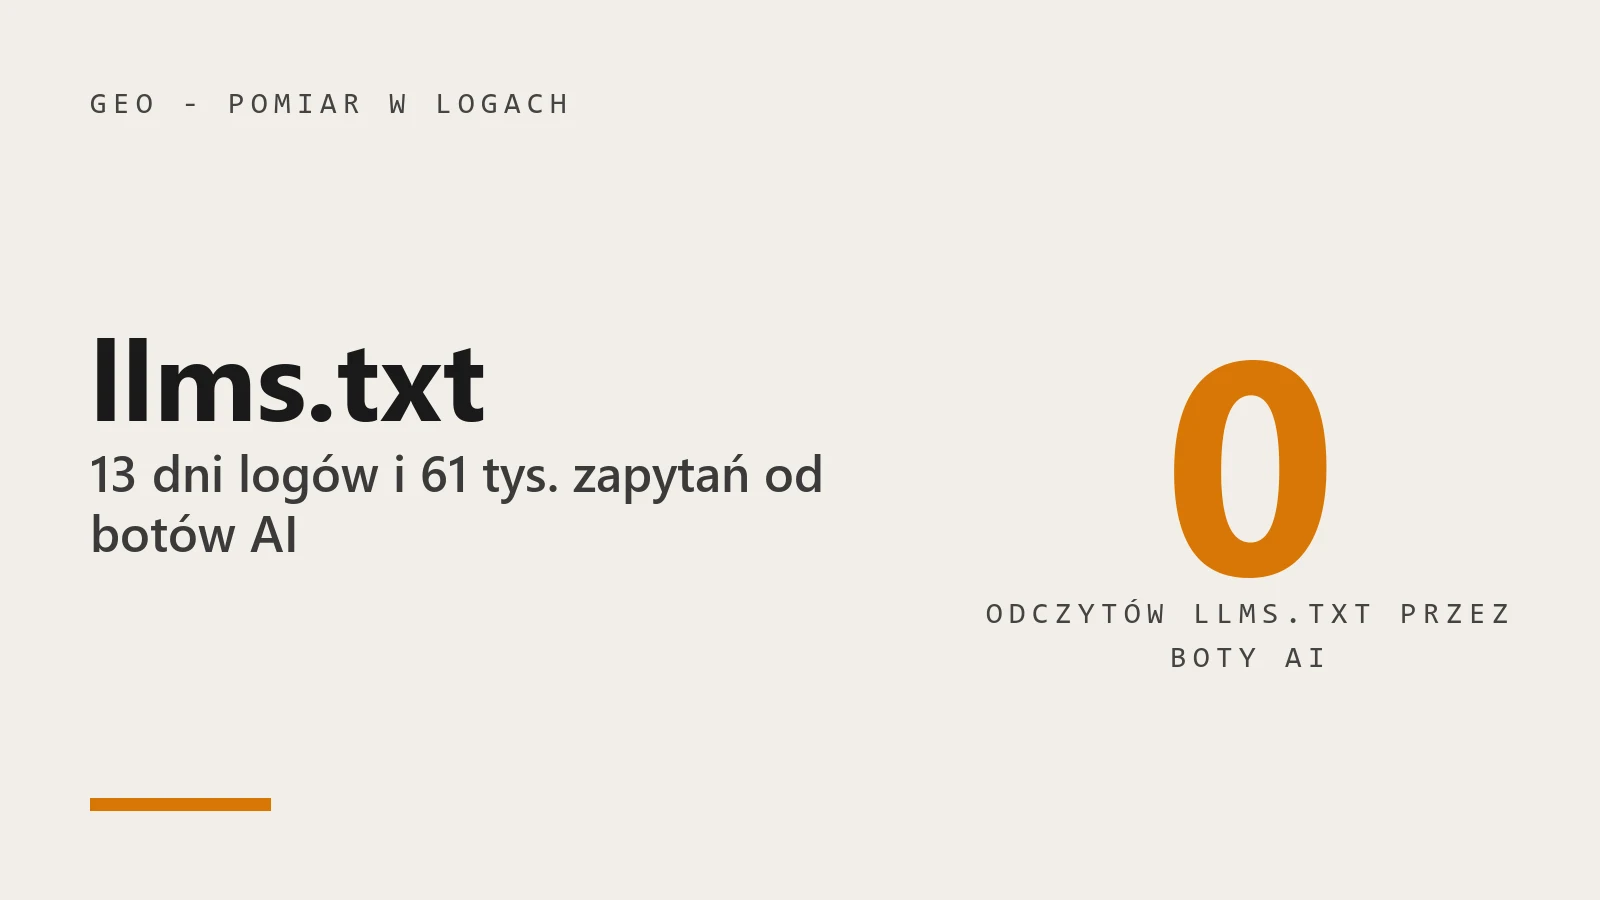
Promptowy ma plik llms.txt: 230 linii, 170 linków do najważniejszych stron, generowany automatycznie przez WordPressa. Przejrzałem 13 dni logów serwera, od 24 października do 5 listopada 2026, czyli 1 832 096 zapytań. W tym czasie zapytań podpisanych przez boty OpenAI, Anthropic i Perplexity było ponad 61 tysięcy. Ile razy któryś z nich otworzył llms.txt? Zero.
Piszę to, bo llms.txt często pada jako pierwszy krok „pozycjonowania w ChatGPT”. Moje logi mówią coś innego, więc pokazuję liczby, sposób, w jaki je policzyłem, i komendy, którymi sprawdzisz to u siebie.
Czym jest llms.txt
To propozycja Jeremy’ego Howarda z 3 września 2024 roku, opisana na llmstxt.org. Plik leży w katalogu głównym strony, pod adresem /llms.txt, i jest zwykłym tekstem w Markdownie. Jedynym wymaganym elementem jest nagłówek H1 z nazwą serwisu. Dalej może być krótki opis w cytacie i sekcje H2 z listami linków do stron, które model językowy powinien przeczytać najpierw. Ideą jest skrót: zamiast przekopywać się przez menu, reklamy i skrypty, model dostaje spis treści w formie, którą łatwo przetwarza.
Mój plik zaczyna się od „# Promptowy”, ma opis serwisu, sekcję „O źródle” z autorem i metodą, a potem grupy linków: narzędzia, status usług na żywo, ceny i porównania. Obok leży llms-full.txt, wersja z pełną treścią, która waży 7,34 MB i ma 80 795 linii.
To nie jest standard żadnej organizacji. Nie ma go w dokumentacji robotów OpenAI, Anthropic ani Perplexity. Google opisał go wprost i wrócę do tego niżej.
Co pokazały logi
Serwer zapisuje każde zapytanie z adresem IP, datą, ścieżką, kodem odpowiedzi i podpisem przeglądarki, czyli user agentem. Wyciągnąłem z dziennych archiwów wszystkie wejścia na /llms.txt, /llms-full.txt i /robots.txt, a osobno policzyłem zapytania od botów AI do całej strony.
Na llms.txt było 95 wejść, na llms-full.txt 22. Najwięcej, 26 razy, plik pobrał SEOJuice, narzędzie do audytów SEO. Dalej agentwebmap-bot (15 razy), crawler zbiorów danych code-docs-corpus (7 razy), Googlebot (4 razy), kilka audytorów stron i kilkanaście zwykłych przeglądarek, pewnie ludzi z branży, którzy zaglądali, jak plik wygląda.
W surowym wyniku znalazłem też po jednym wejściu od GPTBota, OAI-SearchBota, ClaudeBota, PerplexityBota i kilkunastu innych. Wyglądało to obiecująco, dopóki nie spojrzałem na godziny. Wszystkie przyszły z jednego polskiego adresu w ciągu 13 sekund, 30 października między 00:03:13 a 00:03:26, każde z innym podpisem bota. To był test dostępu, który sam puściłem przy porządkowaniu generatora pliku. Prawdziwy GPTBot nie przychodzi z domowego łącza w Polsce.
[30/Oct/2026:00:03:13] "GET /llms.txt" 200 "... GPTBot/1.2; +https://openai.com/gptbot"
[30/Oct/2026:00:03:14] "GET /llms.txt" 200 "... OAI-SearchBot/1.0; +https://openai.com/searchbot"
[30/Oct/2026:00:03:16] "GET /llms.txt" 200 "... ClaudeBot/1.0; [email protected]"
[30/Oct/2026:00:03:18] "GET /llms.txt" 200 "... PerplexityBot/1.0; +https://perplexity.ai/..."
(18 podpisów, jeden adres IP, 13 sekund)
Po odjęciu tej serii żaden bot OpenAI, Anthropic ani Perplexity nie pobrał llms.txt. Sprawdziłem to też odwrotnie: wziąłem oficjalne listy adresów IP, które publikują OpenAI i Perplexity, i przefiltrowałem wejścia na llms.txt. Z tych adresów nie przyszło ani jedno.
Na stronę wchodzą, na llms.txt nie
Nie jest tak, że boty AI mojej strony nie znają. Przez te same 13 dni:
| Bot | Do czego służy | Zapytań do strony | Wejść na llms.txt |
|---|---|---|---|
| OAI-SearchBot | indeks wyszukiwarki ChatGPT | 19 921* | 0 |
| ClaudeBot | zbieranie danych Anthropic | 18 621 | 0 |
| PerplexityBot | indeks wyszukiwarki Perplexity | 11 289* | 0 |
| GPTBot | dane do trenowania modeli OpenAI | 4 184 | 0 |
| ChatGPT-User | wejście na stronę na prośbę użytkownika czatu | 2 219* | 0 |
| Claude-User | to samo w Claude | 2 563 | 0 |
| Googlebot | indeks Google | 137 287 | 4 |
* tylko zapytania z oficjalnych zakresów IP publikowanych przez OpenAI i Perplexity. Liczby ClaudeBota, Claude-User, GPTBota i Googlebota to zapytania z podpisem bota, bez weryfikacji adresu. Okres: 24.10-5.11.2026, logi serwera promptowy.com.
OAI-SearchBot wszedł na 3 484 różne adresy, PerplexityBot na 3 774. Oba biorą strony z mapy witryny i z linków, tak jak robi to Googlebot. Po co im spis w llms.txt, skoro czytają oryginał?
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Jedna rzecz mnie zaskoczyła. Z 19 921 zapytań OAI-SearchBota tylko 5 259 to były strony. Reszta to pliki CSS, skrypty i 7 364 wywołania moich własnych liczników statystyk, które odpalają się dopiero w przeglądarce. Wniosek: robot wyszukiwarki ChatGPT renderuje strony razem z JavaScriptem. Jeśli liczysz kliknięcia własnym skryptem, odfiltruj go, bo nabija statystyki.
Kto naprawdę czyta stronę za użytkownika czatu
Najciekawszy jest ChatGPT-User. Ten podpis pojawia się, gdy ktoś w ChatGPT zadaje pytanie, a model wchodzi na stronę, żeby odpowiedzieć. W 13 dni było 2 219 takich wejść z adresów OpenAI, na 790 różnych podstron. Na górze listy, poza stroną główną (388 razy), były: kiedy wybory (56), kalendarz AI (22), cena ChatGPT w Polsce (18) i porównanie ChatGPT Plus czy Pro (14).
Widać wzór: czat sięga do strony, gdy pytanie dotyczy konkretu, który się zmienia. Daty, ceny w złotych, porównania planów. To samo zauważyłem w danych Binga, które opisałem w tekście o tym, jak Copilot cytuje Promptowego. Model nie potrzebuje mojego streszczenia. Potrzebuje strony, na której aktualna liczba stoi blisko początku, z datą sprawdzenia.
Uwaga na podrobione boty
Perplexity-User miał w logach 540 zapytań i ani jednego z adresów Perplexity. Wszystkie szukały plików w rodzaju /.env, /.env.production albo /config/gcp-credentials.json. To skanery, które podszywają się pod boty AI, bo liczą, że administratorzy wpuszczą je bez sprawdzania. Z 2 782 wejść podpisanych jako ChatGPT-User 563 też nie pochodziło od OpenAI.
Praktyczna rada: nie otwieraj niczego tylko dlatego, że user agent mówi „GPTBot”. Weryfikuj adres IP z oficjalną listą, a jeśli nie da się tego zrobić, traktuj podpis jako deklarację, nie dowód.
Co mówi Google
W poradniku o optymalizacji pod wyszukiwanie AI Google pisze, że do pojawienia się w wyszukiwarce, łącznie z funkcjami generatywnymi, nie trzeba tworzyć żadnych plików dla AI ani Markdownu, bo wyszukiwarka z nich nie korzysta. O llms.txt jest osobne zdanie: możesz go utrzymywać, ale nie zaszkodzi to ani nie pomoże widoczności w Google, bo Google go ignoruje. Fragment trafił do dokumentacji w czerwcu 2026 roku, a rok wcześniej to samo mówił publicznie Gary Illyes z Google.
Moje 4 wejścia Googlebota na llms.txt nic tu nie zmieniają. Googlebot pobiera każdy adres, który znajdzie w linkach, więc trafił i na ten.
Moje zdanie: zostawiam plik, ale nie płacę za niego
Nie usuwam llms.txt. Generuje się sam, nikomu nie szkodzi, a czytają go narzędzia SEO i kilka mniejszych crawlerów. Jeśli kiedyś OpenAI albo Anthropic zaczną z niego korzystać, będzie gotowy.
Ale jeśli ktoś sprzedaje ci „wdrożenie llms.txt” jako sposób na polecenia w ChatGPT, przepłacasz. W moich logach to plik dla audytorów, nie dla modeli. Godzina pracy nad stroną z ceną, datą i odpowiedzią w pierwszym akapicie da więcej niż ten plik.
Z logów wynika, co działa naprawdę:
- Wpuść właściwe boty. OAI-SearchBot i PerplexityBot odpowiadają za obecność w wyszukiwarkach czatów. Jeśli zablokujesz je w robots.txt albo w zaporze hostingu, wypadasz z ich indeksu. GPTBot (trening) to osobna decyzja.
- Szybka strona bez blokad. ChatGPT-User wchodzi na żądanie, w trakcie rozmowy. Strona, która odpowiada wolno albo pokazuje ekran weryfikacji „czy jesteś człowiekiem”, po prostu nie trafi do odpowiedzi.
- Konkret, który się zmienia. Strony, po które czat sięgał najczęściej, odpowiadają na pytanie o termin, cenę albo różnicę między planami. Takiej wiedzy model nie ma w pamięci, więc musi ją pobrać.
- Mierz, zamiast zgadywać. Logi serwera są darmowe i pokazują, które podstrony czytają boty i na prośbę użytkowników.
Jak sprawdzić to u siebie
Potrzebujesz surowych logów dostępu z hostingu. W panelu zwykle są w katalogu logs albo do pobrania jako archiwa. Trzy komendy wystarczą na początek:
# 1. kto pobiera llms.txt (adres, data, podpis)
zcat access.log.gz | grep '"GET /llms' | awk '{print $1, $4, $NF}'

# 2. ile zapytań do całej strony mają boty AI
zcat access.log.gz | grep -c 'OAI-SearchBot'
zcat access.log.gz | grep -c 'ChatGPT-User'

# 3. które podstrony czyta ChatGPT na prośbę użytkowników
zcat access.log.gz | grep 'ChatGPT-User' | awk '{print $7}' | sort | uniq -c | sort -rn | head -20
Na koniec porównaj adresy IP z listami OpenAI (pliki chatgpt-user.json, searchbot.json i gptbot.json na openai.com) i Perplexity. Bez tego kroku policzysz też skanery, tak jak ja w pierwszym przebiegu.
Taki pomiar to pierwszy krok w moim kursie GEO: firma, którą poleca ChatGPT. Ma 29 lekcji: od zestawu pytań, które zadają klienci danej branży, przez sprawdzenie, czy boty AI w ogóle mają dostęp do strony, po raport dla klienta. Kurs jest też w paczce kombAIn razem z 27 innymi kursami z PROMPTOWY LAB. Przegląd innych kursów jest w zestawieniu kursy AI, a samo pojęcie wyjaśniam w słowniku: GEO.
Czytasz Promptowego częściej? Dodaj go do preferowanych źródeł w Google, a nowe teksty będą wyżej w Twoich wynikach.
Źródła i data sprawdzenia
Logi i pliki sprawdzone 6.11.2026.
- Logi dostępu serwera promptowy.com, 24.10-5.11.2026 (1 832 096 zapytań), analiza własna
- promptowy.com/llms.txt - 230 linii, 43 304 bajty, 170 linków
- llmstxt.org - propozycja llms.txt, Jeremy Howard, 3.09.2024
- Google Search Central - poradnik optymalizacji pod wyszukiwanie AI (fragment o llms.txt)
- OpenAI - opis botów OAI-SearchBot, GPTBot i ChatGPT-User oraz listy adresów IP
- Perplexity - opis PerplexityBot i Perplexity-User
- Anthropic - boty ClaudeBot, Claude-User i Claude-SearchBot
- Search Engine Roundtable, 24.07.2025 - Gary Illyes: Google nie obsługuje llms.txt
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →- przelomowy.plModele AI domyślają się, że ktoś czyta ich rozumowanie. Preprint testuje 5 modeli
- generatornia.plList do świętego mikołaja szablon AI: wzory i prompty do druku
- jutropis.plUstawa o AI podpisana. Skargi do KRiBSI i testy dla firm
- przewagi.plAgent AI w małej firmie w 2026: co zrobi sam, ile kosztuje (od 14 900 zł netto) i gdzie potrzebny jest człowiek

 artykuły·AI bez cenzury? Zadałem 9 modelom 16 trudnych pytańLeki, wytrych, scena zabójstwa, marihuana, Goebbels i wybór premiera: 16 pytań, 9 modeli, 135 ocenionych odpowiedzi. Blokada pojawiła się naprawdę tylko w jednym temacie.