Hangar 0.3: polski lektor, klonowanie głosu, napisy SRT i wokal na własnym komputerze
Nowa wersja mojej darmowej aplikacji do lokalnych modeli AI: polski lektor i klon głosu, napisy SRT, separacja wokalu i 8 nowych modeli. Z czasami z RTX 4090.
👁 118 przeczytań
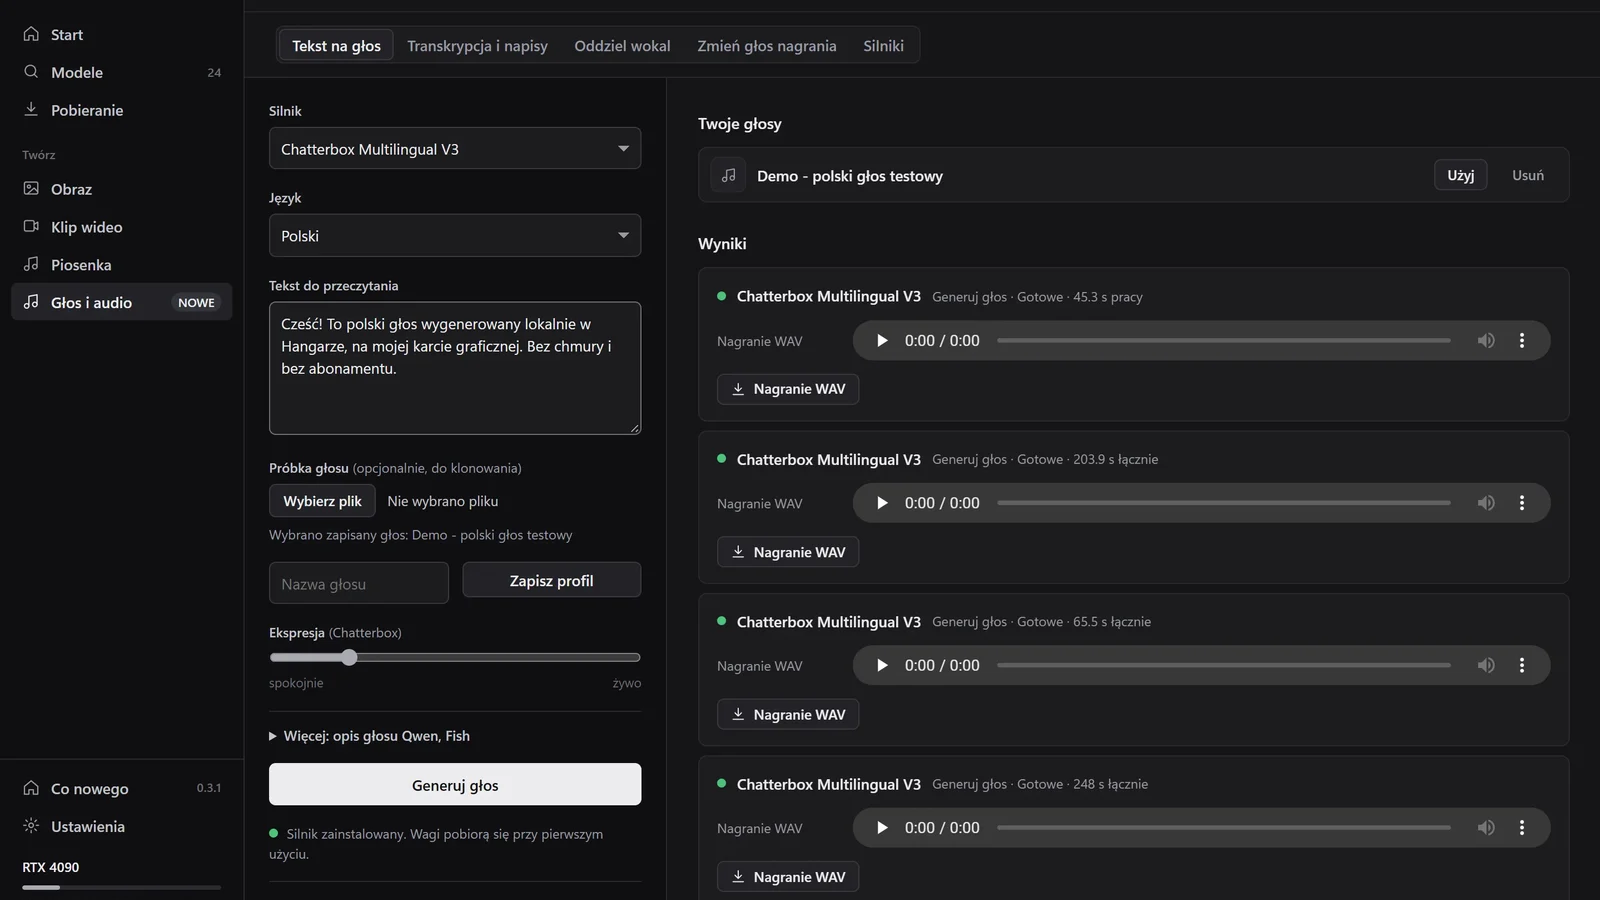
Hangar, moja darmowa aplikacja do lokalnych modeli AI na Windowsie, dostał w wersji 0.3 głos. Nowa zakładka Głos i audio czyta polski tekst i klonuje głos z twojej próbki w Chatterbox Multilingual V3. Robi napisy SRT z nagrania w Whisperze, oddziela wokal od podkładu w UVR i zmienia barwę głosu w RVC. Wszystko działa na twoim komputerze, bez wysyłania nagrań do chmury.
Dziś wyszła wersja 0.3.2, która porządkuje wygląd studia głosu. Poniżej opisuję, co doszło w 0.3, z prawdziwymi czasami z mojej karty RTX 4090.
Hangar 0.3 w skrócie
- Wersja: 0.3.2 z 3 listopada 2026 roku, Windows 10 i 11 (64-bit), karta NVIDIA z CUDA
- Polski lektor i klonowanie głosu: Chatterbox Multilingual V3, licencja MIT, także komercyjnie
- Głos z opisu: Qwen3-TTS VoiceDesign i Base. 10 języków, bez polskiego.
- Napisy i transkrypcja: Whisper large-v3-turbo i WhisperX, eksport TXT, SRT i JSON. Działa też na procesorze.
- Wokal i podkład: UVR rozdziela utwór, RVC zmienia barwę głosu twoim modelem .pth
- Fish Audio: łącznik do osobnego serwera, S2-Pro tylko niekomercyjnie
- Katalog: 23 modele plus podgląd TAESDXL
- Cena: 0 zł
Pobierz Hangar 0.3.2 dla Windows · strona aplikacji i lista modeli
Polski lektor i klonowanie głosu
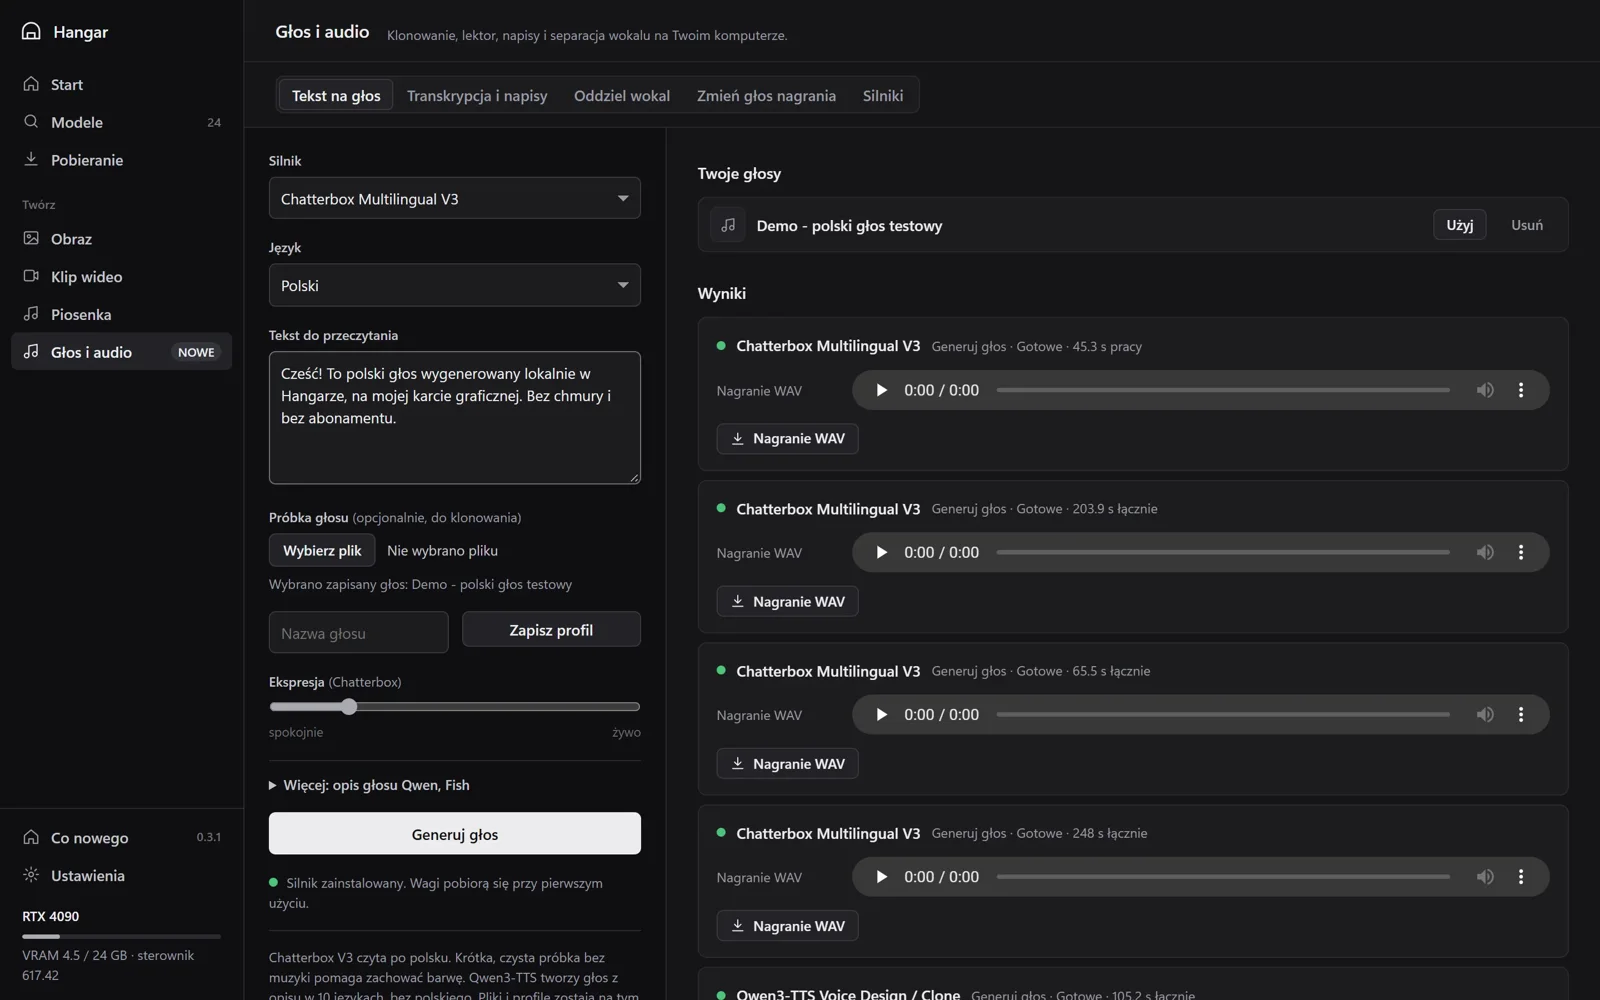
Wpisujesz tekst, wybierasz język i dodajesz próbkę głosu. Chatterbox Multilingual V3 od Resemble AI czyta tekst tą barwą. Próbkę zapisujesz jako profil, więc nie wgrywasz jej przy każdym zadaniu. Wynik odsłuchujesz w aplikacji i pobierasz jako WAV.
Posłuchaj próbki z mojego testu:
- Czas na RTX 4090: 45,3 s pracy razem z ładowaniem modelu
- Rozmiar modelu: 3,0 GB
- Pamięć karty: około 6 GB VRAM
- Licencja: MIT, także komercyjnie
Klonuj tylko swój głos albo głos osoby, która się na to zgodziła. Głos jest w Polsce dobrem osobistym, a klon cudzego głosu bez zgody może skończyć się pozwem.
Głos z opisu: Qwen3-TTS
Qwen3-TTS od Alibaby ma dwa warianty. VoiceDesign tworzy głos z opisu, na przykład „spokojny męski głos lektora, lekko zachrypnięty”. Base klonuje głos z próbki. Oba obsługują 10 języków, ale polskiego wśród nich nie ma. Przyda się, jeśli robisz materiały po angielsku, niemiecku albo w innym z tych języków. Każdy wariant zajmuje 4,2 GB i potrzebuje około 6 GB VRAM. Licencja to Apache 2.0, także komercyjnie.
Napisy SRT i transkrypcja
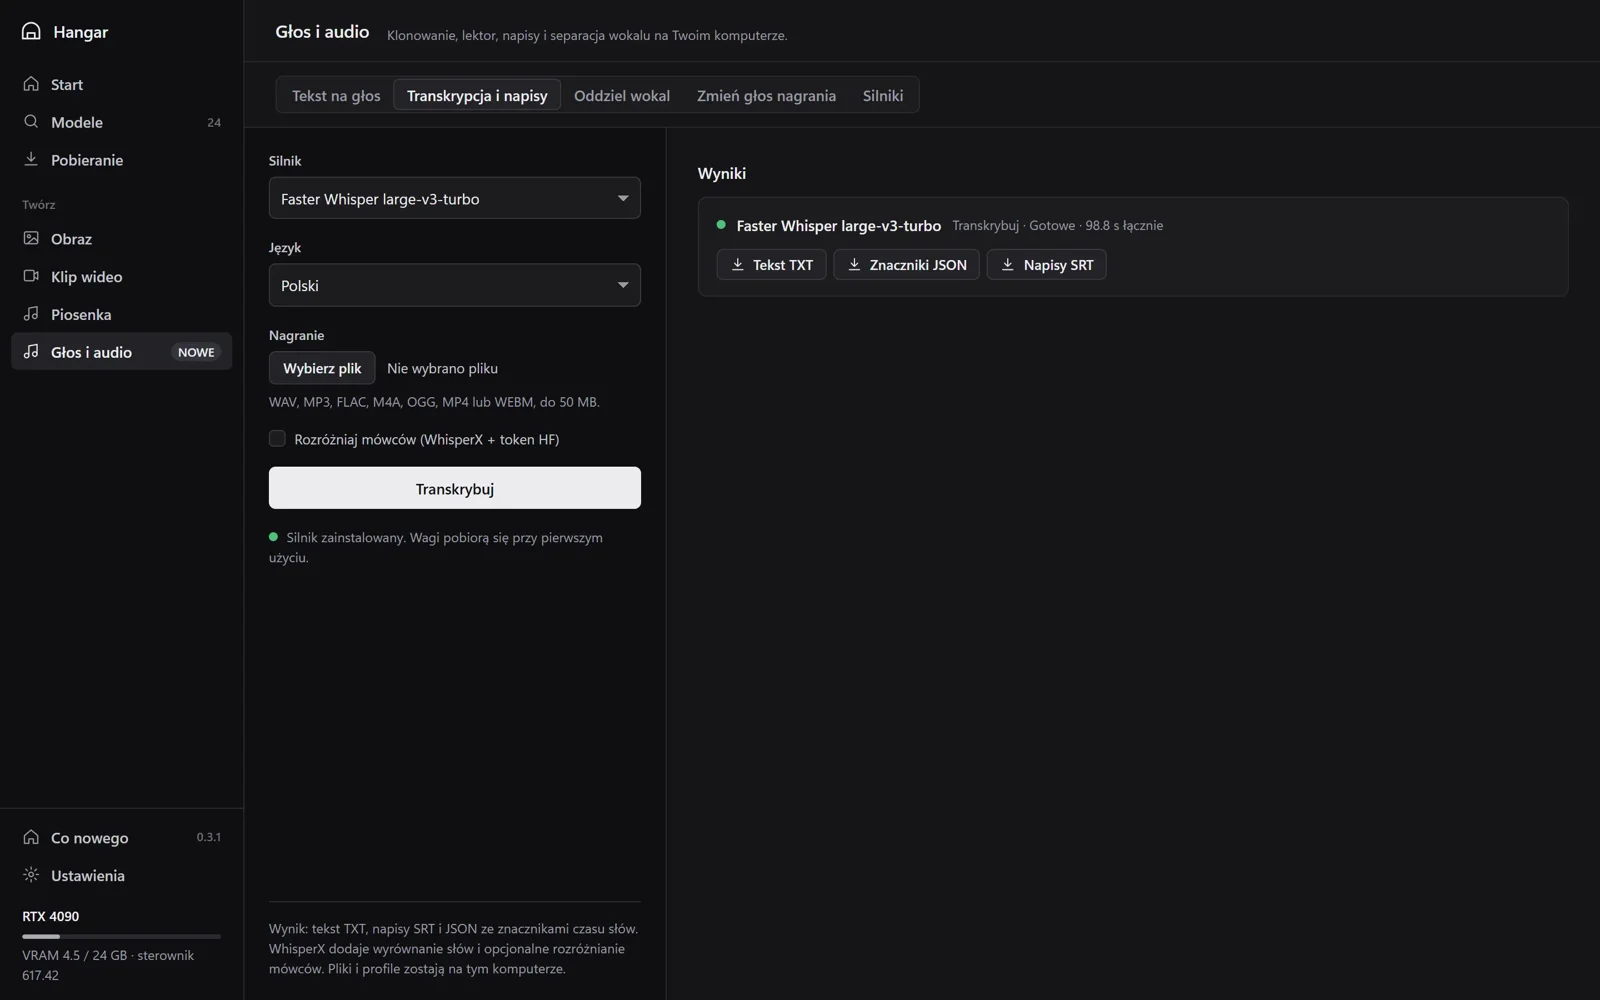
Nowa zakładka Transkrypcja i napisy. Wybierasz Whisper albo WhisperX, język i plik. Dostajesz tekst w TXT, napisy SRT do filmu i JSON ze znacznikami czasu słów. WhisperX dodatkowo wyrównuje słowa i może rozróżniać mówców, ale do tego potrzebny jest token Hugging Face.
Whisper large-v3-turbo zajmuje 1,5 GB i potrzebuje około 2 GB VRAM. Działa też na samym procesorze, wolniej. Jak robiłem napisy Whisperem bez Hangara, ze skryptem, opisałem w tekście napisy do filmu za darmo.
Wokal, podkład i zmiana głosu
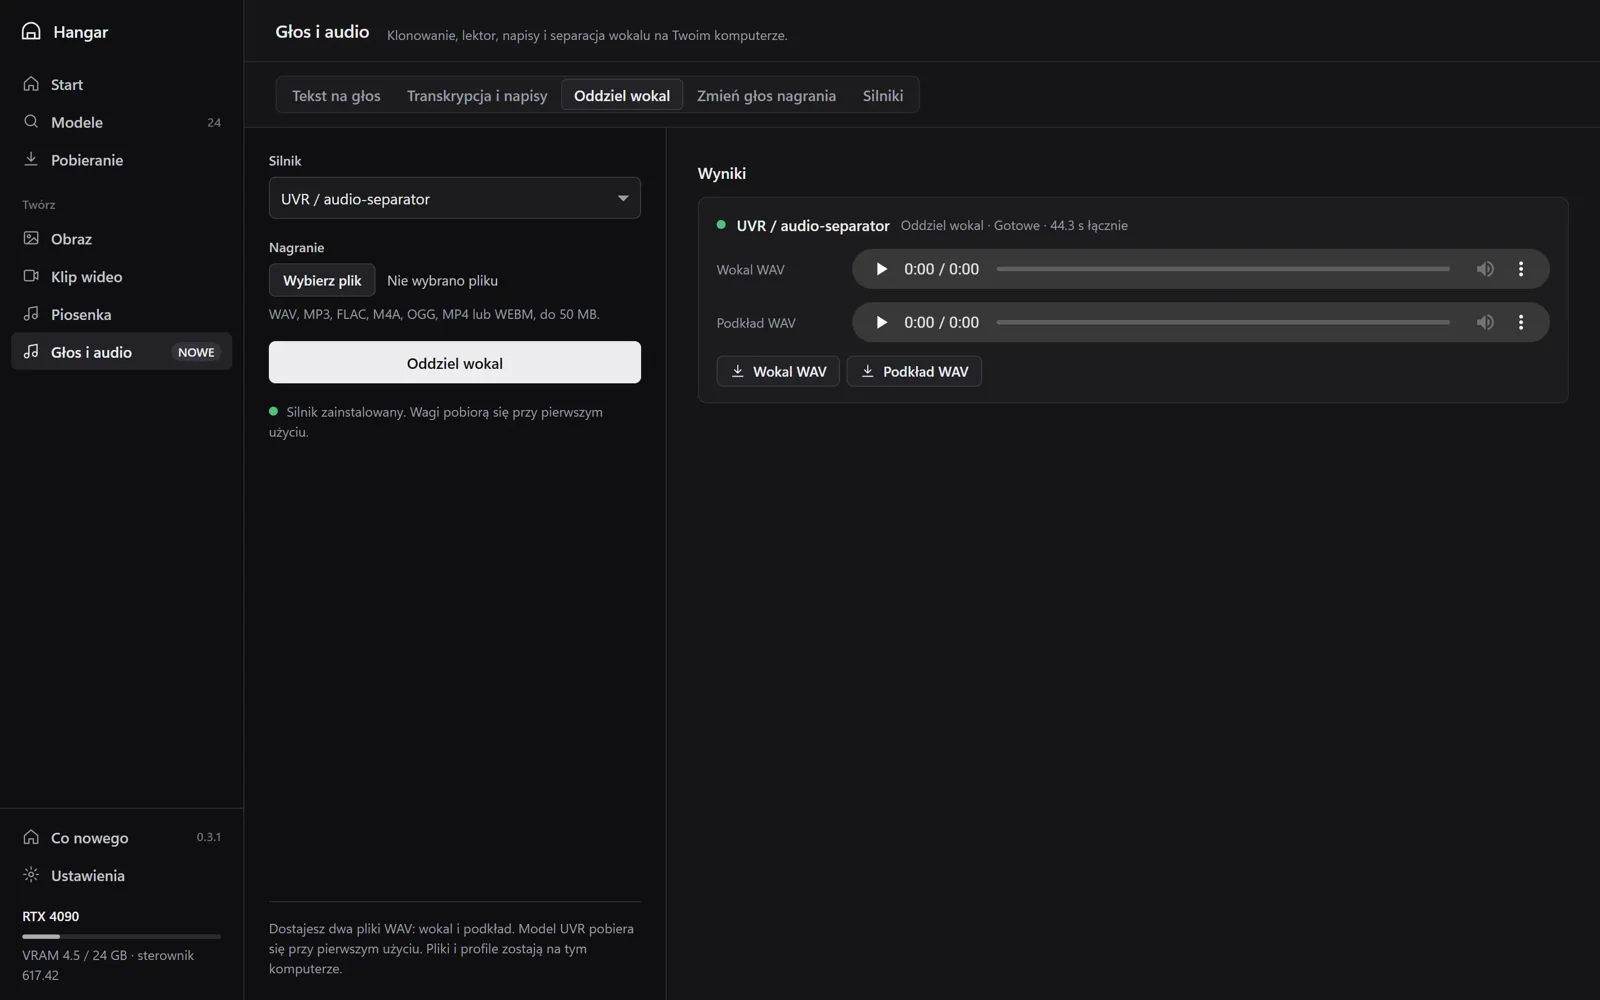
- UVR rozdziela utwór na wokal i podkład. W moim teście zajęło to 44,3 s łącznie, razem z pobraniem modelu.
- RVC zmienia barwę istniejącego nagrania mowy albo śpiewu. Potrzebujesz własnego modelu głosu w pliku .pth. Hangar go nie trenuje, tylko używa.
Usuwanie wokalu w płatnej usłudze online porównywałem w tekście usuwanie wokalu z piosenki. Hangar robi to samo lokalnie i za darmo.
Silniki i Fish Audio
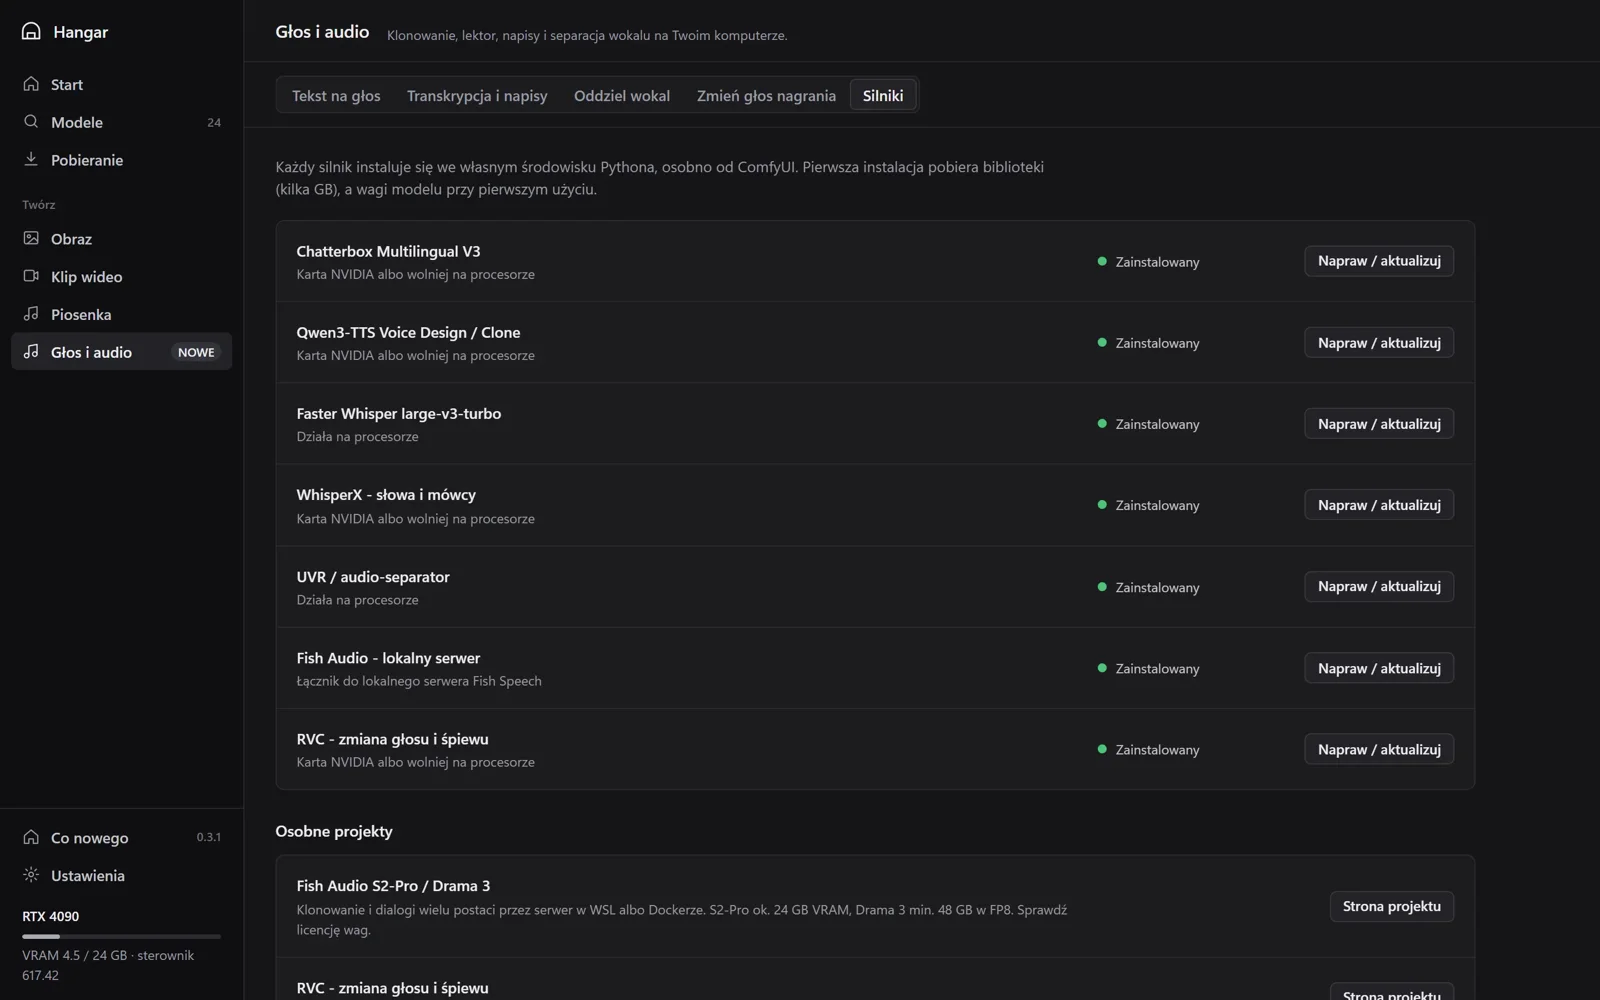
Każdy silnik audio instaluje się z aplikacji, w osobnym środowisku Python, więc nie miesza się z twoim ComfyUI. Fish Audio ma tylko łącznik do osobnego lokalnego serwera Fish Speech w WSL albo Dockerze. Uwaga na wymagania i licencje:
- Fish Audio S2-Pro: 10,3 GB, autor podaje co najmniej 24 GB VRAM, licencja badawcza, tylko niekomercyjnie
- Fish Audio Drama 3: 38,7 GB, co najmniej 48 GB VRAM w FP8, nie mieści się na RTX 4090. Komercyjnie tylko na warunkach autora.
Nowe modele obrazu i wideo
- Z-Image BASE: licencja Apache 2.0, obraz w 51 s na RTX 4090
- LTX-2.5 Distilled: graf sprawdzony, pełnego testu generowania jeszcze nie zrobiłem
Dla porównania czasy innych modeli z katalogu na tej samej karcie: Z-Image Turbo 59 s, SDXL 28 s, Wan 2.2 105 s, ACE-Step 32 s, Stable Audio 3 24 s.
Co zmienia 0.3.2
- zakładka Głos i audio ma ten sam układ co Obraz i Piosenka: ustawienia po lewej, wyniki po prawej
- spójne kolory stanów: zielona kropka oznacza gotowe, bursztynowa w toku, czerwona błąd
- odsłuchiwany wynik nie przerywa się już co dwie sekundy
- funkcje, silniki i wymagania bez zmian względem 0.3.1
Czytasz Promptowego częściej? Dodaj go do preferowanych źródeł w Google, a nowe teksty będą wyżej w Twoich wynikach.
Jak zaktualizować
Pobierz nowy instalator i uruchom go. Hangar nie rusza węzłów ani workflowów w twoim ComfyUI. Windows może pokazać ostrzeżenie SmartScreen, bo instalator nie ma jeszcze podpisu cyfrowego. Kliknij wtedy „Więcej informacji” i „Uruchom mimo to”. Sumę sha256 instalatora sprawdzisz na stronie Hangara.
Cały poradnik, od instalacji po pierwszy obraz, klip, piosenkę i głos, jest w tekście Hangar: darmowe lokalne modele AI na Windowsie. Przegląd wszystkich lokalnych narzędzi głosowych zebrałem w hubie lokalny głos AI.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →- dygot.plAktorka, której nie ma, dostaje główną rolę. Polski lektor walczy w sądzie o swój głos
- generatornia.plLektor AI po polsku: test 3 głosów na „chrząszczu” i „źdźble”, za darmo i płatnie
- dobieracz.plNajlepsze AI do napisów do filmów - Submagic, CapCut, Filmora i trzy inne
- przewagi.plAgent AI w małej firmie w 2026: co zrobi sam, ile kosztuje (od 14 900 zł netto) i gdzie potrzebny jest człowiek
