Napisy do filmu za darmo: Whisper lokalnie, skrypt i Subtitle Edit
Generator napisów na własnym komputerze: Whisper large-v3 i turbo na 42-minutowym „Latarniku”, 3,3-4,0% błędnych słów, gotowy skrypt napisy.py, klatka i wideo z wynikiem oraz Subtitle Edit dla tych, którzy wolą okienka.
👁 122 przeczytań
- Model Whisper large-v3-turbo zrobił napisy z 42-minutowego "Latarnika" w 53 s z błędem 4,0%, a large-v3 w 173 s z błędem 3,3%.
- Pułapka instalacyjna: biblioteka PyAV 19 (od 29 września 2026) nie działa z faster-whisper 1.2.1, dlatego trzeba instalować wersję av
- Whisper automatycznie uwspółcześnia XIX-wieczną polszczyznę, zamieniając np. "tedy" na "wtedy", a liczby słowne na cyfry, co wymaga ręcznej korekty.
Napisy do filmu zrobisz za darmo i bez wysyłania nagrania w sieć: model Whisper rozpozna mowę na Twoim komputerze, a krótki skrypt podzieli tekst na napisy i zapisze plik SRT. Sprawdziłem to na 42-minutowym audiobooku „Latarnika” z Wolnych Lektur: na karcie RTX 4090 model large-v3-turbo zrobił napisy w 53 s z 4,0% błędnych słów, a dokładniejszy large-v3 w 173 s z 3,3% błędów. Poniżej gotowy skrypt, wynik na klatce i wideo oraz lista rzeczy, które i tak trzeba poprawić ręcznie. To część serii o lokalnym AI.
Stan na 17 października 2026
- Silnik: faster-whisper 1.2.1 (MIT) z modelami Whisper large-v3 i large-v3-turbo (MIT, także komercyjnie). Działa offline po jednorazowym pobraniu modelu (1,6-3 GB).
- Pułapka: biblioteka PyAV 19 (od 29 września 2026) nie działa z faster-whisper 1.2.1, instaluj
"av<19". - Bez wiersza poleceń: Subtitle Edit 5.3.0 (14 października 2026, darmowy, MIT) ma wbudowane rozpoznawanie mowy Whisperem.
- Mój test: 3 i 17 października 2026, 41 min 47 s prozy czytanej przez lektora, dwa modele, czas, pamięć karty i zgodność słów z tekstem książki.
- Skrypt
napisy.py(MIT) dzieli tekst według zasad telewizyjnych: do 42 znaków w wierszu, maks. 2 wiersze, 1-6 s na napis.
Czym różnią się napisy od transkrypcji
Transkrypcja to ciągły tekst. Napisy to ten sam tekst pocięty na kawałki z czasem wyświetlania, w formacie, który rozumie odtwarzacz albo serwis (SRT, VTT). Whisper sam podaje czas fragmentów, ale jego fragmenty bywają za długie na ekran: mają po 20-30 słów i po kilkanaście sekund. Dlatego skrypt korzysta z czasu każdego słowa i składa napisy od nowa. O samej transkrypcji i wyborze modelu pisałem w tekście Whisper, a darmowe usługi online porównałem w zestawieniu transkrypcja po polsku za darmo.
Najprościej: Subtitle Edit z Whisperem
Jeśli nie chcesz pracować w wierszu poleceń, darmowy edytor Subtitle Edit (Windows, macOS, Linux) działa jak generator napisów: w menu Video → Speech to text wybierasz silnik, język i model, a program sam pobiera to, czego potrzebuje. Według dokumentacji obsługuje m.in. silniki Whisper CPP, Purfview Faster Whisper XXL, Whisper CTranslate2, Whisper Const-me i WhisperX, z kartą Nvidii albo na procesorze, także seriami plików. Gotowe napisy od razu poprawiasz w tym samym oknie, z podglądem wideo. Tę drogę opisuję według dokumentacji, w moim teście używałem skryptu poniżej, bo daje pełną kontrolę nad podziałem napisów.
Jak zrobić napisy skryptem: krok po kroku
- Zainstaluj Pythona 3.12 lub 3.13 z python.org (zaznacz „Add to PATH”) i ffmpeg:
winget install Gyan.FFmpeg. - W wierszu poleceń:
pip install faster-whisper "av<19". Na karcie Nvidii doinstaluj biblioteki CUDA:pip install nvidia-cublas-cu12 nvidia-cudnn-cu12(skrypt sam je znajdzie, podobnie jak biblioteki PyTorcha, jeśli go masz). - Zapisz skrypt
napisy.py(pełny kod niżej) w folderze z filmem. - Uruchom:
python napisy.py film.mp4. Obok filmu pojawi sięfilm.srt. Szybszy model:--model large-v3-turbo. - Nazwiska i trudne słowa podpowiedz modelowi:
--slowa "Skawiński, Falconbridge". - Chcesz napisy na stałe w obrazie (np. do rolek)? Dodaj
--wypal, a skrypt zrobifilm_napisy.mp4. - Przejrzyj SRT w edytorze napisów (np. Subtitle Edit) i popraw to, co opisuję w sekcji o błędach.
Bez karty graficznej dodaj --cpu: model działa wtedy na procesorze w trybie int8, wyraźnie wolniej (liczby w pytaniach na końcu).
Mój test: „Latarnik” z Wolnych Lektur
Nagranie: Henryk Sienkiewicz, „Latarnik”, czyta Jan Peszek, 41 min 47 s, MP3 64 kb/s, Wolne Lektury (tekst w domenie publicznej, nagranie na licencji CC BY-SA 3.0). Wzorcem był tekst książki z tej samej strony, 4695 słów. Ustawienia: język polski, beam 5, VAD włączony, condition_on_previous_text=False, czasy słów włączone, podpowiedź z czterema nazwami własnymi. Pełne przebiegi powtórzyłem 17 października; zgodność słów wyszła identyczna jak 3 października.
| large-v3-turbo | large-v3 | |
|---|---|---|
| Błędne słowa (WER) | 4,0% (189) | 3,3% (155) |
| Rozpoznanie 41,8 min (17.10) | 53 s | 173 s |
| Czyste 10 min (3.10) | 8,0 s | 27,7 s |
| Pamięć karty | 2,2-2,7 GB | 4,1-4,6 GB |
| Napisów w pliku SRT | 610 | 607 |
| Napisy szybsze niż 17 znaków/s | 32 | 16 |
Co z tego wynika:
- Turbo jest ok. 3 razy szybszy i myli się tylko trochę częściej. Do większości filmów to rozsądny wybór, a godzina nagrania to ok. 1,3 minuty czekania.
- large-v3 wygrywa tam, gdzie liczy się kompletność. Ma mniej błędów, mniej za szybkich napisów i nie zgubił fragmentu, który turbo pominął (opis niżej).
- Czasy wahają się między przebiegami. 3 października pełny przebieg turbo trwał 34 s, 17 października 53 s, bo na komputerze działały wtedy inne zadania. Pomiar 10 minut z 3 października robiłem bez innych obciążeń.
- Dysk ma znaczenie przy pierwszym uruchomieniu. Wczytanie large-v3 z wolnego dysku USB trwało 76 s, z dysku NVMe 3,0 s.
- Format się zgadza: średnio 3,8-3,9 s na napis, 12,8-13,3 znaku na sekundę, tylko 2 wiersze na ponad 600 napisów przekroczyły 42 znaki (o 2 znaki).
Jak wygląda wynik
Fragment pliku SRT z modelu large-v3 (minuta 3:49):
57
00:03:49,880 --> 00:03:54,100
ale sądząc z niebieskich oczu
nie należał do ludzi południa.

58
00:03:54,100 --> 00:03:58,060
Twarz jego była przygnębiona
i smutna, ale uczciwa.

59
00:03:58,440 --> 00:04:01,700
Na pierwszy rzut oka podobał
się Falcon Bridge 'owi.

60
00:04:02,640 --> 00:04:08,000
Pozostało go tylko wyegzaminować, wskutek
czego wywiązała się następująca rozmowa.

61
00:04:08,000 --> 00:04:10,000
- Skąd jesteście?
Ten sam fragment puściłem jako film: tło to 5-sekundowy klip latarni w burzy, który wygenerowałem lokalnie modelem Kandinsky 6 Lite, pod nim nagranie, a napisy wypalił skrypt z opcją --wypal (model turbo).
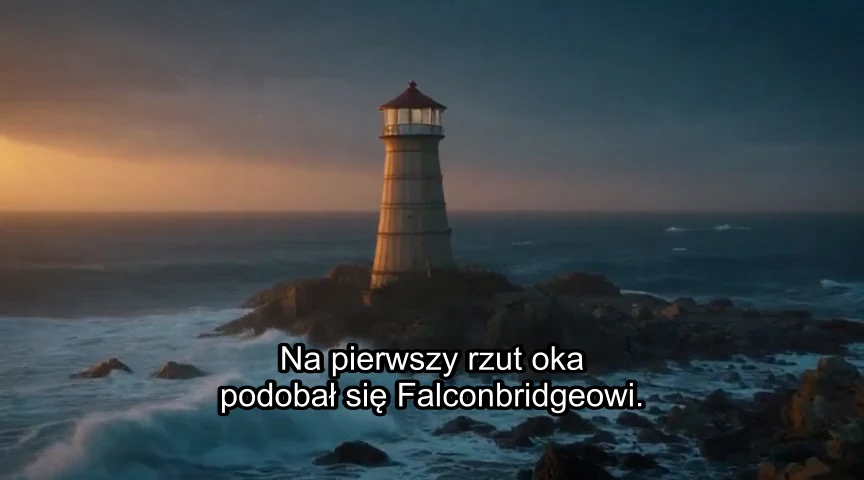
Na krótkim fragmencie turbo zapisał „Falconbridgeowi” poprawnie, ale połączył w jeden napis dwie kwestie różnych osób („Jestem Polak. Coście robili dotąd?”) i zgubił myślniki dialogowe. Przy rozmowach to częsty kłopot: Whisper nie wie, kto mówi.
Czego Whisper nie zrobi za Ciebie
Porównałem oba pliki SRT słowo po słowie z tekstem książki. Błędy układają się w kilka powtarzalnych grup:
- Obce nazwy własne, mimo podpowiedzi. „Falconbridge” large-v3 rozbił na „Falcon Bridge” we wszystkich 6 miejscach, turbo w 3. „Aspinwall” oba modele zapisały 9 razy jako „Espinwall”. Polskie nazwisko Skawiński wyszło bezbłędnie we wszystkich 18 wystąpieniach.
- Liczby zamieniane na cyfry. „Dwunastu” staje się „12”, „czterysta” - „400”. Gorzej z „w czterdziestym dziewiątym” (chodzi o 1849 rok): turbo wpisał „W 1949 roku”.
- Uwspółcześnianie języka. Whisper poprawia XIX-wieczną polszczyznę: „tedy” na „wtedy”, „człekiem” na „człowiekiem”. W wywiadzie to zaleta, przy literaturze trzeba to cofnąć.
- Pominięte fragmenty. Turbo w ogóle nie zapisał inwokacji z „Pana Tadeusza” („Panno święta, co jasnej bronisz Częstochowy…”), którą czyta bohater, large-v3 zapisał ją poprawnie. Dziura w napisach to najgorszy rodzaj błędu, bo nie widać jej w pliku, tylko przy oglądaniu.
- Zlepione i rozklejone słowa: „mewy kryły” jako „me wykryły” (turbo), „podzwrotnikowym” jako „pod zwrotnikowym”.
- Za szybkie napisy. Przy szybszej narracji kilka procent napisów przekracza 17 znaków na sekundę, czyli tempo, w którym widz nie nadąża czytać.
Praktyczna rada: przed eksportem przeszukaj plik pod kątem nazw własnych i cyfr. W Subtitle Edit zajmuje to kilka minut na godzinę materiału.
Gotowy skrypt: napisy.py
Skrypt sprawdziłem 3 i 17 października 2026 na Windows 11 z faster-whisper 1.2.1 i RTX 4090; wynik testu powyżej pochodzi właśnie z niego. 17 października uruchomiłem go też w czystym folderze, w nowym środowisku Pythona 3.13 z pakietami z pip: na karcie i na procesorze. Zanim uruchomisz kod z internetu, przeczytaj go. Licencja MIT, możesz go zmieniać i używać w firmie. Pobierz napisy.py.
"""
napisy.py - napisy SRT po polsku z dowolnego nagrania lub filmu, lokalnie (faster-whisper).
Autor: Piotr Olszewski, promptowy.com. Licencja: MIT. Sprawdzone 3.10 i 17.10.2026: faster-whisper 1.2.1, Python 3.13, RTX 4090, Windows 11.

Instalacja (raz):
  pip install faster-whisper "av<19"                     (PyAV 19 z 29.09.2026 psuje faster-whisper 1.2.1)
  pip install nvidia-cublas-cu12 nvidia-cudnn-cu12       (tylko karta Nvidia)
  winget install Gyan.FFmpeg                             (tylko do --wypal)

Użycie:
  python napisy.py film.mp4                      -> film.srt obok pliku
  python napisy.py film.mp4 --model large-v3-turbo
  python napisy.py film.mp4 --wypal              -> dodatkowo film_napisy.mp4 z napisami na obrazie (ffmpeg)
  python napisy.py film.mp4 --cpu                -> bez karty graficznej (wolniej, model int8)

Zasady podziału (jak w telewizji i na Netfliksie): maks. 42 znaki w wierszu, maks. 2 wiersze,
napis od 1 do 6 sekund, cięcie najchętniej po kropce, przecinku albo przed spójnikiem.
"""
import argparse, os, sys, subprocess, time, json

ZN_W_WIERSZU, MAX_WIERSZY, MAX_CZAS, MIN_CZAS = 42, 2, 6.0, 1.0
SPOJNIKI = {'i', 'a', 'ale', 'że', 'bo', 'lecz', 'oraz', 'albo', 'czy', 'gdy', 'kiedy', 'który', 'która', 'które', 'więc', 'jednak'}

def cuda_dll():
    # Na Windowsie faster-whisper potrzebuje cuBLAS i cuDNN. Szukamy ich w pakietach pip nvidia-*-cu12
    # (pip install nvidia-cublas-cu12 nvidia-cudnn-cu12) albo w bibliotekach PyTorcha, jeśli jest zainstalowany.
    import glob, site
    katalogi = []
    for sp in site.getsitepackages() + [site.getusersitepackages()]:
        katalogi += glob.glob(os.path.join(sp, 'nvidia', '*', 'bin'))
        katalogi += glob.glob(os.path.join(sp, 'torch', 'lib'))
    for lib in katalogi:
        if os.path.isdir(lib):
            try:
                os.add_dll_directory(lib)
            except (OSError, AttributeError):
                pass
            os.environ['PATH'] = lib + os.pathsep + os.environ['PATH']

def t_srt(t):
    ms = int(round(t * 1000)); g, ms = divmod(ms, 3600000); m, ms = divmod(ms, 60000); s, ms = divmod(ms, 1000)
    return f'{g:02d}:{m:02d}:{s:02d},{ms:03d}'

def zawin(slowa):
    """Dzieli listę słów na maks. 2 wiersze, najlepiej w połowie i nie przed krótkim słowem."""
    tekst = ' '.join(slowa)
    if len(tekst) <= ZN_W_WIERSZU: return tekst
    best, bi = 1e9, 1
    for i in range(1, len(slowa)):
        a, b = ' '.join(slowa[:i]), ' '.join(slowa[i:])
        # wiersz dłuższy niż 42 znaki to duża kara, ale nie wykluczenie (inaczej przy długim słowie podział się psuje)
        kara = 1000 * max(0, max(len(a), len(b)) - ZN_W_WIERSZU) + abs(len(a) - len(b)) + (15 if len(slowa[i-1]) <= 2 else 0) - (10 if slowa[i-1][-1] in ',.;:?!' else 0)
        if kara < best: best, bi = kara, i
    return ' '.join(slowa[:bi]) + '\n' + ' '.join(slowa[bi:])

def bloki(words):
    """Grupuje słowa (z czasami) w napisy."""
    out, cur = [], []
    def zamknij():
        if cur: out.append([cur[0][0], cur[-1][1], [w for _, _, w in cur]]); cur.clear()
    for (a, b, w) in words:
        if cur:
            tekst = ' '.join(x[2] for x in cur + [(a, b, w)])
            za_dlugo = len(tekst) > ZN_W_WIERSZU * MAX_WIERSZY - 6 or (b - cur[0][0]) > MAX_CZAS
            pauza = a - cur[-1][1] > 0.8
            if za_dlugo or pauza:
                # cofnij się do ostatniego dobrego miejsca cięcia (interpunkcja albo przed spójnikiem)
                cut = None
                for j in range(len(cur) - 1, 0, -1):
                    if cur[j-1][2][-1] in ',.;:?!' or cur[j][2].lower().strip(',.') in SPOJNIKI:
                        cut = j; break
                if za_dlugo and cut and cut >= len(cur) // 2:
                    reszta = cur[cut:]; del cur[cut:]; zamknij(); cur.extend(reszta)
                else:
                    zamknij()
        cur.append((a, b, w))
        if w[-1] in '.?!' and (cur[-1][1] - cur[0][0]) >= 1.5:
            zamknij()
    zamknij()
    # minimalny czas wyświetlania, bez nachodzenia na następny napis
    for i, n in enumerate(out):
        if n[1] - n[0] < MIN_CZAS:
            nast = out[i+1][0] - 0.05 if i + 1 < len(out) else n[0] + MIN_CZAS
            n[1] = max(n[1], min(n[0] + MIN_CZAS, nast))
    return out

def main():
    ap = argparse.ArgumentParser(description='Napisy SRT po polsku lokalnie (faster-whisper)')
    ap.add_argument('plik'); ap.add_argument('--model', default='large-v3')
    ap.add_argument('--jezyk', default='pl'); ap.add_argument('--cpu', action='store_true')
    ap.add_argument('--wypal', action='store_true', help='wypal napisy w obraz (wymaga ffmpeg)')
    ap.add_argument('--slowa', default='', help='podpowiedź: nazwiska i trudne słowa, np. "Falconbridge, Skawiński"')
    x = ap.parse_args()
    if not x.cpu: cuda_dll()
    from faster_whisper import WhisperModel
    t0 = time.time()
    m = WhisperModel(x.model, device='cpu' if x.cpu else 'cuda', compute_type='int8' if x.cpu else 'float16')
    t1 = time.time()
    segs, info = m.transcribe(x.plik, language=x.jezyk, beam_size=5, vad_filter=True, word_timestamps=True,
                              condition_on_previous_text=False, initial_prompt=x.slowa or None)
    words = []
    for s in segs:
        for i, w in enumerate(s.words):
            t = w.word.strip()
            if not t: continue
            if words and i > 0 and not w.word.startswith(' '):
                # kawałek bez spacji (np. „.pl”, „-go”) doklejamy do poprzedniego słowa
                a, _, p = words[-1]; words[-1] = (a, w.end, p + t)
            else:
                words.append((w.start, w.end, t))
    t2 = time.time()
    nap = bloki(words)
    srt = os.path.splitext(x.plik)[0] + '.srt'
    with open(srt, 'w', encoding='utf-8') as f:
        for i, (a, b, sl) in enumerate(nap, 1):
            f.write(f'{i}\n{t_srt(a)} --> {t_srt(b)}\n{zawin(sl)}\n\n')
    print(f'Gotowe: {srt} | {len(nap)} napisów | nagranie {info.duration/60:.1f} min | model {x.model} '
          f'wczytany w {t1-t0:.0f} s | rozpoznawanie {t2-t1:.0f} s')
    if x.wypal:
        wyj = os.path.splitext(x.plik)[0] + '_napisy.mp4'
        styl = 'FontName=Arial,FontSize=22,Outline=2,Shadow=0,MarginV=40'
        sciezka = srt.replace(os.sep, '/').replace(':', r'\:')  # ścieżka w formacie filtra ffmpeg
        subprocess.run(['ffmpeg', '-y', '-loglevel', 'error', '-i', x.plik, '-vf', f"subtitles='{sciezka}':force_style='{styl}'",
                        '-c:a', 'copy', wyj], check=True)
        print('Film z napisami:', wyj)

if __name__ == '__main__':
    main()
Lokalnie czy w usłudze online
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
| Whisper lokalnie | Usługi online | |
|---|---|---|
| Koszt | 0 zł, tylko prąd | darmowe limity, potem abonament |
| Prywatność | nagranie zostaje na komputerze | plik idzie na serwer |
| Limit długości | brak | zwykle minuty na plik lub dzień |
| Wygoda | instalacja lub Subtitle Edit | przeciągnij plik w przeglądarce |
Szybsze w obsłudze są narzędzia z montażem w jednym, np. CapCut. Lokalny Whisper wygrywa przy długich nagraniach, materiałach poufnych i dużej liczbie plików. Cały proces poprawiania napisów opisałem w tekście AI do napisów, a lektora do tego samego filmu zrobisz lokalnie według poradnika syntezator mowy. Obraz i wideo wygenerujesz u siebie w Hangarze (moje narzędzie; napisów ani Whispera w nim nie ma).
Najczęstsze pytania
Jak zrobić napisy do filmu za darmo?
Lokalnie: Whisper przez skrypt z tego tekstu albo program Subtitle Edit z wbudowanym rozpoznawaniem mowy. Online: automatyczne napisy YouTube albo darmowe limity usług. Lokalna droga nie ma limitów i nie wysyła pliku w sieć.
Jaki generator napisów wybrać i który model Whisper?
Do większości filmów large-v3-turbo: w moim teście 4,0% błędnych słów i ok. 3 razy szybciej niż large-v3. Gdy liczy się każde zdanie (literatura, dokument, wywiad do publikacji), weź large-v3: 3,3% błędów i nic nie pominął. Mniejsze modele (small, medium) mają sens tylko na słabym sprzęcie.
Czy Subtitle Edit robi automatyczne napisy?
Tak. Subtitle Edit (wersja 5.3.0 z 14 października 2026, za darmo) ma funkcję rozpoznawania mowy w menu Video, z silnikami opartymi na Whisperze. Modele pobiera sam przy pierwszym użyciu, a wynik od razu ląduje w edytorze z podglądem wideo.
Jak dodać napisy SRT do filmu?
Na YouTube wgrywasz SRT w zakładce Napisy. Do odtwarzacza (VLC, MPC) wystarczy, że plik SRT ma tę samą nazwę co film. Na stałe w obrazie wypalisz je ffmpegiem (opcja --wypal w skrypcie).
Czy Whisper działa bez karty graficznej?
Tak, ale wolno. W czystym folderze na procesorze i9-14900KF large-v3-turbo w trybie int8 rozpoznał 30 s nagrania w 23 s, więc godzina materiału to ok. 45-50 minut. Na karcie RTX 4090 ten sam fragment zajął 4 s.
Czy Whisper rozpoznaje, kto mówi?
Nie. Przy rozmowie kilku osób dostaniesz napisy bez oznaczenia mówców, a czasem dwie kwestie w jednym napisie. Do tego potrzebna jest nakładka z diaryzacją, np. WhisperX (dostępny też w Subtitle Edit).
Ile trwa zrobienie napisów do godzinnego filmu?
Na RTX 4090 w moim teście 17 października: ok. 1,3 minuty z large-v3-turbo i ok. 4 minuty z large-v3, do tego kilka sekund na wczytanie modelu. Najwięcej czasu zajmuje i tak poprawianie: nazw własnych, liczb i pominiętych fragmentów.
Źródła i data sprawdzenia
- faster-whisper na GitHubie (MIT).
- Modele: Systran/faster-whisper-large-v3 i mobiuslabsgmbh/faster-whisper-large-v3-turbo.
- PyAV na PyPI (wersja 19.0.0 z 29 września 2026).
- Subtitle Edit, wydania i dokumentacja.
- Nagranie: Wolne Lektury, „Latarnik”, czyta Jan Peszek, CC BY-SA 3.0.
- Pomiary: moje, 3 i 17 października 2026, RTX 4090, i9-14900KF, Windows 11.
Sprawdzone 17 października 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym