Gemma 4 31B lokalnie na RTX 4090: pomiary, VRAM i test po polsku
Model tygodnia na Twoim komputerze #1: Gemma 4 31B w Ollamie na RTX 4090 - czas ładowania, tok/s, VRAM, 5 zadań po polsku i instrukcja.
👁 120 przeczytań
- Gemma 4 31B uruchomiona lokalnie na RTX 4090 generuje 40,7-43,4 tokena na sekundę i uzyskała 9,5 na 10 punktów w testach polszczyzny.
- Model w wersji gemma4:31b-it-qat zajmuje 19,2 GB według Ollamy, a szczytowo blokuje całe 24 GB pamięci karty graficznej.
- Gdy podczas pracy modelu w tle uruchomiło się ComfyUI, prędkość generowania spadła z 42 do 0,5 tokena na sekundę z powodu braku wolnego VRAM.
Gemma 4 31B od Google to najmocniejszy gęsty model z otwartymi wagami, który w całości mieści się na jednej karcie RTX 4090. Uruchomiłem go w Ollamie na swoim komputerze: generuje ok. 42 tokeny na sekundę, po polsku dostał ode mnie 9,5 na 10 punktów, ale zajmuje prawie całe 24 GB pamięci karty i jest bezlitosny dla wolnego dysku. To pierwsze wydanie serii „Model tygodnia na Twoim komputerze”.
Stan na 8 października 2026
- Model:
gemma4:31b-it-qatw Ollamie 0.40.1 (wersja po treningu z kwantyzacją, plik 17,65 GB + 1,2 GB modułu obrazu). - Licencja: Apache 2.0 - wolno używać komercyjnie.
- Szybkość: 40,7-43,4 tok/s generowania, ok. 870-1240 tok/s czytania polecenia.
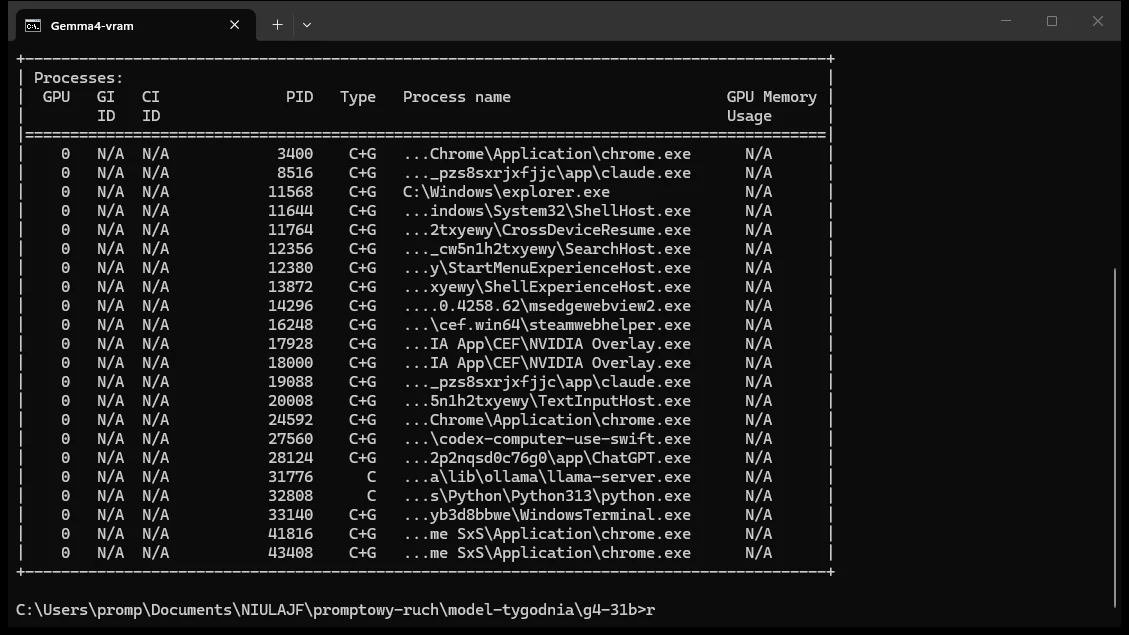
- Pamięć karty: 19,2 GB według Ollamy, cała karta w szczycie 24,0 GB (nvidia-smi).
- Po polsku: 9,5/10 w moich 5 zadaniach.
- Pobranie: 40 min 41 s. Ładowanie z dysku USB: od 1 min 53 s do 14 min 33 s.
Dlaczego Gemma 4 31B na start serii
Co tydzień biorę jeden otwarty model, odpalam go na RTX 4090 (24 GB, Windows 11) i mierzę to samo: instalację, ładowanie, szybkość, pamięć, polszczyznę i licencję. Na pierwszy ogień sprawdziłem świeże kandydatury i większość odpadła:
- Ling 3.1 Flash - ma 560 mld parametrów i na razie nie ma otwartych wag (opisałem go w tekście o Ling 3.1 Flash).
- Mistral Small 4 - mimo nazwy ma 119 mld parametrów; nawet mocno ściśnięty nie mieści się w 24 GB.
- GLM 5.3 - wersji „Air” nie ma, a najmniejszy GLM-5.3 Flash ma 320 mld parametrów.
- Hy Image 3.5 - Tencent udostępnił tylko podgląd przez API, wag brak.
- Qwen 3.8 27B - już testowałem w rankingu 7 lokalnych modeli.
Gemma 4 31B jest na rynku od wiosny, ale na blogu nie było jeszcze pomiaru na prawdziwym sprzęcie. A to największy model Gemmy 4 i jedyny „pełny” (gęsty), który da się uruchomić na jednej karcie dla graczy.
Karta modelu
| Cecha | Gemma 4 31B |
|---|---|
| Producent | Google DeepMind |
| Parametry | 30,7 mld, model gęsty (wszystkie aktywne przy każdym tokenie) |
| Kontekst | do 256 tys. tokenów |
| Wejście | tekst i obraz; wyjście tylko tekst |
| Języki | ponad 140 w treningu, ok. 35 „od ręki” według Google |
| Licencja | Apache 2.0 |
| W Ollamie | gemma4:31b-it-qat (Q4_0, 19 GB), gemma4:31b-it-q8, gemma4:31b-it-bf16 (63 GB) |
| Zalecane ustawienia | temperature 1.0, top_p 0.95, top_k 64 |
Wersja QAT była trenowana z myślą o 4-bitowej kwantyzacji, więc traci mniej jakości niż zwykła „czwórka”. Na 24 GB to jedyny sensowny wybór - wersja q8 ma ponad 30 GB.
Moje pomiary na RTX 4090
| Pomiar | Wynik | Uwagi |
|---|---|---|
| Pobranie (18,2 GB) | 40 min 41 s | prędkość skakała od 4 do 29 MB/s |
| Pierwsze ładowanie | błąd po 5 min | „timed out waiting for llama-server to start” - patrz niżej |
| Ładowanie z dysku USB | 8 min 32 s i 14 min 33 s | dysk D: na USB, ok. 44-66 MB/s |
| Ładowanie z pamięci podręcznej systemu | 1 min 53 s | plik był jeszcze w RAM po poprzednim wczytaniu |
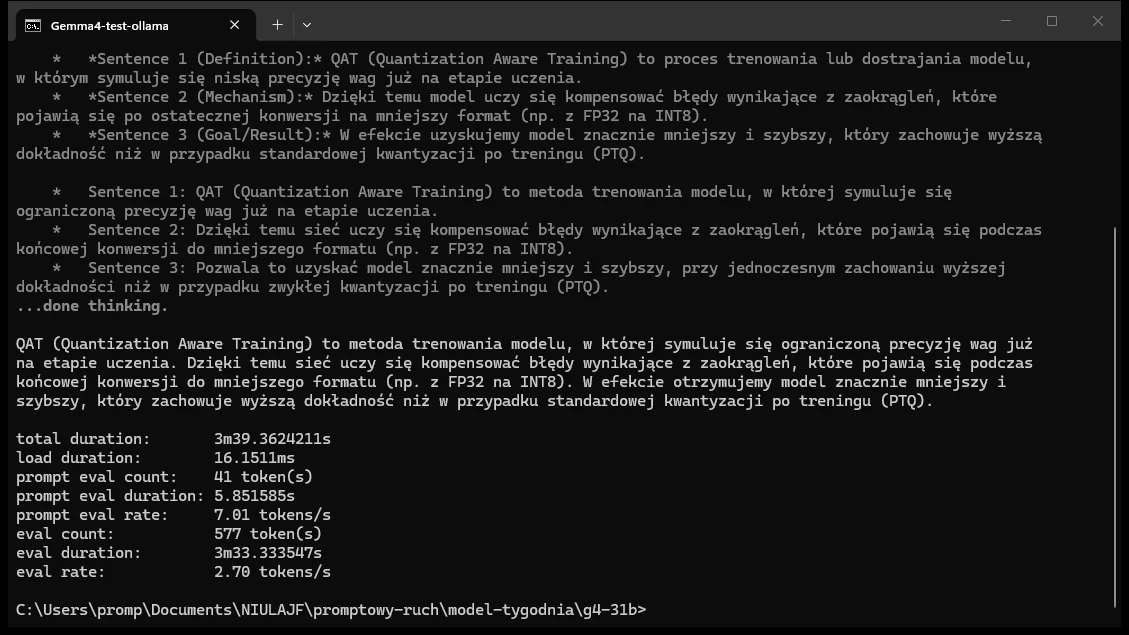
| Generowanie (5 zadań) | 40,7-43,4 tok/s | kontekst 8192, bez trybu myślenia |
| Długi tekst (1438 tokenów) | 41,3 tok/s | ok. 800 słów w 35 s |
| Generowanie przy kontekście 32 768 | 42,2 tok/s | bez spadku szybkości |
| Czytanie polecenia | 870-1240 tok/s | pierwsze zapytanie wolniej (24 tok/s, rozgrzewka) |
| Pamięć karty wg Ollamy | 19,2 GB (8k) / 19,3 GB (32k) | 100% na GPU |
| Cała karta wg nvidia-smi | 21,8 GB po wczytaniu, 24,0 GB w szczycie | razem z pulpitem i przeglądarką (ok. 0,8 GB przed startem) |
41-43 tokeny na sekundę to szybciej, niż czytasz. Dla porównania: w moim teście lokalnych modeli mniejsza Gemma 4 12B robiła 104 tok/s na 8 GB, a Qwen 3.8 27B był mniej więcej dwa razy wolniejszy od niej i zajmował 17 GB. 31B jest więc najwolniejsza z tej trójki, ale wciąż w pełni używalna do rozmowy.
Lekcja tygodnia: nie dziel karty z innym programem
Przy robieniu zrzutów ekranu na tej samej karcie ruszyło w tle generowanie obrazów w ComfyUI. Pamięć karty skończyła się (23,9 z 24 GB), Windows zaczął przerzucać dane do zwykłego RAM-u i szybkość spadła z 42 do 2,7 tok/s, a w kolejnej próbie do 0,5 tok/s. Model 31B nie zostawia zapasu: przy nim nie uruchomisz równolegle generatora obrazów, a nawet przeglądarka z wieloma kartami potrafi zabrać kilkaset MB.
Gemma 4 31B po polsku: 5 zadań
Te same 5 zadań dostanie każdy kolejny model z serii, żeby wyniki dało się porównywać. Każde oceniam w skali 0-2.
| Zadanie | Ocena | Co zauważyłem |
|---|---|---|
| E-mail z przeprosinami (Brzęczyszczykiewicz, Szczebrzeszyn) | 1,5/2 | poprawnie „do Szczebrzeszyna”, rabat 10% z kodem, ale ominął nazwisko („Szanowny Panie Grzegorzu”) |
| Korekta 8+ błędów | 2/2 | wyłapał wszystkie: poszłem, napewno, pójde, nadzieje, wogóle i 5 przecinków |
| Faktura: 3 pozycje, VAT 23% i 5% | 2/2 | VAT 1314,00 zł, brutto 7073,90 zł - zgadza się co do grosza |
| 5 pytań o Polskę | 2/2 | Zielona Góra i Gorzów, Prus, Rysy 2499 m, 1410, 16 województw |
| 3 frazeologizmy z przykładami | 2/2 | trafne znaczenia i naturalne przykłady |
| Razem | 9,5/10 |
Dwie wady formy, nie treści: model lubi markdown (pogrubienia, listy z gwiazdkami) i w korekcie wstawił strzałki w zapisie LaTeX ($\rightarrow$), których w zwykłym czacie nie wyrenderujesz. W trybie myślenia (domyślnym w ollama run) rozumuje po angielsku, a dopiero odpowiedź pisze po polsku.
E-mail z przeprosinami - pełna odpowiedź modelu (185 tokenów, 42,5 tok/s)
Polecenie: Napisz krótki e-mail (do 120 słów) do klienta, pana Grzegorza Brzęczyszczykiewicza ze Szczebrzeszyna, z przeprosinami za 5-dniowe opóźnienie dostawy krzesła biurowego. Zaproponuj rabat 10% na kolejne zamówienie. Ton uprzejmy, bez przesady. Użyj poprawnej odmiany nazwiska i nazwy miejscowości.
Temat: Przeprosiny za opóźnienie w dostawie zamówienia

Szanowny Panie Grzegorzu,

chciałbym najmocniej przeprosić za 5-dniowe opóźnienie w dostawie Pana krzesła biurowego do Szczebrzeszyna. Bardzo nam przykro z powodu zaistniałej sytuacji.

W ramach rekompensaty przygotowaliśmy dla Pana kod rabatowy o wartości 10% na kolejne zamówienie w naszym sklepie: RABAT10.

Mamy nadzieję, że produkt spełni Pana oczekiwania, a ten gest pozwoli nam zachować Pana zaufanie. W razie dodatkowych pytań pozostaję do dyspozycji.

Z poważaniem,

[Twoje Imię i Nazwisko]
[Nazwa Firmy]
Korekta tekstu - pełna odpowiedź modelu (306 tokenów, 40,7 tok/s)
Polecenie: Popraw błędy w tekście i wypisz listę poprawek (każda w osobnym punkcie: było -> jest). Tekst: "Wczoraj poszłem do sklepu żeby kupić chleb, ale okazało się że był zamknięty. W poniedziałek napewno pójde jeszcze raz, bo mam nadzieje że będzie otwarte. Moja koleżanka która tam pracuje mówiła, że wogóle nie zamykają przed 18."
Oto poprawiony tekst:

„Wczoraj poszedłem do sklepu, żeby kupić chleb, ale okazało się, że był zamknięty. W poniedziałek na pewno pójdę jeszcze raz, bo mam nadzieję, że będzie otwarty. Moja koleżanka, która tam pracuje, mówiła, że w ogóle nie zamykają przed 18.”

Lista poprawek:
* poszłem $\rightarrow$ poszedłem (błąd fleksyjny)
* sklepu żeby $\rightarrow$ sklepu, żeby (brak przecinka przed spójnikiem)
* okazało się że $\rightarrow$ okazało się, że (brak przecinka przed spójnikiem)
* napewno $\rightarrow$ na pewno (pisownia rozdzielna)
* pójde $\rightarrow$ pójdę (brak polskiego znaku)
* nadzieje $\rightarrow$ nadzieję (brak polskiego znaku)
* że będzie otwarte $\rightarrow$ że będzie otwarty (błąd składniowy - sklep jest rodzaju męskiego)
* koleżanka która $\rightarrow$ koleżanka, która (brak przecinka przed zdaniem podrzędnym)
* pracuje mówiła $\rightarrow$ pracuje, mówiła (brak przecinka zamykającego zdanie podrzędne)
* wogóle $\rightarrow$ w ogóle (pisownia rozdzielna)
Faktura z VAT - pełna odpowiedź modelu (176 tokenów, 41,4 tok/s)
Polecenie: Policz fakturę. Pozycje netto: laptop 4200,00 zł (VAT 23%), książka 59,90 zł (VAT 5%), usługa szkolenia 1500,00 zł (VAT 23%). Podaj VAT dla każdej pozycji, sumę netto, sumę VAT i sumę brutto. Kwoty zaokrąglaj do grosza. Na końcu jedna linia: BRUTTO = …
Oto wyliczenia dla poszczególnych pozycji:

*   Laptop: netto 4200,00 zł $\rightarrow$ VAT (23%): 966,00 zł
*   Książka: netto 59,90 zł $\rightarrow$ VAT (5%): 3,00 zł
*   Usługa szkolenia: netto 1500,00 zł $\rightarrow$ VAT (23%): 345,00 zł

Suma netto: 5759,90 zł
Suma VAT: 1314,00 zł
Suma brutto: 7073,90 zł

BRUTTO = 7073,90 zł
5 pytań o Polskę - pełna odpowiedź modelu (60 tokenów, 43,4 tok/s)
Polecenie: Odpowiedz krótko na 5 pytań, każde w jednej linii: 1) Jakie miasta są siedzibami władz województwa lubuskiego? 2) Kto napisał "Lalkę"? 3) Jak wysoki jest najwyższy szczyt Polski i jak się nazywa? 4) W którym roku odbyła się bitwa pod Grunwaldem? 5) Ile województw ma Polska?
1) Zielona Góra i Gorzów Wielkopolski.
2) Bolesław Prus.
3) 2499 m n.p.m., Rysy.
4) 1410.
5) 16.
Frazeologizmy - pełna odpowiedź modelu (303 tokenów, 42,0 tok/s)
Polecenie: Wyjaśnij prostym językiem znaczenie trzech polskich frazeologizmów i do każdego podaj jedno zdanie przykładowe: "wyjść jak Zabłocki na mydle", "rzucać grochem o ścianę", "mieć muchy w nosie".
Oto wyjaśnienia tych frazeologizmów napisane prostym językiem:

1. Wyjść jak Zabłocki na mydle
*   Znaczenie: Oznacza ponieść klęskę, sromotnie przegrać lub zostać z niczym, mimo że miało być inaczej (często po tym, jak ktoś wierzył w łatwy zysk).
*   Przykład: *Kupiłem ten tani telefon przez internet, ale okazał się zepsuty i sprzedawca nie chce oddać pieniędzy - wyszedłem jak Zabłocki na mydle.*

2. Rzucać grochem o ścianę
*   Znaczenie: Mówić do kogoś, kto zupełnie nie słucha, nie rozumie lub ignoruje nasze argumenty i prośby.
*   Przykład: *Tłumaczę synowi już godzinę, że musi posprzątać pokój, ale to jak rzucanie grochem o ścianę.*

3. Mieć muchy w nosie
*   Znaczenie: Być w złym humorze bez wyraźnego powodu, być marudnym lub poirytowanym.
*   Przykład: *Nie podchodź teraz do Anny, bo od samego rana ma muchy w nosie i na wszystko się gniewa.*
Licencja: co wolno
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Gemma 4 jest na licencji Apache 2.0. To duża zmiana względem Gemmy 3, która miała własny regulamin Google z listą zakazanych zastosowań. W praktyce:
- możesz używać modelu komercyjnie, także w produkcie dla klientów;
- możesz go dostrajać i rozpowszechniać zmodyfikowane wersje (z zachowaniem informacji o licencji);
- nie płacisz Google za użycie - koszt to tylko prąd i sprzęt.
Instrukcja krok po kroku (polecenia, które naprawdę odpaliłem)
- Zainstaluj Ollamę z ollama.com (ja mam 0.40.1). Jeśli trzymasz modele na innym dysku, ustaw zmienną
OLLAMA_MODELS(u mnieD:\AI\ollama). Szczegóły w poradniku Ollamy. - Pobierz model (ok. 18 GB):
ollama pull gemma4:31b-it-qat
- Jeśli modele leżą na wolnym dysku, wydłuż limit ładowania. Domyślnie Ollama czeka 5 minut, a z mojego dysku USB wczytanie trwało 8-14 minut, więc pierwsza próba skończyła się błędem „timed out waiting for llama-server to start”. W PowerShellu (zamknij najpierw Ollamę w zasobniku):
$env:OLLAMA_LOAD_TIMEOUT = "30m"
ollama serve
Lepsze rozwiązanie: trzymaj ten model na dysku NVMe.
- Uruchom i zmierz w drugim oknie:
ollama run gemma4:31b-it-qat --verbose "Wyjaśnij w 3 zdaniach po polsku, czym jest kwantyzacja QAT."
Flaga
--verbosepokazuje na końcu „eval rate”, czyli tokeny na sekundę. Tryb myślenia wyłączysz flagą--think=false. - Sprawdź pamięć karty:
ollama ps
nvidia-smi
W kolumnie PROCESSOR musi być „100% GPU”. Jeśli widzisz podział CPU/GPU, zmniejsz kontekst albo zamknij inne programy korzystające z karty.
- Własny kontekst przez API (tak liczyłem wyniki z tabeli):
curl http://127.0.0.1:11434/api/chat -d "{\"model\":\"gemma4:31b-it-qat\",\"messages\":[{\"role\":\"user\",\"content\":\"Cześć\"}],\"think\":false,\"options\":{\"num_ctx\":32768}}" - Zwolnij kartę po pracy:
ollama stop gemma4:31b-it-qat
Dla kogo jest Gemma 4 31B lokalnie
- Tak, jeśli masz kartę 24 GB (RTX 4090, 3090, 5090) i chcesz najlepszej jakości po polsku bez wysyłania tekstów do chmury.
- Tak, do pracy z poufnymi dokumentami, korekty i streszczeń - 42 tok/s w zupełności wystarcza.
- Nie, jeśli masz 16 GB lub mniej - weź Gemmę 4 12B - w moim wcześniejszym teście była najlepszym lokalnym modelem do pisania po polsku, a jest 2,5 raza szybsza.
- Nie, jeśli na tej samej karcie chcesz równolegle generować obrazy albo wideo.
Pozostałe lokalne modele - tekstowe, obrazowe i wideo - zebrałem w przewodniku Lokalne AI, a to, ile pamięci potrzebuje który rozmiar modelu, w tekście ile VRAM potrzeba.
Najczęstsze pytania
Ile VRAM potrzebuje Gemma 4 31B?
W wersji QAT (4 bity) Ollama zajmuje 19,2 GB przy kontekście 8 tys. i 19,3 GB przy 32 tys. tokenów. Cała karta w szczycie miała zajęte 24 GB, więc realnie potrzebujesz karty 24 GB i niczego innego na niej.
Czy Gemma 4 31B działa na RTX 4090?
Tak, w całości na GPU, 40-43 tokeny na sekundę. Warunek: nic innego nie może zajmować pamięci karty - przy współdzieleniu z ComfyUI spadło mi do 0,5-2,7 tok/s.
Jak dobrze Gemma 4 31B mówi po polsku?
Bardzo dobrze: 9,5 na 10 w moich pięciu zadaniach, bez błędów w rachunkach i faktach. Jedyną wpadką było pominięcie nazwiska w mailu.
Czy Gemmę 4 można używać komercyjnie?
Tak, licencja Apache 2.0 pozwala na użycie komercyjne, modyfikowanie i rozpowszechnianie.
Dlaczego Ollama nie może załadować Gemmy 4 31B?
Najczęściej przez wolny dysk: domyślny limit ładowania to 5 minut. Ustaw OLLAMA_LOAD_TIMEOUT=30m albo przenieś modele na szybszy dysk. Druga przyczyna to brak pamięci karty - zamknij inne programy korzystające z GPU.
Gemma 4 31B czy 12B?
Na kartę 24 GB - 31B, jeśli liczy się jakość. Na każdą mniejszą albo gdy liczy się szybkość - 12B (104 tok/s, 8 GB w moim wcześniejszym teście).
Źródła i data sprawdzenia
- Karta modelu Gemma 4 31B na Hugging Face (licencja, parametry, zalecane ustawienia).
- Ollama: tagi gemma4.
- Pomiary: mój komputer (RTX 4090 24 GB, Windows 11, Ollama 0.40.1), 8 października 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym