Podatek tokenowy 2026: ten sam polski tekst kosztuje u Claude o 56 procent więcej niż u OpenAI
Osiem modeli, jeden fragment po polsku, jeden token odpowiedzi: policzyłem, ile tokenów wejścia każdy z nich nalicza za identyczny tekst. Dwa obozy tokenizerów i wniosek, że cennik bez tego mnożnika kłamie.
👁 158 przeczytań
- Ten sam polski tekst (7843 znaki) kosztuje u Claude o 56 procent więcej niż u GPT-6 Astra, mimo identycznego cennika 10 dolarów za milion tokenów wejścia.
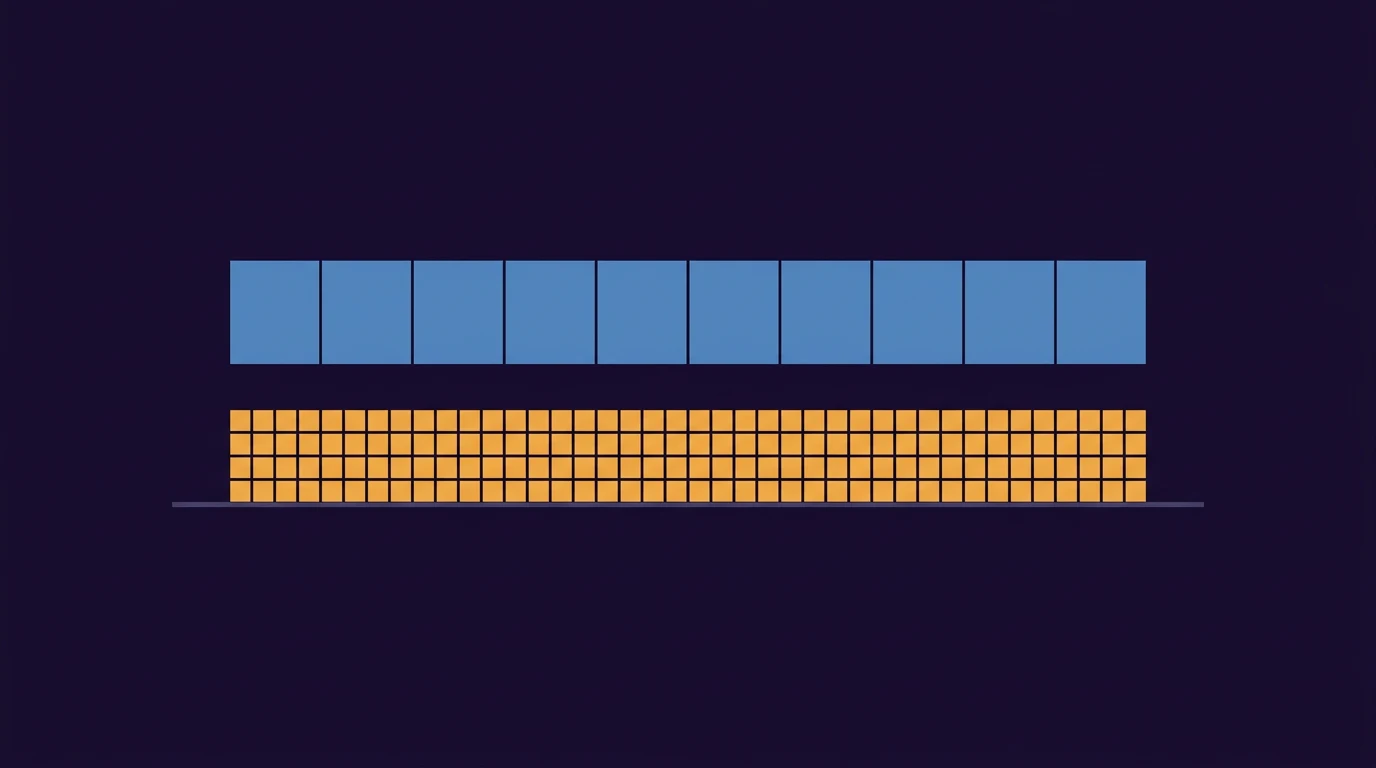
- Modele OpenAI, xAI i DeepSeek mieszczą około 3,1 znaku w jednym tokenie, natomiast Claude i Kimi dzielą gęściej - odpowiednio 2,03 i 2,34 znaku na token.
- Claude Sonnet 5 kosztuje 5 razy mniej niż Astra w cenniku, ale przez gęstszy tokenizer realna przewaga cenowa na polskim tekście spada do około trzykrotnej.
Cennik modelu mówi, ile kosztuje milion tokenów. Nie mówi, ile tokenów zjada twój tekst, a to zależy od tego, jak model dzieli polszczyznę na kawałki. Sprawdziłem to najprościej, jak się da: ten sam fragment mojego tekstu, 7843 znaki i około 1350 słów, wysłałem do ośmiu modeli z limitem jednego tokena odpowiedzi i odczytałem z rozliczenia API, ile tokenów wejścia policzył każdy z nich. Koszt całego testu: kilkanaście centów.
| Model | Tokeny za ten sam tekst | Znaków na token | Wobec GPT-6 Astra |
|---|---|---|---|
| GPT-6 Astra | 2 466 | 3,18 | 0 % |
| GPT-5.6 Sol | 2 466 | 3,18 | 0 % |
| Grok 4.6 | 2 489 | 3,15 | +1 % |
| DeepSeek V4 Pro | 2 599 | 3,02 | +5 % |
| Kimi K3 | 3 355 | 2,34 | +36 % |
| Claude Sonnet 5 | 3 857 | 2,03 | +56 % |
| Claude Fable 5.1 | 3 859 | 2,03 | +56 % |
| Gemini 3.8 Flash | brak danych: przy limicie jednego tokena API nie zwróciło rozliczenia | ||
Dwa obozy tokenizerów
Wyniki układają się w dwie grupy. Modele OpenAI, xAI i DeepSeek mieszczą około 3,1 znaku polskiego tekstu w jednym tokenie. Modele Anthropica i Kimi dzielą gęściej: Claude potrzebuje na ten sam tekst o 56 procent więcej tokenów, Kimi o 36 procent. Oba modele OpenAI dały identyczny wynik, co potwierdza, że Astra używa tego samego tokenizera co linia 5.6.
Dla angielskiego te różnice są mniejsze, bo wszystkie tokenizery były na nim trenowane najobficiej. Polszczyzna, z odmianą i ogonkami, jest dla części z nich językiem drugiej kategorii, i płacisz za to przy każdym zapytaniu.
Co to znaczy w rachunku
GPT-6 Astra i Claude Fable 5.1 mają identyczny cennik: 10 dolarów za milion tokenów wejścia. Ale za ten sam polski tekst Claude policzy 3859 tokenów, a Astra 2466. Przy tej samej stawce wejście do Fable kosztuje realnie o 56 procent więcej. Przy pojedynczym zapytaniu to ułamki centa; przy tysiącu długich dokumentów miesięcznie to różnica, którą widać na fakturze.
Działa to też w drugą stronę, na korzyść tańszych modeli. Claude Sonnet 5 kosztuje 2 dolary za milion tokenów wejścia, czyli pięć razy mniej niż Astra, ale przez gęstszy tokenizer realna przewaga cenowa na polskim tekście spada z pięciokrotnej do mniej więcej trzykrotnej. Porównywanie samych cenników prowadzi do błędnych wniosków, jeśli nie uwzględni się tokenizera.
Google · Twoje źródłaPromptowy wyżej w Twoim Google - jednym kliknięciemDodaj do preferowanych źródeł →Jak to policzyć u siebie
Co sam z tego zbudowałem
Osiem narzędzi, które powstały z problemów opisywanych na tym blogu - razem z tym, czego nie udało się dowieźć.
Nie trzeba niczego zgadywać. Wystarczy wysłać swój typowy dokument do modelu z limitem jednego tokena odpowiedzi i odczytać liczbę tokenów wejścia z rozliczenia. Koszt takiego pomiaru to ułamek centa, a wynik mówi więcej o twoim rachunku niż tabela cen. W kalkulatorze kosztów AI uwzględniam ten mnożnik przy przeliczaniu stawek na złotówki dla polskich zadań.
Jedno zastrzeżenie: zmierzyłem jeden fragment jednego tekstu. Proporcje między tokenizerami są stabilne, bo wynikają z ich konstrukcji, ale dokładne liczby dla twoich dokumentów mogą się nieco różnić, zwłaszcza przy tekstach z dużą ilością kodu, liczb albo nazw własnych. Pozostałe wyniki dużego testu Astry są w tekście o polszczyźnie, kodzie i długim kontekście.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Najczęstsze pytania
Dlaczego ten sam tekst po polsku kosztuje różnie w różnych modelach AI?
Każdy model inaczej dzieli tekst na tokeny, a płacisz właśnie za tokeny, nie za znaki. Claude potrzebuje na ten sam fragment 3857 tokenów, a GPT-6 Astra tylko 2466, choć stawka za milion tokenów jest u obu identyczna.
Ile tokenów zużywa Claude w porównaniu do GPT na polskim tekście?
Na fragmencie 7843 znaków Claude Sonnet 5 i Claude Fable 5.1 policzyły odpowiednio 3857 i 3859 tokenów, a GPT-6 Astra 2466 tokenów. To o 56 procent więcej tokenów po stronie Claude.
Jak samodzielnie sprawdzić, ile tokenów zużywa mój tekst w danym modelu?
Wystarczy wysłać swój dokument do modelu z limitem jednego tokena odpowiedzi i odczytać liczbę tokenów wejścia z rozliczenia API. Koszt takiego pomiaru to ułamek centa.
Czy tańszy model AI zawsze będzie tańszy w praktyce dla polskich tekstów?
Nie zawsze - gęstszy tokenizer może zmniejszyć realną przewagę cenową. Claude Sonnet 5 kosztuje 2 dolary za milion tokenów, czyli 5 razy mniej niż Astra, ale przez tokenizer realna różnica na polskim tekście spada do około trzykrotnej.
 Polski podatek tokenowy: ile więcej płacisz za AI, bo piszesz po polskuAI
 Zamknięcie dnia: AI kosztuje - i coraz więcej ludzi to czujeNewsy
 Token w AI: co to jest, ile to znaków i dlaczego polski kosztuje więcejArtykuły
Link do Kimi jest partnerski: jeśli kupisz przez niego, serwis dostaje prowizję, a Ty płacisz tyle samo. Nie wpływa to na treść, także tam, gdzie piszę krytycznie.
Podobne tematy na Promptowym