Claude Code: recenzja agenta, któremu oddałem 3 godziny pracy
W mojej najdłuższej sesji Claude Code z modelem Opus 5.5 w 3 godziny i 10 minut pobrał 127 GB modeli, przetestował 10 z nich i napisał 6 tekstów, a według cennika API kosztowałoby to 22,77 USD. To najmocniejszy agent do kodu, jakiego używam, ale płaci się limitami: w planie Pro za 99,99 zł (App Store PL) długie sesje kończą pulę szybciej, niż sugeruje cennik.
Plusy
- W mojej sesji z 26.09.2026 zrobił w 3 h 10 min pracę testera i autora: 228 uruchomień narzędzi, 10 modeli, 6 tekstów
- Sam łapał własne błędy, np. wykrył, że llama.cpp z instalatora działa na Vulkanie zamiast CUDA (54 zamiast 104 tokenów/s)
- 5 z 8 najwyższych wpisów w publicznym Terminal-Bench 4.0 to modele uruchomione w Claude Code (tbench.ai, 30.09.2026)
- Jest w cenie Claude Pro (20 USD), bez osobnej subskrypcji
- Terminal, VS Code, JetBrains, aplikacja desktop na Windows, macOS i Linux, przeglądarka, telefon i Slack
- Reguły uprawnień allow, ask i deny oraz tryb planu dają kontrolę nad tym, co agent uruchamia
Minusy
- Limity w oknach 5-godzinnych i tygodniowych bez stałej liczby wiadomości, więc trudno zaplanować dzień pracy
- Czat Claude i Claude Code zużywają jedną wspólną pulę
- Fable 5.1 w planie Pro tylko za dodatkowe kredyty, w Max do 50% tygodniowego limitu
- Długa sesja drogo czyta kontekst: w moim teście odczyt z cache to 12,5 z 22,77 USD
- Max 20x w App Store PL kosztuje 999,99 zł miesięcznie
- Brak polskiej dokumentacji (jest m.in. niemiecka, francuska i japońska)
Dla kogo
- programistów, którzy chcą oddać agentowi całe zadanie w repozytorium: poprawkę, testy, migrację
- osób, które już płacą za Claude Pro albo Max - Claude Code jest w tej samej cenie
- pracujących w terminalu, VS Code albo JetBrains, bo ustawienia i plik CLAUDE.md działają wszędzie tak samo
- osób automatyzujących pracę poza kodem: testy, raporty, przetwarzanie plików, teksty z danymi
Nie dla kogo
- szukających samego autouzupełniania kodu w edytorze - GitHub Copilot Pro kosztuje w App Store PL 49,99 zł
- potrzebujących GPT-6 albo Gemini w jednym abonamencie - w planach Claude są tylko modele Anthropic
- firm, które muszą trzymać dane w UE bez pośrednictwa Amazon Bedrock albo Google Cloud
- osób, które nie czytają zmian przed zatwierdzeniem - agent działa z uprawnieniami użytkownika
Claude Code recenzja: czym jest i od czego zacząłem
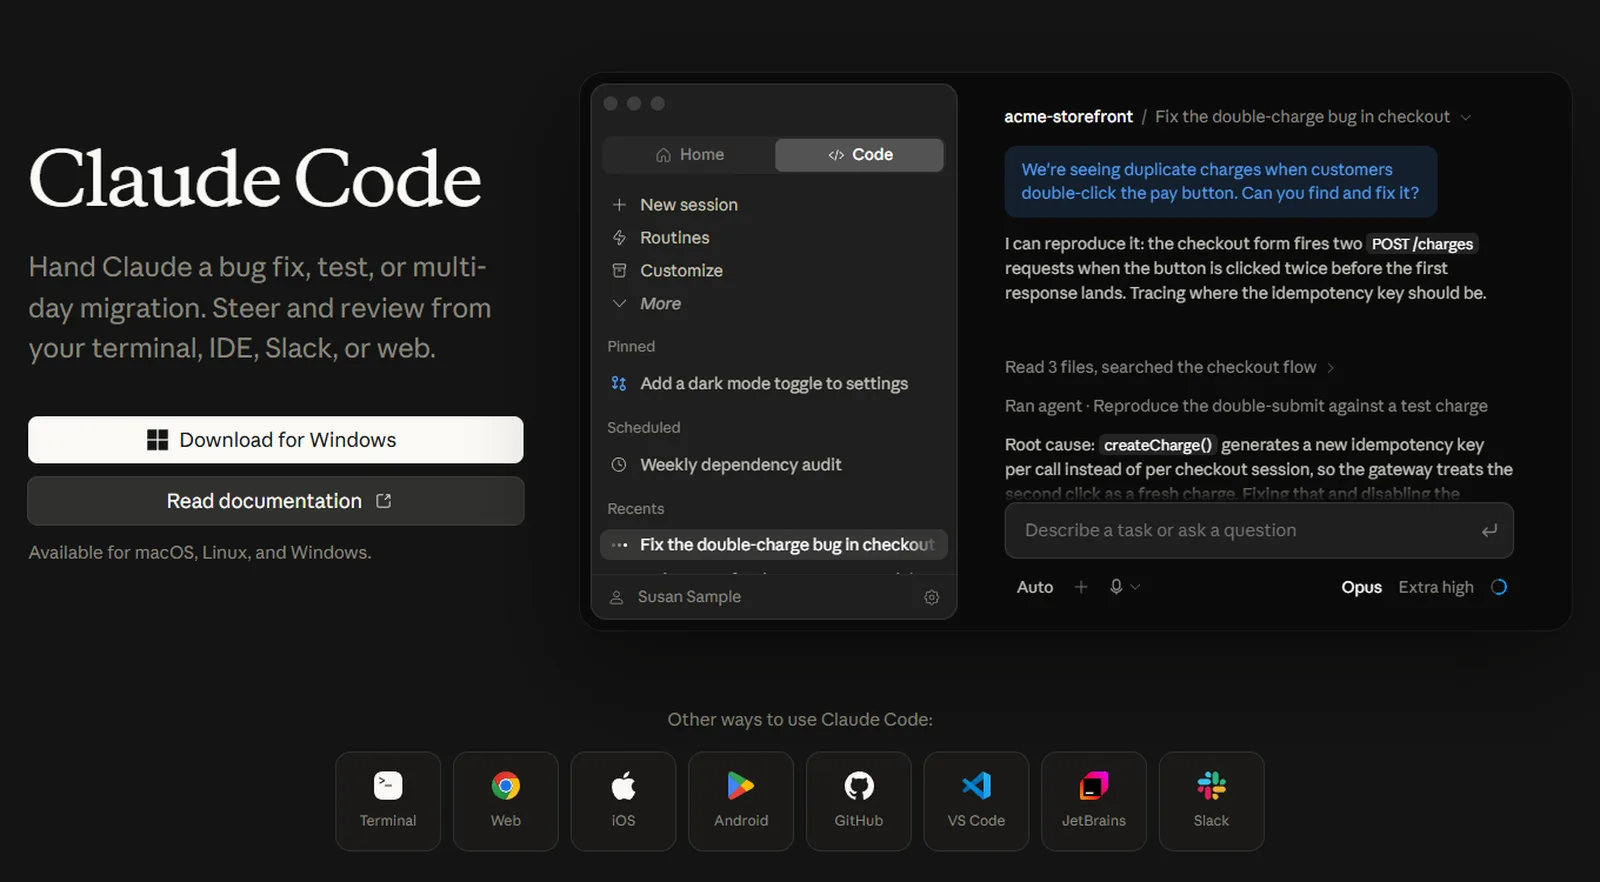
Claude Code to agent programistyczny Anthropic. Nie podpowiada pojedynczych linijek, tylko dostaje zadanie, sam czyta pliki projektu, uruchamia polecenia, zmienia kod i sprawdza wynik. Pierwsza wersja pojawiła się 24 lutego 2025 roku jako ograniczony podgląd w terminalu, razem z modelem Claude 3.7 Sonnet. Wersja ogólna weszła 22 maja 2025 roku, razem z integracjami z VS Code i JetBrains.
Dziś działa w kilku miejscach naraz: w terminalu, w rozszerzeniach do VS Code i JetBrains, w aplikacji desktop na Windows, macOS i Linux, w przeglądarce, na telefonie i w Slacku. Instalacja w terminalu to jedno polecenie, na Windowsie przez PowerShell. Dokumentacja zaleca Git for Windows, bo wtedy agent używa Basha; bez niego przechodzi na PowerShell.
Najbardziej przydatny okazał się dla mnie plik CLAUDE.md w katalogu projektu i pamięć między sesjami. Wpisuję tam zasady, które agent ma stosować zawsze: jak testować, czego nie publikować, jakie liczby trzeba sprawdzić w źródle. Te same ustawienia działają w terminalu, edytorze i aplikacji, bo wszystkie korzystają z jednego silnika.
Pierwsze wrażenie: to narzędzie dla osoby, która myśli zadaniami, a nie linijkami. Jeśli chcesz, żeby ktoś dokończył Ci pętlę for, Claude Code jest zbyt ciężki. Jeśli chcesz oddać poprawkę błędu razem z testem, jest w swoim żywiole.
Mój test: dwie sesje z Opus 5.5 w Claude Code
Claude Code z modelem Opus 5.5 sprawdziłem na zadaniach, które normalnie zajmują mi dni, a nie minuty. Wszystkie liczby poniżej pochodzą z zapisu sesji, który zawiera zużycie tokenów każdej odpowiedzi.
Sesja 1, 26 września 2026. O 9:57 napisałem jedno polecenie, wielkimi literami i bez polskich znaków: brakuje mi artykułów o lokalnych modelach AI, porównań, instalacji i przykładów. Nie podałem listy modeli, sprzętu ani metody oceny. Agent sam sprawdził, co już jest na blogu, wybrał 7 modeli tekstowych z licencją Apache 2.0, dwa generatory obrazów i model wideo, puścił w tle pobieranie 127 GB i zaczął mierzyć, zanim wszystko się ściągnęło. O 13:07 miałem wyniki ocenione przez trzech ślepych sędziów, 6 tekstów i przewodnik. Opisałem to w tekście Opus 5.5 w Claude Code: 3 godziny pracy agenta.
Najciekawsze były poprawki, których nikt nie zlecał. Agent zauważył, że llama.cpp zainstalowany przez winget działa na Vulkanie zamiast CUDA i daje 54 zamiast 104 tokenów na sekundę. Gdy pobieranie spadło do 1,3 MB/s, przerwał je i przeszedł na narzędzie Hugging Face z prędkością ok. 25 MB/s. Po powiększeniu obrazów znalazł błędne polskie litery w napisach, których na miniaturze nie było widać. Myli się jak człowiek, ale sam sprawdza wyniki, jeśli w zasadach projektu jest wymóg potwierdzania liczb - to moja opinia z tej sesji.
Sesja 2, 25 września 2026. Poprosiłem o animację o moim serwisie „dłuższą i ciekawszą” od viralowych filmików. Agent przez ok. 18 minut napisał 1568 linii kodu, wyrenderował 3600 klatek w 10 równoległych przeglądarkach i złożył 60-sekundowy film 1080p60 z muzyką generowaną kodem. Szczegóły są w tekście motion graphics z Opus 5.5.
Czego nie testowałem: nie mierzyłem Claude Code na cudzym, dużym repozytorium firmowym ani w porównaniu z Cursorem na tych samych zadaniach. Nie podaję więc procentu skuteczności przy poprawkach błędów. Do tego służą benchmarki publiczne z następnej sekcji.
Benchmark publiczny i moje sesje w Claude Code - osobno
Wykres to publiczna tablica Terminal-Bench 4.0 (tbench.ai, stan na 30.09.2026): niezależny benchmark agentów w terminalu, nie mój pomiar. Tabela pod nim to wyłącznie moje pomiary z dwóch sesji Claude Code z modelem Opus 5.5 z 25 i 26 września 2026; koszt policzyłem z zapisu tokenów według cennika API, choć płaciłem abonamentem.
| Moje zadanie w Claude Code (Opus 5.5) | Czas | Odpowiedzi / narzędzia | Koszt wg cennika API | Wynik |
|---|---|---|---|---|
| Test 10 lokalnych modeli AI, 6 tekstów i przewodnik (26.09.2026) | 3 h 10 min | 211 / 228 | 22,77 USD, z tego 12,5 USD to odczyt 62,7 mln tokenów z cache | komplet wyników i tekstów; agent sam poprawił kilka zdań i podpisów |
| Showreel 60 s, 1080p60, muzyka z kodu (25.09.2026) | ok. 18 min | 22 / 23 | 3,00 USD | 1568 linii kodu, 3600 klatek, render ok. 3 min |
| Trzech agentów pomocniczych w sesji z 26.09.2026 | równolegle z główną sesją | - | 3,45 USD łącznie (limit 1,50 USD na agenta) | gry, grafiki SVG, poradnik Remotion; nic nie publikowali sami |
Benchmarki: Terminal-Bench 4.0 i dane Anthropic (nie mój pomiar)
Terminal-Bench to benchmark prowadzony przez Stanford i Laude Institute, który sprawdza, czy agent wykona w terminalu wieloetapowe zadanie. Liczy się para: model plus „uprząż”, czyli program, który tym modelem steruje. Na publicznej tablicy wersji 4.0 z 30 września 2026 roku 5 z 8 najwyższych wyników to modele uruchomione w Claude Code. Najlepszy wpis Claude Code to Fable 5.1 z wynikiem 57,9%, o 0,3 punktu za GPT-6 Astra w Codeksie (58,2%).
Ciekawy jest wpis GLM-5.3 w Claude Code (41,8%). To model chińskiej firmy Z.ai, uruchomiony w narzędziu Anthropic. Pokazuje, że Claude Code da się podpiąć pod innych dostawców: dokumentacja potwierdza obsługę zewnętrznych dostawców w terminalu, VS Code i JetBrains.
Opus 5.5 na tej tablicy jeszcze nie ma. Anthropic w ogłoszeniu z 22 września 2026 roku podaje dla niego 66,4% w Terminal-Bench 4.0 przy wysiłku xhigh oraz 57,8% w CursorBench 4.0. To wyniki producenta, niezweryfikowane przez tablicę, więc nie wstawiam ich do wykresu. Anthropic sam zaznacza, że błąd standardowy dla Opus 5.5 to ±2,6 punktu.
Jak to czytać: benchmark mówi, jak dobrze para model plus agent radzi sobie z typowymi zadaniami w terminalu. Nie mówi, ile razy trafisz na limit ani jak agent poradzi sobie z Twoim starym projektem bez testów.
Claude Code po polsku: polecenia, teksty, dokumentacja
Wszystkie polecenia w moich sesjach pisałem po polsku, często bez polskich znaków, i agent rozumiał je bez problemu. Odpowiada w języku, w którym piszesz. Interfejs programu jest po angielsku, a dokumentacja ma wersje m.in. niemiecką, francuską i japońską, ale nie polską - adres z /pl/ zwraca błąd 404.
Przy kodzie język ma znaczenie w opisach zmian, dokumentacji i tekstach w interfejsie aplikacji. Tu przydaje się mój osobny test pisania po polsku w Laboratorium Promptowego (13 zadań, dwóch sędziów AI). Modele dostępne w Claude Code wypadają w nim tak: Claude Opus 5.5 90,1 pkt (pierwsze miejsce z 18 modeli), Fable 5.1 83,9, Sonnet 5.5 80,4, Haiku 4.5 59,2. To test pisania, nie programowania, więc traktuję go jako wskazówkę, który model wybrać do tekstów w projekcie.
Praktyczna rada: jeśli w repozytorium mają powstawać polskie teksty, zapisz w CLAUDE.md zasady pisowni. U mnie agent trzyma się ich w całej sesji, np. używa dywizu zamiast długiej pauzy.
Limity i ograniczenia, na które trafiłem
Największa wada Claude Code nie jest w kodzie, tylko w rozliczeniu. Każdy plan ma limit w oknie 5-godzinnym, a plany płatne dodatkowo limit tygodniowy. Anthropic nie podaje stałej liczby wiadomości: ile zrobisz, zależy od długości rozmowy, modelu i funkcji. Pro daje co najmniej 5 razy więcej niż Free na okno, Max 5x i 20x odpowiednio więcej niż Pro.
Druga rzecz: czat Claude na stronie, w aplikacji i Claude Code korzystają z jednej puli. Jeśli rano długo rozmawiasz z Claude o dokumentach, po południu agent ma mniej miejsca.
Trzecia: długie sesje zjadają limit przez ciągłe czytanie kontekstu. W mojej 3-godzinnej sesji odczyt 62,7 mln tokenów z pamięci podręcznej odpowiadał 12,5 USD z 22,77 USD, czyli ponad połowie kosztu. Stawka za odczyt jest niska (0,20 USD za milion tokenów przy Opus 5.5), ale agent czyta całą rozmowę przy każdej odpowiedzi. Nowe duże zadanie zaczynam więc w nowej sesji.
- Fable 5.1, najmocniejszy model w Claude Code, w planie Pro jest dostępny tylko za dodatkowe kredyty, w Max do 50% tygodniowego limitu.
- Zapytania Fable, które klasyfikator bezpieczeństwa uzna za ryzykowne (najczęściej cyberbezpieczeństwo i biologia), automatycznie przechodzą na inny model.
- Przy premierze Opus 5.5 Anthropic podniósł limity 5-godzinne w planach Pro, Max i Team i dał abonentom jednorazowy reset limitu do wykorzystania w dowolnym momencie.
Claude Code cena: który plan wybrać
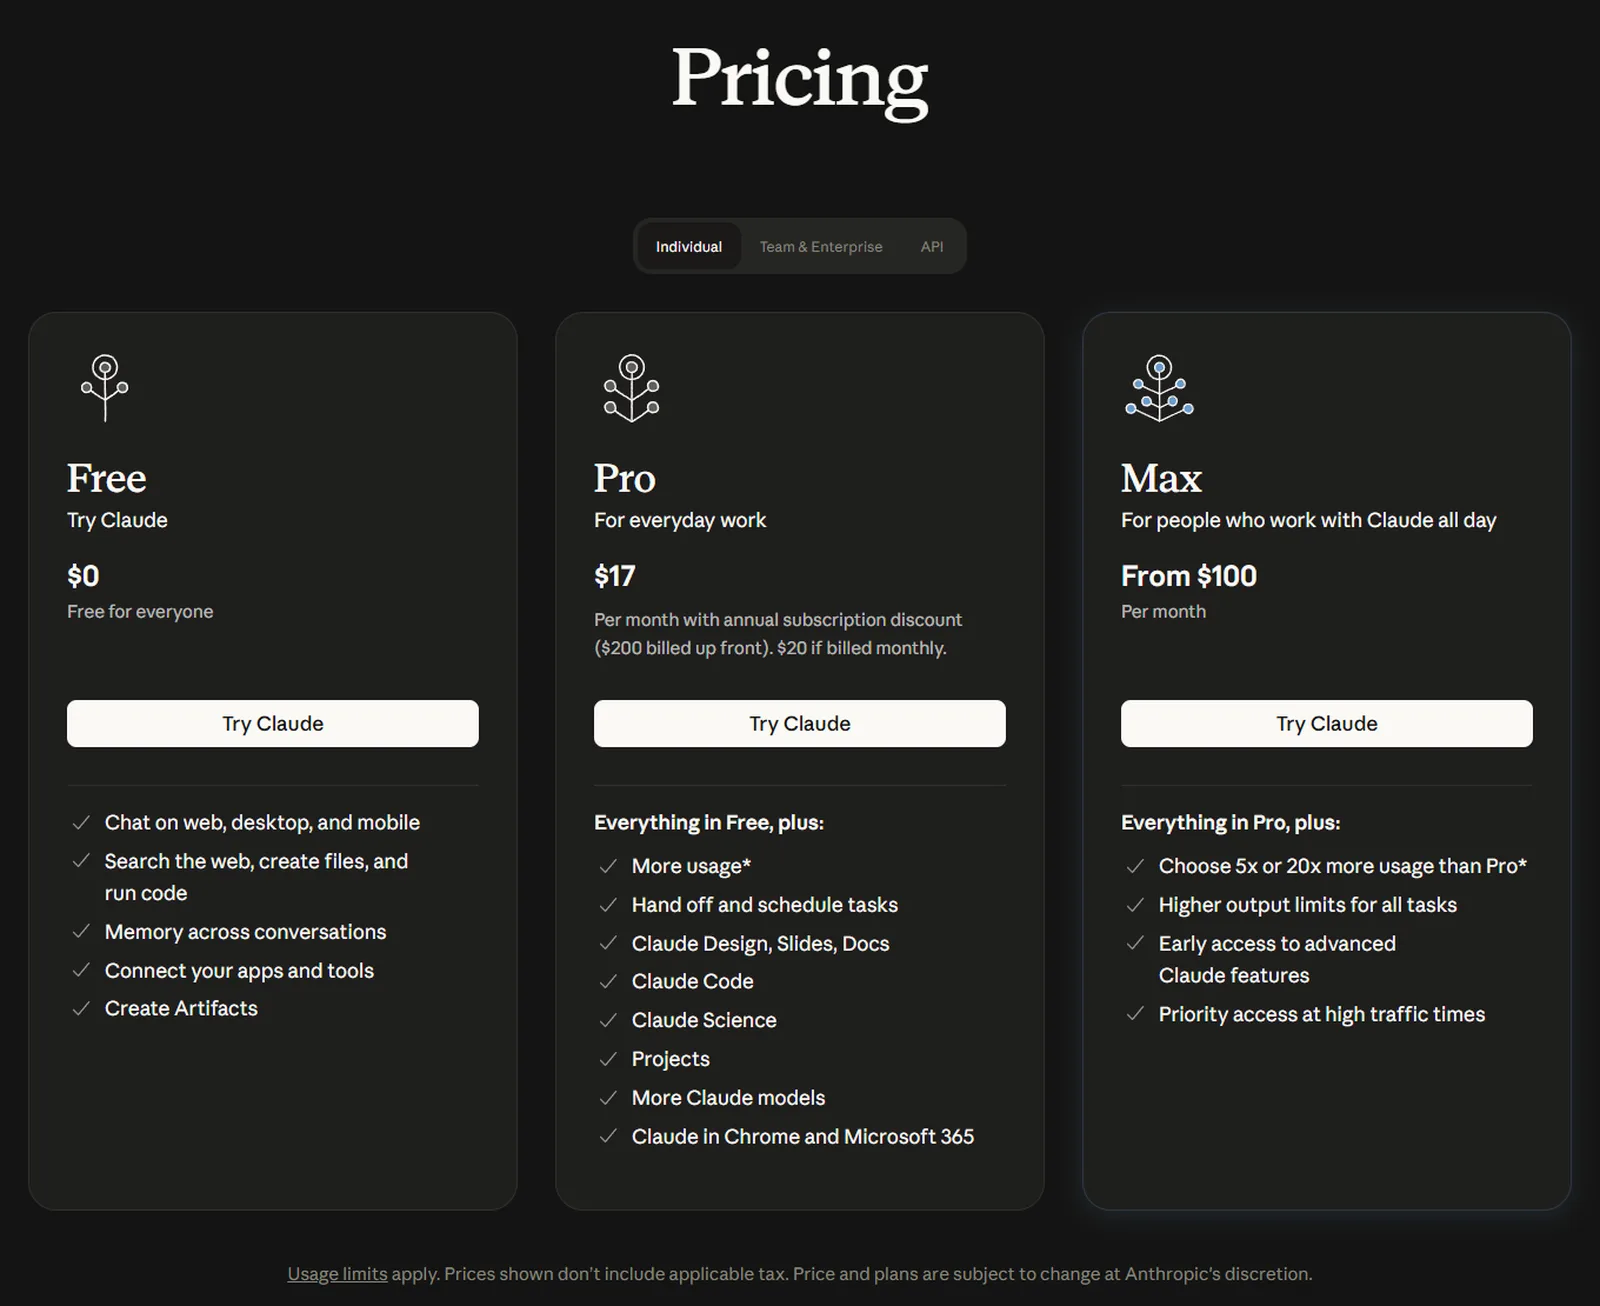
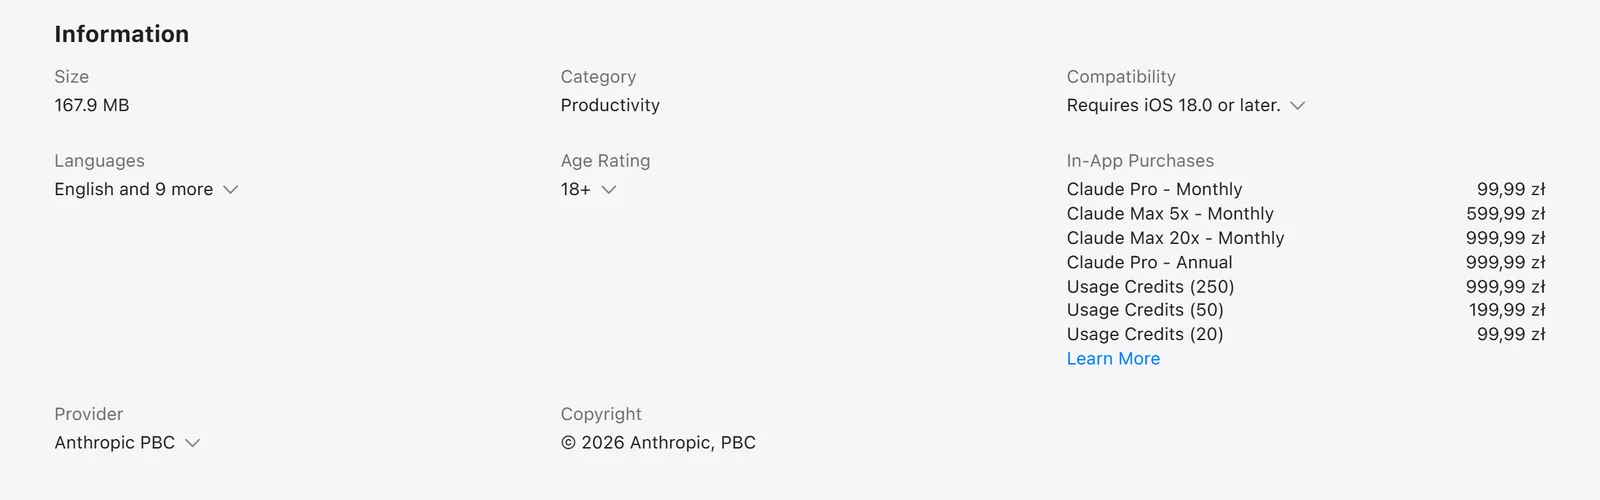
Claude Code nie ma osobnego cennika. Jest w każdym płatnym planie Claude, a w darmowym go nie ma. Na stronie Anthropic Pro kosztuje 20 USD miesięcznie albo 200 USD za rok z góry, Max 5x 100 USD, a Max 20x 200 USD, zawsze bez podatku. Polskich cen Anthropic na stronie nie publikuje, ale są w App Store: Pro 99,99 zł miesięcznie, Pro roczny 999,99 zł, Max 5x 599,99 zł i Max 20x 999,99 zł, z VAT.
Mój wybór wygląda tak:
- Pro na próbę i pracę kilka razy w tygodniu. Opus 5.5 jest w planie, ale długie sesje szybko kończą okno.
- Max 5x, jeśli przez dwa tygodnie regularnie trafiasz na limit 5-godzinny. To najczęstszy rozsądny krok w górę.
- Max 20x tylko przy pracy kilku agentów równolegle przez większość dnia.
- API przez Console przy pracy nieregularnej albo automatach w tle: płacisz za tokeny, bez okien czasowych.
App Store ma własny cennik w złotych z VAT, a na stronie Anthropic rozliczenie idzie w dolarach bez podatku, do których osoba prywatna dolicza VAT. Zbiorcze zestawienie planów wszystkich agentów do kodu jest w tekście ile kosztuje AI do programowania.
Prywatność, uprawnienia i dane firmy
Claude Code działa na komputerze z uprawnieniami osoby, która go uruchomiła. Dokumentacja opisuje trzy rodzaje reguł: allow, ask i deny, przy czym deny ma pierwszeństwo. Ustawiam zawsze pytanie o zgodę przy poleceniach sieciowych i usuwających pliki, a klucze trzymam poza katalogiem projektu.
Na planach konsumenckich (Free, Pro, Max) użycie danych do ulepszania modeli zależy od ustawienia prywatności; cennik Anthropic opisuje to jako opcję do wyłączenia. Każda ocena odpowiedzi kciukiem trafia do Anthropic razem z rozmową i może być przechowywana do 5 lat. Na kontach firmowych i w API regulamin komercyjny zakazuje trenowania na treściach klienta.
Rezydencji danych w UE Anthropic bezpośrednio nie oferuje; można ją uzyskać przez Amazon Bedrock albo Google Cloud. Opus 5.5 jest dostępny z opcją zero data retention. Szczegóły dla pięciu dostawców zebrałem w tekście agent do kodu w firmie. Zasada, której się trzymam: kod firmy nigdy nie idzie przez prywatny abonament programisty.
Claude Code czy warto? Alternatywy
Czy warto? Moim zdaniem tak, jeśli pracujesz na repozytorium i chcesz oddawać całe zadania. Za 20 USD dostajesz agenta, który w publicznym benchmarku jest w ścisłej czołówce i w moich sesjach zrobił pracę kilku dni.
- Cursor - lepszy, jeśli chcesz pracować w edytorze i przełączać modele różnych firm. Od sierpnia 2026 należy do SpaceX, a OpenAI zapowiedziało odcięcie swoich modeli od 12 listopada 2026.
- GitHub Copilot - najtańszy płatny plan (49,99 zł w App Store PL), 34 modele, w tym GPT-6 i Opus 5.5 od planu Pro+. W Pro można nawet uruchomić Claude Code jako agenta zewnętrznego.
- Codex od OpenAI - najbliższy odpowiednik, w cenie ChatGPT Plus (99,99 zł). Różnice opisałem w tekście Codex czy Claude Code.
Jeśli jeszcze nie wiesz, którego agenta potrzebujesz, zacznij od przeglądu agentów AI do kodu, a potem od planu, za który już płacisz.
Claude Code: ceny i plany
| Plan | Cena | Co dostajesz |
|---|---|---|
| Free | 0 zł | czat Claude, bez Claude Code |
| Pro | 99,99 zł / mies. (App Store PL); 20 USD na stronie | Claude Code, Opus 5.5 i Sonnet 5.5; Fable tylko za dodatkowe kredyty; okna 5 h i limit tygodniowy |
| Pro roczny | 999,99 zł / rok (App Store PL); 200 USD z góry na stronie | to samo co Pro, na stronie wychodzi 17 USD miesięcznie |
| Max 5x | 599,99 zł / mies. (App Store PL); 100 USD na stronie | 5 razy więcej użycia niż Pro na okno 5 h, wyższe limity odpowiedzi, priorytet w godzinach szczytu |
| Max 20x | 999,99 zł / mies. (App Store PL); 200 USD na stronie | 20 razy więcej użycia niż Pro na okno 5 h |
| API (Console) | według tokenów | Opus 5.5: 4 USD wejście i 20 USD wyjście za 1 mln tokenów, odczyt z cache 0,20 USD |
Ceny w złotych to zakupy w aplikacji Claude w polskim App Store, z VAT, sprawdzone 30.09.2026. Anthropic na swojej stronie podaje ceny tylko w USD i bez podatku, polskiego cennika nie ma. Dolarów nie przeliczam na złote. W App Store są też pakiety dodatkowych kredytów: 99,99 zł, 199,99 zł i 999,99 zł. źródło
Claude Code a konkurencja
| Claude Code | Cursor | GitHub Copilot | |
|---|---|---|---|
| Najtańszy płatny plan (App Store PL) | 99,99 zł (Pro) | 119,99 zł (Pro) | 49,99 zł (Copilot Pro) |
| Najtańszy płatny plan (strona, bez VAT) | 20 USD (17 USD rocznie) | 20 USD | 10 USD |
| Najwyższy plan indywidualny | Max 20x: 200 USD / 999,99 zł | Ultra: 200 USD / 1199,99 zł | Max: 100 USD / 499,99 zł |
| Plan darmowy | brak Claude Code w Free | Hobby z ograniczonym agentem | Free: 2000 podpowiedzi / mies. i pula kredytów |
| Rozliczanie | okna 5 h i limit tygodniowy | dwie pule po stawkach API | kredyty AI, 1 kredyt = 0,01 USD |
| Modele | tylko Anthropic: Opus 5.5, Sonnet 5.5, Fable 5.1, Haiku 4.5 | Grok 4.7, Composer 2.5, Claude, Gemini, GPT-5.6 do 12.11.2026 | 34 modele: Claude, GPT-6, Gemini, Grok, Kimi |
| Gdzie działa | terminal, VS Code, JetBrains, desktop, web, telefon, Slack | własny edytor, CLI, web, iOS | VS Code, Visual Studio, JetBrains, Xcode, Eclipse, CLI, GitHub.com |
| Trening na danych (konto prywatne) | według ustawienia prywatności | nie w trybie Privacy Mode | domyślnie tak od 24.04.2026, można wyłączyć |
| Terminal-Bench 4.0, najlepszy wpis | 57,9% (Fable 5.1) | brak wpisu | brak wpisu |
| Moje pomiary | 2 sesje: 3 h 10 min i 18 min | brak | brak |
Ciekawostki
- Claude Code zadebiutował 24 lutego 2025 roku jako „ograniczony podgląd badawczy” w terminalu, dołączony do premiery Claude 3.7 Sonnet. Wersja ogólna przyszła 22 maja 2025 roku.
- 12 lutego 2026 roku Anthropic podał, że przychód roczny Claude Code (w tempie bieżącym) przekroczył 2,5 mld USD i podwoił się od początku roku, podobnie jak liczba tygodniowych użytkowników.
- Na publicznej tablicy Terminal-Bench 4.0 w Claude Code startuje też chiński GLM-5.3 (41,8%), bo narzędzie da się podpiąć pod innych dostawców modeli.
- Model Fable 5 zniknął z Claude na 18 dni: 12 czerwca 2026 roku Anthropic wyłączył go wszystkim klientom po nakazie rządu USA, a 30 czerwca przywrócił.
- W mojej 3-godzinnej sesji ponad połowa kosztu (12,5 z 22,77 USD) to nie pisanie, tylko ponowne czytanie rozmowy z pamięci podręcznej.
Claude Code polecam każdemu, kto pracuje na prawdziwym repozytorium i umie przeczytać diff: agent sam planuje, uruchamia polecenia i sprawdza wyniki. Na start wystarczy Pro (20 USD na stronie, 99,99 zł w App Store PL), ale przy codziennej pracy z Opus 5.5 okna 5-godzinne szybko wypchną Cię do Max 5x. Nie wybieraj go, jeśli chcesz tylko podpowiedzi w edytorze albo w jednym abonamencie potrzebujesz modeli OpenAI i Google - wtedy tańszy i szerszy jest GitHub Copilot.
Najczęstsze pytania
Ile kosztuje Claude Code?
Claude Code jest w cenie każdego płatnego planu Claude. Na stronie Anthropic Pro kosztuje 20 USD miesięcznie bez podatku, Max 5x 100 USD, a Max 20x 200 USD. W polskim App Store te plany kosztują 99,99 zł, 599,99 zł i 999,99 zł miesięcznie z VAT.
Czy Claude Code jest za darmo?
Nie. Darmowy plan Claude nie zawiera Claude Code. Można korzystać z niego przez API i płacić za tokeny, ale wtedy każde użycie kosztuje, np. Opus 5.5 to 4 USD za milion tokenów wejścia i 20 USD za milion wyjścia.
Czy Claude Code działa po polsku?
Tak w rozmowie: polecenia piszę po polsku, także bez polskich znaków, a agent odpowiada po polsku. Interfejs i dokumentacja są po angielsku, polskiej wersji dokumentacji nie ma.
Czy Claude Code działa na Windowsie?
Tak. Instaluje się go jednym poleceniem w PowerShell albo przez WinGet, jest też aplikacja desktop na Windows. Dokumentacja zaleca Git for Windows, bo wtedy agent korzysta z Basha.
Claude Code czy Cursor?
Claude Code, jeśli chcesz oddawać agentowi całe zadania i pracujesz w terminalu albo dowolnym edytorze. Cursor, jeśli wolisz własny edytor z podglądem zmian i modele różnych firm w jednym abonamencie. Oba zaczynają się od 20 USD.
Co się dzieje, gdy skończy się limit w Claude Code?
Czekasz na reset okna 5-godzinnego albo limitu tygodniowego, przechodzisz na wyższy plan albo włączasz dodatkowe kredyty rozliczane po stawkach API. Stan zużycia widać w ustawieniach, w zakładce Usage.
Źródła
- Anthropic: cennik Claudeclaude.com
- App Store PL: Claude by Anthropic, zakupy w aplikacjiapps.apple.com
- Anthropic: czym jest plan Maxsupport.claude.com
- Claude Code Docs: przeglądcode.claude.com
- Claude Code Docs: konfiguracja modelicode.claude.com
- Anthropic: Claude Opus 5.5 (22.09.2026)anthropic.com
- Terminal-Bench 4.0: tablica wynikówtbench.ai
- Anthropic: runda Series G (12.02.2026)anthropic.com
- Anthropic: Claude 3.7 Sonnet i Claude Code (24.02.2025)anthropic.com
- Anthropic: Claude 4 i Claude Code GA (22.05.2025)anthropic.com
- Claude Code Docs: uprawnieniacode.claude.com
- Promptowy: Opus 5.5 w Claude Code, 3 godziny pracy agentapromptowy.com
- Promptowy: motion graphics z Opus 5.5promptowy.com
- Promptowy: Laboratorium Promptowego, metodapromptowy.com
- Promptowy: agent do kodu w firmiepromptowy.com
- Promptowy: czy Claude działa w Polsce (Fable 5)promptowy.com
Sprawdzone 30.09.2026. Ceny i limity zmieniają się często, dlatego przy każdej aktualizacji sprawdzam je u źródła.
Historia zmian
- Pełna recenzja od nowa: moje dwie sesje z Opus 5.5, polskie ceny z App Store, Terminal-Bench 4.0, zrzuty.