Chinom kończy się chińskojęzyczny tekst do trenowania AI
Chińskie firmy AI stają przed nowym wąskim gardłem - nie chipami, lecz brakiem wysokiej jakości danych treningowych w języku chińskim.
👁 138 przeczytań
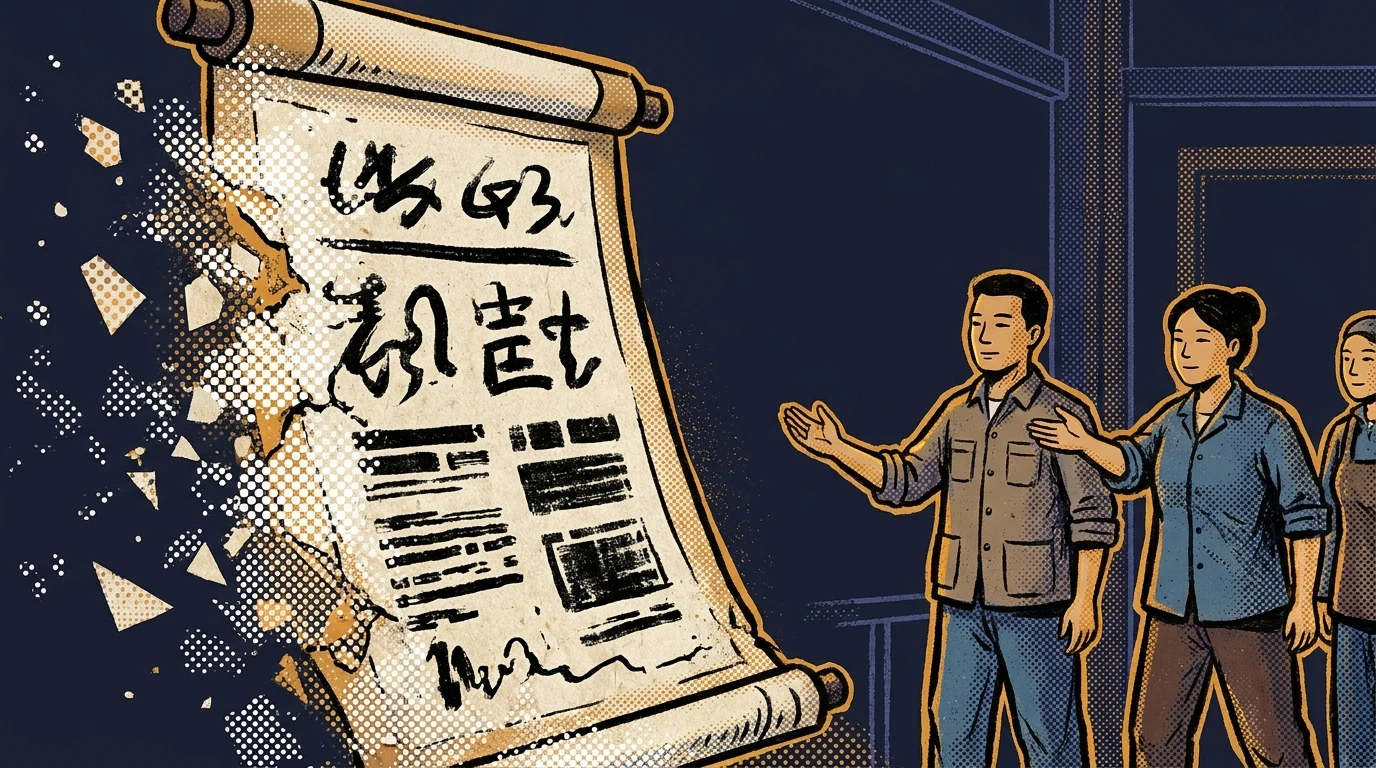
Chińskie laboratoria AI natknęły się na nową przeszkodę w wyścigu o dominację technologiczną - tym razem nie są nią sankcje na chipy, lecz kurczący się zasób wysokiej jakości danych treningowych w języku chińskim. O problemie coraz głośniej mówią chińscy specjaliści od sztucznej inteligencji, a jego skala może okazać się trudniejsza do obejścia niż ograniczenia sprzętowe.
Według amerykańskiego instytutu badawczego Epoch AI, globalny zasób wysokiej jakości, publicznie dostępnych tekstów tworzonych przez ludzi może zostać w pełni wyczerpany w ciągu najbliższych sześciu lat. Współzałożyciel OpenAI Andrej Karpathy ostrzegał przed nadchodzącym „murem danych” do końca tej dekady - punktem, po którym możliwości modeli przestaną rosnąć, jeśli nie zostaną zasilone świeżymi i wiarygodnymi informacjami.
Google · Twoje źródłaPromptowy wyżej w Twoim Google - jednym kliknięciemDodaj do preferowanych źródeł →Dlaczego Chiny są szczególnie narażone
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Problem dotyka całą branżę AI, ale dla chińskich firm ma wymiar szczególnie dotkliwy. Chińskojęzycznych treści w otwartym internecie jest proporcjonalnie mniej niż angielskich, a to właśnie język stanowi tu kluczowe ograniczenie. Duże modele językowe wymagają ogromnych zbiorów tekstów, by nauczyć się niuansów języka, faktów o świecie i logicznego rozumowania - i w przypadku chińskiego ten zasób topnieje szybciej.
Przez ostatnie lata uwaga obserwatorów skupiała się głównie na amerykańskich restrykcjach eksportowych dotyczących zaawansowanych układów scalonych, takich jak chipy Nvidii. Chińskie firmy odpowiadały na to budową własnych procesorów i optymalizacją modeli pod słabszy sprzęt - czego przykładem było zeszłoroczne zamieszanie wokół modelu DeepSeek. Problem danych jest jednak innej natury: nie da się go rozwiązać inżynierią sprzętową ani krajową polityką przemysłową.
Czołowe amerykańskie laboratoria już teraz wydają ogromne środki na pozyskiwanie wiedzy z zasobów offline - książek, archiwów, dokumentów - co rodzi poważne spory etyczne i prawne dotyczące praw autorskich. Chińskie firmy stoją przed analogicznym wyzwaniem, ale w węższej przestrzeni językowej.
Eksperci wskazują, że odpowiedzią może być intensywniejsze korzystanie z danych syntetycznych - tekstów generowanych przez same modele AI w celu trenowania kolejnych wersji. To podejście ma jednak ograniczenia: modele uczone wyłącznie na danych syntetycznych mogą powielać własne błędy i stopniowo tracić kontakt z rzeczywistością.
O ile problem chipów był widoczny i polityczny, o tyle wyczerpywanie się danych treningowych to zagrożenie, które narasta po cichu - i może okazać się trudniejsze do przezwyciężenia dla każdego, kto startuje z mniejszym zasobem tekstu w swoim języku.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →

Podobne tematy na Promptowym