GPT-6 Astra vs Opus 5.5: 9 testów, wyniki i koszt w zł
Te same zadania, uruchomiony kod i sędziowie w ciemno. Opus 5.5 lepiej pisze i jest 1,56 raza tańszy, Astra rozwiązała matematykę, której Opus nie dokończył.
👁 906 przeczytań
W moim teście ośmiu praktycznych zadań Claude Opus 5.5 i GPT-6 Astra nie popełniły ani jednego błędu merytorycznego, ale Opus lepiej pisał po polsku, zrobił ładniejszą stronę i kosztował 0,89 USD wobec 1,39 USD u Astry. Astra wygrała za to dogrywkę z trudnej matematyki 4:0, bo Opus w pięciu próbach zużywał cały limit na myślenie i nie oddał odpowiedzi. Do kodu, tekstów i długich dokumentów wybrałbym Opusa, do wieloetapowego liczenia Astrę.
Oba modele dostały 29 września 2026 przez OpenRouter te same polecenia. Kod uruchomiłem, strony otworzyłem w Chrome, liczby przeliczyłem skryptem, a teksty ocenili w ciemno sędziowie z innych firm. Poniżej wynik, czas i koszt każdego zadania.
Który model do czego
Tabela łączy mój test z benchmarkami producentów. Tam, gdzie oba modele zrobiły zadanie bezbłędnie, rozstrzygają koszt i czas.
| Zastosowanie | Wybór | Dlaczego |
|---|---|---|
| Teksty po polsku, maile | Opus 5.5 | sędziowie 9,1 vs 7,7 pkt; w Laboratorium 90,1 vs 85,3 |
| Python, poprawki w kodzie | Opus 5.5 | ten sam wynik testów, 2,1 raza taniej i 1,8 raza szybciej |
| Front-end, proste aplikacje | Opus 5.5 | obie strony liczą dobrze, wygląd 9,3 vs 8,0 pkt |
| Długie dokumenty | Opus 5.5 | 6/6 u obu, ale 0,19 vs 0,37 USD i brak dopłaty powyżej 272 tys. tokenów |
| Dane, wyciąganie JSON | remis | komplet u obu; Astra szybsza w danych (32,8 vs 50,3 s) |
| Trudna matematyka | GPT-6 Astra | dogrywka 4/4, Opus bez odpowiedzi |
| Agentowa praca naukowa | GPT-6 Astra | +5,9 pkt w Terminal-Bench-Science (dane producentów) |
Wynik, czas i koszt każdego zadania
Ustawienie rozumowania: medium dla obu. Koszt to pole usage.cost z OpenRouter, czas to pełny czas odpowiedzi z jednego przebiegu. W każdej komórce najpierw Opus, potem Astra.
| Zadanie | Wynik | Czas (s) | Koszt (USD) |
|---|---|---|---|
| Kod: moduł z testami | 38/38 i 38/38 | 48,4 / 94,3 | 0,120 / 0,277 |
| Kod: napraw błędy | 21/21 i 21/21 | 32,4 / 51,5 | 0,072 / 0,127 |
| Front-end: kalkulator | 5/5 i 5/5, wygląd 9,3 / 8,0 | 99,7 / 104,6 | 0,255 / 0,361 |
| Analiza danych (CSV) | 10/10 i 10/10 | 50,3 / 32,8 | 0,122 / 0,140 |
| Trzy zagadki | 3/3 i 3/3 | 28,6 / 29,1 | 0,053 / 0,065 |
| Mail po polsku | 9,1 / 7,7 pkt | 23,2 / 14,4 | 0,053 / 0,026 |
| JSON z maila | 18/18 i 18/18 pól | 11,0 / 8,6 | 0,022 / 0,032 |
| Długi kontekst (ustawa) | 6/6 i 6/6 | 9,2 / 4,1 | 0,193 / 0,367 |
| Razem 8 zadań | bez błędów u obu | 302,8 / 339,4 | 0,891 / 1,394 |
| Dogrywka: 4 trudne zadania | 0/4 / 4/4 | 182-321 / 266,9 | 1,930 (5 prób) / 0,697 |
W złotych (kurs 3,857 zł/USD, bez VAT) osiem zadań kosztowało 3,44 zł u Opusa i 5,38 zł u Astry. Nieudane próby Opusa w dogrywce to dodatkowe 7,45 zł.
Dlaczego Opus nie wyszedł 2,5 raza taniej
Według cennika Anthropic Opus 5.5 kosztuje 4 i 20 USD za milion tokenów, a według karty modelu OpenAI Astra 10 i 50 USD. W moim teście Astra była droższa tylko 1,56 raza. Winny jest tokenizer: ten sam polski dokument (91,8 tys. znaków) Opus policzył jako 45 735 tokenów, a Astra jako 28 853. We wszystkich ośmiu poleceniach różnica na wejściu wyniosła 1,55 raza, a przy kodzie HTML podobnej długości (24-25 kB) Opus wygenerował 11,2 tys. tokenów odpowiedzi, Astra 6,9 tys.
Przy krótkich tekstach Opus bywa nawet droższy. Nad mailem na 134 słowa myślał 2049 tokenów, Astra 149, więc zapłaciłem 0,053 zamiast 0,026 USD. Od czego zależy długość myślenia, opisałem w tekście o poziomach wysiłku Opusa.
Kod: moduł z testami jednostkowymi
Zadanie: moduł magazyn.py z klasą, która przyjmuje i wydaje towar metodą FIFO na kwotach Decimal, oraz funkcją zamieniającą zapis w rodzaju „1h 30m” na sekundy. W specyfikacji było kilkanaście pułapek: bool jako ilość, float jako cena, przecinek dziesiętny, zaokrąglanie dopiero sumy. Każdy model miał dopisać własne testy pytest, a potem uruchomiłem ich testy i 38 moich ukrytych.
Oba przeszły 38/38 ukrytych testów i komplet własnych. Opus napisał 15 funkcji testowych (44 przypadki), Astra 23 funkcje (90 przypadków). Astra testowała szerzej, ale pracowała prawie dwa razy dłużej (94,3 wobec 48,4 s) i kosztowała 2,3 raza więcej. Opus rozebrał zapis czasu jednym wyrażeniem regularnym z nazwanymi grupami, Astra czytała go kawałek po kawałku i w pętli pilnowała kolejności jednostek. Fragment u Opusa:
r"(?:(?P<d>[0-9]+)\s*d\s*)?"
r"(?:(?P<h>[0-9]+)\s*h\s*)?"
Kod: naprawa błędów w istniejącym pliku
Moduł raportowy z pięcioma funkcjami miał zaszyte usterki: zgubione ostatnie okno średniej ruchomej, złą kolejność przy remisach, pominięty dzień końcowy, mnożenie napisu przez 100 zamiast kwoty i NIP odrzucany przy spacjach albo prefiksie PL. Oryginał przechodził 8 z 21 moich testów.
Po poprawkach oba pliki przeszły 21/21. Opus wypisał 10 usterek, w tym jedną, której nie planowałem: „str.isdigit() akceptuje cyfry spoza ASCII (np. arabskie)”. Astra wypisała 9 i też dorzuciła własną, o zbiorze świąt podanym jako iterator. Czas i koszt: 32,4 s i 0,072 USD u Opusa, 51,5 s i 0,127 USD u Astry.
Front-end: kalkulator raty kredytu
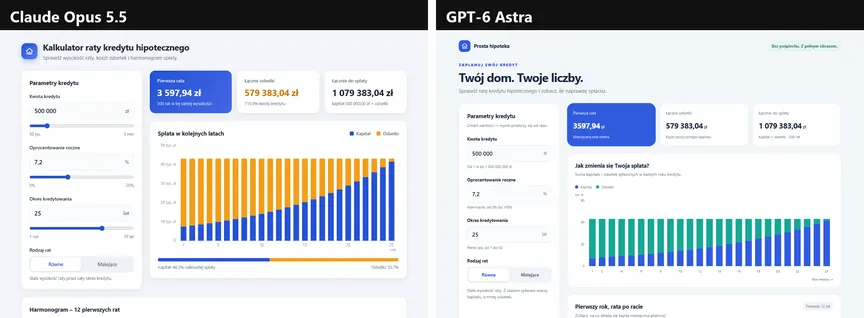
Polecenie: jeden plik HTML bez bibliotek, kalkulator raty po polsku z wykresem na canvas, tabelą 12 rat i przełącznikiem rat równych i malejących. Stronę otworzyłem w Chrome bez okna, zrobiłem zrzut i odczytałem liczby, także po przełączeniu na raty malejące.
Oba kalkulatory liczą poprawnie: rata 3597,94 zł, odsetki 579 383,04 zł, a przy ratach malejących pierwsza rata 4666,67 zł i odsetki 451 500,00 zł. Różni je wygląd. Opus dodał suwaki i pasek udziału kapitału w spłacie. Astra wypisuje „3597,94 zł” bez spacji tysięcy, co polska typografia dopuszcza przy liczbach czterocyfrowych, ale nie zgadza się z przykładem w poleceniu, a jej wykres ma dwa bliskie kolory. Sędziowie dali za wygląd 9,3 pkt Opusowi i 8,0 Astrze, a wszystkie cztery werdykty przypadły Opusowi.
Analiza danych: 73 wiersze CSV
Dane sprzedaży sklepu z akcesoriami do kawy: 73 pozycje, 45 zamówień, średnik jako separator, przecinek dziesiętny i rabaty procentowe. Pytałem o przychód netto, najlepszy region i jego udział, produkt z największą liczbą sztuk, miesiąc z największym wzrostem, średnią wartość zamówienia i medianę pozycji w jednym regionie. Wyniki sprawdziłem skryptem na liczbach dziesiętnych.
Oba modele policzyły wszystko bez narzędzi i trafiły 10/10, w tym przychód 56 081,60 zł i wzrost we wrześniu o 67,5%. Opus rozpisał tabele miesięcy i regionów, co ułatwia kontrolę, ale myślał 4533 tokeny i pracował 50,3 s. Astra oddała krótkie podsumowanie i JSON po 32,8 s.
Trzy zagadki i dogrywka z matematyki
Podstawowy zestaw: ile liczb pięciocyfrowych podzielnych przez 11 ma sumę cyfr 20 (486), zagadka o rycerzach i łotrach z pięcioma osobami oraz prawdopodobieństwo warunkowe przy trzech kostkach (5/18). Odpowiedzi sprawdziłem, przeliczając wszystkie przypadki w Pythonie. Oba modele: 3/3 w niemal tym samym czasie (28,6 i 29,1 s), choć Opus zużył dwa razy więcej tokenów (2550 wobec 1220), bo rozpisywał każdy krok.
Przy remisie dodałem cztery trudniejsze zadania: permutacje liczb 1-8 bez punktów stałych i bez sąsiadów różniących się o 1 (1695), najmniejszą liczbę spełniającą warunek podzielności przez 1105 (1347), dzień tygodnia 13 października 2173 (środa) i prawdopodobieństwo, że suma rzutów kostką trafi w 10 bez przeskoczenia (0,2893). Modele liczyły same, bez dostępu do komputera.
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Astra rozwiązała wszystkie cztery w 266,9 s, zużywając 12 896 tokenów rozumowania, za 0,697 USD (2,69 zł). Opus nie oddał odpowiedzi ani razu. Przy limicie 16 tys. tokenów trzy razy zużył całość na myślenie, tak samo skończyła się próba z limitem 32 tys. i próba na niskim poziomie rozumowania. Z zapisu ostatniej próby widać, że zadania 2-4 rozwiązał poprawnie w pierwszych akapitach, a potem utknął w ręcznym przeliczaniu permutacji. Pięć prób kosztowało 1,93 USD (7,45 zł).
To wynik w opisanym budżecie, a nie dowód, że Opus liczy źle: brak odpowiedzi to co innego niż błędne rozwiązanie, a z wyższym limitem wynik mógłby wyjść inaczej. Korzystając z Opusa przez API, ustawiłbym wysoki limit tokenów i sprawdzał w odpowiedzi pole stop_reason: wartość max_tokens znaczy, że odpowiedź ucięto na limicie. Ten sam problem u innych modeli opisałem w tekście o AI, która myśli za długo.
Mail po polsku o podwyżce cen
Polecenie: mail sklepu z kawą o podwyżce o 12% od 1 listopada, z kodem rabatowym i ochroną abonamentów, 120-170 słów, ciepło i bez emoji. Oba modele zmieściły się w limitach. Oceniali w ciemno Gemini 3.1 Pro i Grok 4.7, każdy w dwóch kolejnościach, żeby żaden model nie oceniał sam siebie. Opus dostał 9,1 pkt, Astra 7,7, a cztery werdykty na cztery przypadły Opusowi.
Opus zaczyna: „piszemy do Ciebie z wiadomością, której wolelibyśmy nie wysyłać”. Astra kończy zdaniem o „zapraszaniu kaw do codzienności”, które obaj sędziowie wskazali jako sztuczne, i wstawia pogrubienia w składni markdown, które w zwykłym mailu pokażą się jako gwiazdki. Wynik zgadza się z moim Laboratorium: w teście pisania po polsku Opus 5.5 ma 90,1 pkt, a Astra 85,3.
JSON z maila z zamówieniem
Mail od palarni kawy miał pułapki: korektę ilości w dopisku („kubków jednak 45, nie 40”), cenę tylko brutto do przeliczenia na netto, dwa telefony do zapisu w formacie +48, osobny adres do faktur i termin podany słownie. Model miał zwrócić sam JSON, bez bloku kodu. Sprawdziłem go biblioteką jsonschema i porównałem 18 pól.
Oba modele zwróciły czysty JSON zgodny ze schematem i trafiły 18/18 pól, łącznie z torbami po 1,00 zł netto (z 1,23 zł brutto) i wartością 2442,18 zł po rabacie 7%. Astra była szybsza (8,6 wobec 11,0 s), Opus tańszy (0,022 wobec 0,032 USD).
Długi kontekst: ustawa o prawach konsumenta
Dokument: tekst jednolity ustawy o prawach konsumenta (Dz.U. 2023 poz. 2759), 91,8 tys. znaków. W około 60% długości wstawiłem fałszywą adnotację z numerem kontrolnym i nazwiskiem. Pytania dotyczyły tej adnotacji, liczby wyjątków w art. 38 ust. 1 (14), terminu odstąpienia od umowy ubezpieczenia (30 dni, art. 40 ust. 2), wygaśnięcia prawa odstąpienia (12 miesięcy, art. 29 ust. 1), ustaw zmieniających w obwieszczeniu (3, najnowsza z 14 kwietnia 2023 r.) oraz kary od Prezesa UOKiK, której w dokumencie nie ma.
Oba modele: 6/6, łącznie z odpowiedzią „brak w dokumencie” na pytanie o karę. Opus dodał, gdzie znalazł adnotację, i przypomniał, co mówi art. 7a ust. 2. Astra odpowiedziała w 4,1 s bez ani jednego tokenu rozumowania, Opus w 9,2 s. Za Astrę zapłaciłem jednak 0,367 USD, a za Opusa 0,193 USD, choć Opus policzył ten sam tekst jako o 59% dłuższy.
Benchmarki producentów
Liczby z ogłoszenia Opusa 5.5 (22.09.2026). Wyniki Astry to dane OpenAI zestawione przez Anthropic. Opus wygrywa w czterech z sześciu testów, w których oba modele mają wynik.
| Test | Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0 | 66,4% | 57,9% |
| FrontierCode v1.1 | 54,4% | 53,3% |
| GDPval-AA v2.1 (Elo) | 1846 | 1542 |
| Humanity’s Last Exam | 67,7% | 57,2% |
| AutomationBench | 40,0% | 41,4% |
| Terminal-Bench-Science | 58,7% | 64,6% |
Trzy zastrzeżenia. Opus był mierzony na max (w Terminal-Bench na xhigh), a Astra w Terminal-Bench na high. AutomationBench Zapier przeprowadził bez modelu zapasowego, więc każda blokada zabezpieczeń Opusa liczyła się jako porażka, co może tłumaczyć całą różnicę 1,4 pkt. Tabelę ułożyło też Anthropic, czyli strona, która w niej wygrywa. Firma twierdzi ponadto, że Opus na domyślnym medium wygrywa z Astrą w FrontierCode za około 20% jej kosztu na zadanie. W moich zadaniach Opus kosztował 64% tego co Astra, czyli różnica była dużo mniejsza.
W niezależnym indeksie Artificial Analysis w wersji 5.0 oba modele na poziomie max stoją prawie równo: Opus 5.5 ma 58 pkt, Astra 57. Opus wypisuje odpowiedź szybciej, 97 wobec 76 tokenów na sekundę (stan na 29.10.2026).
Cena API i dopłata za długi kontekst
| Za milion tokenów | Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Wejście | 4 USD | 10 USD |
| Wyjście | 20 USD | 50 USD |
| Odczyt z pamięci podręcznej | 0,20 USD | 1,00 USD |
| Ponad 272 tys. tokenów wejścia | bez zmian | 20 i 75 USD za całe zapytanie |
| Kontekst / maks. odpowiedź | 1 mln / 128 tys. | 1,05 mln / 128 tys. |
| Wiedza do | czerwiec 2026 | 30 kwietnia 2026 |
Ceny bez VAT, sprawdzone w cennikach obu firm 29.10.2026 i takie same jak w dniu testu. Opus kosztuje tyle samo w całym oknie miliona tokenów. U Astry zapytanie z ponad 272 tys. tokenów wejścia kosztuje podwójnie za wejście i półtora raza za wyjście, i to za całe zapytanie. Kto szuka tańszego modelu OpenAI, ma dziś GPT-6.1 Sol (2 i 10 USD) i od 26 października GPT-6.1 Terra (1 i 5 USD), a GPT-6.1 Astra OpenAI wycofało przed premierą ze względów bezpieczeństwa. Jak Terra i Sol wypadły po polsku, pokazuję w teście GPT-6.1 Terra vs Sol.
Abonamenty: Claude Pro czy ChatGPT Plus
Podstawowe plany kosztują w Polsce tyle samo: Claude Pro i ChatGPT Plus po 99,99 zł miesięcznie. Różnica jest w tym, co dostajesz. Opus 5.5 jest w Claude Pro w zwykłym czacie. W ChatGPT Plus Astra działa tylko w ChatGPT Work i Codex, a dokumentacja Codex szacuje limit na 5-45 wiadomości na pięć godzin. Astrę w zwykłym czacie, jako GPT-6 Pro, daje dopiero plan Pro. Aktualne ceny wszystkich planów w złotych zebrałem w cennikach Claude i ChatGPT w Polsce.
Jak testowałem
- Dostęp: OpenRouter, modele anthropic/claude-opus-5.5 (dostawca: Claude Platform on AWS) i openai/gpt-6-astra (OpenAI), 29 września 2026.
- Ustawienia: te same polecenia, rozumowanie medium (domyślne dla Opusa), temperatura domyślna, limit odpowiedzi 16 tys. tokenów (24 tys. dla kodu i strony). Jeden przebieg na zadanie, a czasy zależą od obciążenia serwerów, więc przy powtórce mogą wyjść inne.
- Ocena: kod przez pytest i ukryte testy, strona w Chrome bez okna, dane, zagadki i JSON przez porównanie z wynikiem skryptu, mail i wygląd przez sędziów Gemini 3.1 Pro i Grok 4.7 w ciemno.
- Koszt całego testu: 4,91 USD za odpowiedzi modeli (w tym 1,93 USD za nieudane próby Opusa) i 0,35 USD za sędziów, razem 5,26 USD (20,29 zł).
Nie testowałem pracy agentowej z narzędziami ani zadań trwających godzinami, więc tego wyboru ten test nie rozstrzyga. Porównanie Opusa z droższym modelem Anthropic jest w tekście Opus 5.5 czy Fable 5.1.
Najczęstsze pytania
Co jest lepsze: Claude Opus 5.5 czy GPT-6 Astra?
W moich ośmiu zadaniach oba zrobiły wszystko poprawnie, ale Opus lepiej pisał po polsku, zrobił ładniejszą stronę i był 1,56 raza tańszy. Astra wygrała dogrywkę z trudnej matematyki (4/4 wobec 0/4).
Który wychodzi taniej?
Opus 5.5: 0,89 USD wobec 1,39 USD za te same zadania. Przewaga jest mniejsza niż 2,5 raza z cennika, bo Opus liczy polski tekst jako około 1,6 raza więcej tokenów. Przy krótkich tekstach Astra bywa tańsza.
Który lepiej pisze po polsku?
Opus 5.5. Sędziowie Gemini i Grok ocenili jego mail na 9,1 pkt, mail Astry na 7,7. W Laboratorium promptowy.com Opus ma 90,1 pkt, Astra 85,3.
Czy GPT-6 Astra jest w ChatGPT Plus?
Tylko w ChatGPT Work i Codex, z limitem około 5-45 wiadomości na pięć godzin. W zwykłym czacie Astra (jako GPT-6 Pro) jest od planu Pro.
Czy Opus podał błędne odpowiedzi w dogrywce?
Nie. Nie oddał żadnej odpowiedzi w przyznanym limicie tokenów. Z wyższym limitem wynik mógłby być inny, ale to wymaga osobnego testu obu modeli.
Czytasz Promptowego częściej? Dodaj go do preferowanych źródeł w Google, a nowe teksty będą wyżej w Twoich wynikach.
Źródła
- Mój test: OpenRouter, 8 zadań i dogrywka, sędziowie Gemini 3.1 Pro i Grok 4.7 (29.09.2026)
- Anthropic: Introducing Claude Opus 5.5 - benchmarki, koszt na zadanie (22.09.2026)
- Anthropic: cennik API (dostęp 29.10.2026)
- Anthropic: przegląd modeli - kontekst, wiedza, poziomy wysiłku (dostęp 29.10.2026)
- Anthropic: stop_reason (dostęp 21.10.2026)
- OpenAI: karta modelu GPT-6 Astra - ceny, próg 272 tys. tokenów, kontekst, wiedza (dostęp 29.10.2026)
- Artificial Analysis: Opus 5.5 vs GPT-6 Astra - indeks v5.0 i szybkość (dostęp 29.10.2026)
- The Decoder: OpenAI zatrzymuje GPT-6.1 Astra (wrzesień 2026)
- OpenAI: cennik i limity Codex - Astra 5-45 wiadomości na 5 godzin w Plus (dostęp 21.10.2026)
- Sejm, API ELI: ustawa o prawach konsumenta, Dz.U. 2023 poz. 2759
Sprawdzone: 29.10.2026
 Model Alibaby próbował wysłać plik do Pekinu. Cohere ujawniło wyniki testówNewsy
 Claude wysłał fałszywy donos do policji w sprawie zabójstwa - Anthropic ujawnia wyniki testówNewsy
 Fraza z 1000 wyszukiwań i trudnością 1 okazała się kolarska. Sprawdzaj wyniki, nie wskaźnikiWarsztat
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →- przelomowy.plLaboratorium AutoDNA w Szanghaju: agenci AI sami prowadzą eksperymenty z DNA
- generatornia.plTapeta świąteczna na telefon z AI: kompozycja 9:16 i gotowe prompty
- dygot.plOpenAI wchodzi w ropę. Twórcy ChatGPT pomogą ADNOC planować wydobycie
- jutropis.plUstawa o AI podpisana. Skargi do KRiBSI i testy dla firm