


Modele decyzyjne AI: ranking, polski basal i test po polsku
Model decyzyjny wybiera odpowiedź z listy zamiast pisać tekst. Clef, Clef-flash, Strands Decider 2B i Kev - licencje, ceny, wymagania i test na polskich zgłoszeniach.
Spis treści 13
- Jak to działa
- Ranking Artificial Analysis: Decision Index
- Co mierzą cztery testy
- JevBench i polski basal
- Mój test 13.10: 50 polskich zgłoszeń i 10 decyzji o narzędziach
- Lokalnie na RTX 4090
- Kiedy model decyzyjny, a kiedy LLM
- Ceny API
- Dostęp z Polski
- Modele decyzyjne: kto, co i gdzie
- Jak zacząć w 10 minut
- Najczęstsze pytania
- Źródła
👁 473 przeczytań
Model decyzyjny to model AI, który nie pisze tekstu, tylko wybiera odpowiedź z listy, którą mu podajesz, i mówi, na ile jest pewny: zamiast „to zgłoszenie dotyczy chyba płatności” dostajesz platnosci: 0,97, a Twój kod sam decyduje, co dalej. 30 października 2026 w rankingu Artificial Analysis prowadzi d1-ultra od Liquid AI (65,2 pkt), tuż przed SubQ Snap 1.1 (65,0) i Elephant 9B od Baseten (64,7), który kosztuje tylko 8,4 USD za milion zadań. Polski basal-omni-1.0-ultra Remka Kinasa jest 9. wśród otwartych modeli w drugim rankingu, JevBench. W moim teście na 47 polskich zgłoszeniach modele decyzyjne trafiały dział w 41-44 przypadkach, a Claude Haiku 5.5 w 45, tyle że od 2,7 do 5,4 raza wolniej.
Ujawnienie: model Jev znam z wcześniejszego rozpoznania. We wrześniu napisałem do niego prostego klienta API z myślą o własnych narzędziach redakcyjnych. TypeSafe nie zamawiało ani nie opłaciło tego przewodnika, a wyniki Jeva podaję z niezależnych pomiarów Artificial Analysis i z mojego testu, w którym wszystkie modele dostały te same zadania.
Jak to działa
Zwykły model językowy pisze odpowiedź słowo po słowie, nawet gdy ma zwrócić jedno słowo albo JSON. Może więc odpowiedzieć opcją spoza listy, a jego „pewność” to liczba, którą sam wymyślił. Model decyzyjny dostaje stan (np. treść zgłoszenia) i nazwane pytania z zamkniętymi odpowiedziami, a zwraca prawdopodobieństwo każdej opcji. Pytania są trzech typów: wybór z listy (choice), tak/nie (noul) i ocena na skali (score). Kilka pytań, np. dział, pilność i nastrój klienta, rozstrzyga w jednym wywołaniu. Ile kosztuje i jak szybko działa takie rozwiązanie w porównaniu z małym LLM, zmierzyłem w tekście modele decyzyjne vs małe modele językowe.
Płacisz tylko za tokeny wejścia, bo modele decyzyjne nic nie generują. To dlatego milion klasyfikacji kosztuje w nich kilkanaście albo kilkadziesiąt dolarów, a w małych LLM-ach od stu do kilku tysięcy.
Ranking Artificial Analysis: Decision Index
Decision Index wystartował 13 października 2026 z 11 modelami. 30 października jest w nim 20 modeli decyzyjnych, a w czołówce zmieniło się prawie wszystko: Jev 1.13, lider pierwszej wersji, spadł na 6. miejsce. Wynik to średnia z czterech testów (opis niżej), koszt to średni koszt zadania pomnożony przez milion, czas to mediana na zadanie.
| Model (firma) | Indeks | Koszt 1 mln zadań | Czas |
|---|---|---|---|
| d1-ultra (Liquid AI) | 65,2 | 31,8 USD | 93 ms |
| SubQ Snap 1.1 (Subquadratic) | 65,0 | 30,3 USD | 190 ms |
| Elephant 9B (Baseten) | 64,7 | 8,4 USD | 165 ms |
| Drex Max (Nace.AI) | 63,7 | 46,1 USD | 353 ms |
| Drex 2.0 (Nace.AI) | 57,9 | 41,4 USD | 252 ms |
| Jev 1.13 (TypeSafe) | 57,5 | 41,5 USD | 127 ms |
| Jev 1.14 (TypeSafe) | 57,1 | 41,5 USD | 78 ms |
| Decider v1.2 (Perplexity) | 56,2 | 15,1 USD | 206 ms |
| GLiDE (Fastino) | 53,9 | 119,0 USD | 217 ms |
| Microsoft-Decision-1 | 53,8 | 30,7 USD | 207 ms |
| Decider v1.1 27B (Perplexity) | 53,1 | 16,5 USD | 170 ms |
| Mercury Decide (Inception) | 52,7 | 15,2 USD | 500 ms |
| Celeris-1 Decision (Celeris) | 52,3 | 31,6 USD | 63 ms |
| Drex 1.5 (Nace.AI) | 50,7 | 34,5 USD | 186 ms |
| d1 (Liquid AI) | 50,3 | 15,1 USD | 299 ms |
| Decider Flash v1.2 (Perplexity) | 50,2 | 8,2 USD | 110 ms |
| Clef (Cloudflare) | 48,6 | 199,4 USD | 309 ms |
| GPT-6 Luna Decisions (OpenAI) | 48,5 | 78,9 USD | 168 ms |
| Clef-Flash (Cloudflare) | 45,8 | 31,6 USD | 298 ms |
| Clef-Omni (Cloudflare) | 44,3 | 123,1 USD | 172 ms |
Te same testy Artificial Analysis puściło na modelach językowych (poziom rozumowania w nawiasie):
| Model językowy | Indeks | Koszt 1 mln zadań | Czas |
|---|---|---|---|
| Claude Opus 5.5 (max) | 79,0 | 51 295 USD | 3571 ms |
| Claude Opus 5.5 (low) | 75,4 | 6688 USD | 1870 ms |
| GPT-6.1 Sol (low) | 71,5 | 2048 USD | 2888 ms |
| Claude Haiku 5.5 (max) | 68,4 | 2073 USD | 2658 ms |
| Claude Haiku 5.5 (low) | 60,6 | 184 USD | 1434 ms |
| GPT-6 Luna (low) | 55,2 | 131 USD | 1500 ms |
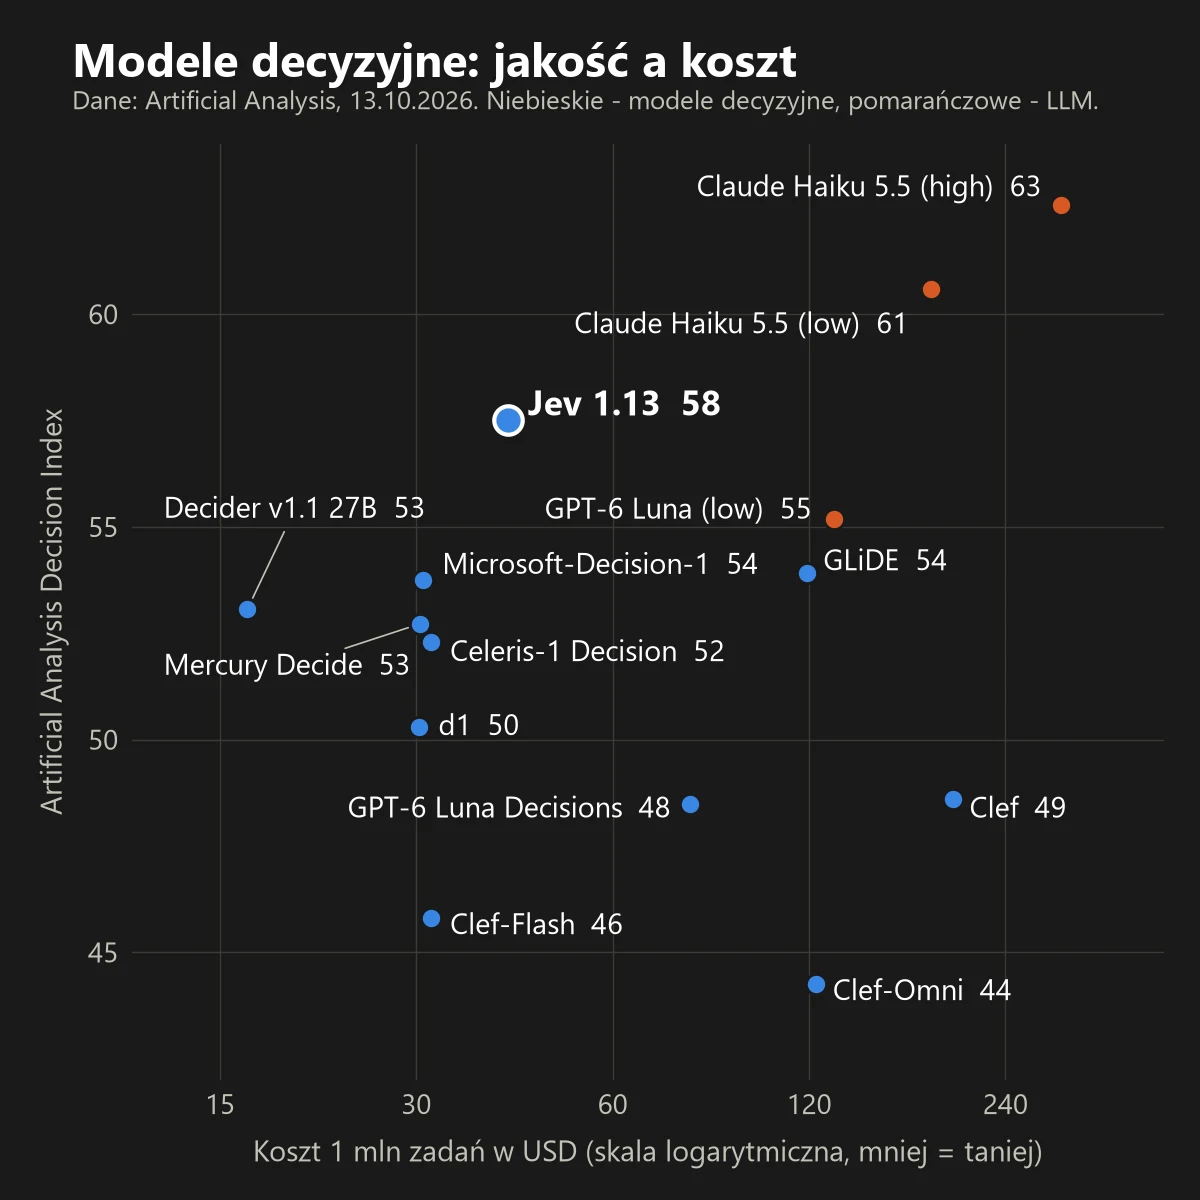
Co z tego wynika:
- Trzy modele decyzyjne przegoniły tanie LLM-y. d1-ultra, SubQ Snap 1.1 i Elephant 9B mają więcej punktów niż Claude Haiku 5.5 na low (60,6) i GPT-6 Luna (55,2), a są od 4 do 22 razy tańsze i od kilku do kilkunastu razy szybsze. Wyżej są tylko duże modele: Opus 5.5, GPT-6.1 Sol i Haiku 5.5 na max.
- Elephant 9B to dziś najlepszy stosunek jakości do ceny. 64,7 pkt przy 8,4 USD za milion zadań. Tańszy jest tylko Decider Flash v1.2 (8,2 USD), ale ma 14,5 pkt mniej.
- GLiDE ma tyle punktów co Microsoft-Decision-1, a kosztuje prawie 4 razy więcej (119 wobec 30,7 USD). Fastino rozlicza też wewnętrzne przejścia modelu, który przy niepewności „myśli” dłużej.
- Clef jest najdroższy w rankingu (199 USD w cenie Workers AI 0,24 USD za mln tokenów), choć na OpenRouterze ten sam model hostuje taniej inny dostawca.
- GPT-6 Luna w trybie Decisions wypada gorzej niż jako zwykły LLM (48,5 wobec 55,2), za to jest 9 razy szybsza.
Co mierzą cztery testy
| Test | Co sprawdza | Waga |
|---|---|---|
| AA-Omniscience-Decision | wiedza i skłonność do zmyślania | 25% |
| HLE-MultiChoice | trudne rozumowanie | 25% |
| When2Call | kiedy wywołać narzędzie, dopytać albo odmówić | 25% |
| WildGuardTest | klasyfikacja bezpieczeństwa | 25% |
- AA-Omniscience-Decision: 500 niepublicznych pytań z wiedzy, każde z pięcioma opcjami: cztery odpowiedzi (jedna poprawna) i „nie wiem”. Połowa wagi to trafność, połowa to odsetek przypadków, w których model nie znał odpowiedzi i wybrał „nie wiem” zamiast zgadywać.
- HLE-MultiChoice: 513 tekstowych pytań wielokrotnego wyboru z Humanity’s Last Exam (z 2500 pytań całego zestawu).
- When2Call: zestaw NVIDII. Model widzi rozmowę i listę narzędzi i wybiera: odpowiedzieć sam, wywołać narzędzie, dopytać o brakujące dane albo przyznać, że nie da rady.
- WildGuardTest: zestaw Ai2. Trzy decyzje: czy prośba użytkownika jest szkodliwa, czy odpowiedź asystenta jest odmową i czy ta odpowiedź jest szkodliwa. Wynik to średnie F1.
Modele decyzyjne dostają stan i pytania przez swoje API, a Artificial Analysis liczy jako odpowiedź opcję z najwyższym prawdopodobieństwem (przy pytaniu tak/nie: „tak” od 0,5). Modele językowe dostają to samo jako tekst i muszą oddać JSON ze strukturą wymuszoną przez structured output.
Wyniki w poszczególnych testach
| Model | Wiedza | „Nie wiem” | When2Call | WildGuard |
|---|---|---|---|---|
| d1-ultra | 31,6 | 84,5 | 92,6 | 95,4 |
| SubQ Snap 1.1 | 20,2 | 85,7 | 94,6 | 94,9 |
| Elephant 9B | 11,6 | 93,2 | 94,8 | 93,3 |
| Drex Max | 27,6 | 71,3 | 94,0 | 95,5 |
| Jev 1.13 | 34,6 | 35,2 | 80,7 | 93,6 |
| Decider v1.2 | 39,4 | 16,5 | 87,7 | 94,4 |
| Microsoft-Decision-1 | 28,2 | 39,8 | 81,9 | 88,2 |
| Celeris-1 Decision | 37,8 | 0,0 | 83,7 | 93,3 |
| d1 | 41,0 | 1,7 | 77,4 | 90,9 |
| Claude Haiku 5.5 (low) | 52,4 | 54,6 | 72,6 | 92,6 |
| GPT-6 Luna (low) | 66,0 | 0,0 | 77,0 | 88,5 |
„Wiedza” to trafność w AA-Omniscience-Decision, „Nie wiem” to odsetek przypadków, w których model przyznał się do niewiedzy zamiast zgadywać. Wniosków jest kilka:
- W wyborze narzędzi i klasyfikacji nowa czołówka bije małe LLM-y o 15-22 punkty w When2Call, przy kilkukrotnie niższym koszcie.
- W wiedzy modele decyzyjne zostają daleko w tyle: 12-41% trafności wobec 52% u Haiku i 66% u Luny. Fakty powinny być w stanie, który model dostaje, a nie w jego pamięci.
- Nowe modele nauczyły się mówić „nie wiem”. Elephant 9B robi to w 93% przypadków, d1-ultra w 85%. Pierwsza fala (Celeris, d1, Decider v1.1) zgadywała w ponad 85% takich przypadków.
- Rozumowanie zostaje słabą stroną całej kategorii: w HLE najlepszy model decyzyjny (Jev 1.13) ma 20,9%, a Claude Haiku 5.5 na low 23,6%.
JevBench i polski basal
Drugi ranking modeli decyzyjnych prowadzi hobbystycznie Florian Standhartinger w serwisie Benchmark Heaven, który deklaruje niezależność od TypeSafe. Każdy system dostaje te same 1500 decyzji, a główna tabela układa je według Capability Score, czyli trafności i kalibracji. Startują tylko modele „klasy Jeva”, najwyżej 2 razy droższe i 2 razy wolniejsze od niego. Osobno są tablice otwartych modeli i usług API.
17 października Remek Kinas, AI researcher w Ingenix.ai i współtwórca Bielika, ogłosił, że jego basal-omni-1.0-ultra prowadzi wśród otwartych modeli z wynikiem 82,5 pkt. Prowadzenie trwało krótko. Benchmark przeszedł na metodę v1.7 i doszły nowe modele, więc 29 października basal ma 82,1 pkt i jest 9. na tablicy otwartych modeli:
| Model (otwarte wagi) | Capability Score |
|---|---|
| baselabs mammoth-1 (27B) | 85,2 |
| KnowLine 31B-Gen1 | 85,2 |
| Fastino GLiDE 1.2 | 84,9 |
| H2O-Lightning-31B (H2O.ai) | 84,3 |
| Perplexity Decider v1.1 27B | 82,7 |
| basal-omni-1.0-ultra (Remek Kinas) | 82,1 (9. miejsce) |
| Jev 1.13 (punkt odniesienia, zamknięty) | 77,1 |
Na tablicy usług API (28.10) prowadzi kettei-fat od Sqwish z 86,3 pkt, przed Super Deciderem (85,9). d1-ultra ma tam 80,5 pkt, mniej niż Drex Max (84,2) i SubQ Snap 1.1 (81,9). Oba rankingi mierzą inne zadania inną metodą, więc kolejność się nie pokrywa.
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
basal jest na licencji Apache-2.0, w trzech rozmiarach: mini (4 mld parametrów), max (12 mld) i ultra (31 mld), na bazie Gemmy 4. Mini i max mają wersje GGUF do Ollamy i llama.cpp oraz MLX do Maca. W Decision Index basala nie ma.
Mój test 13.10: 50 polskich zgłoszeń i 10 decyzji o narzędziach
Decision Index jest po angielsku, więc dorzuciłem własny test po polsku. Napisałem 50 zgłoszeń do sklepu internetowego: płatności, dostawa, zwroty, konto, awarie, sprzedaż i spam, część bez polskich znaków i na granicy dwóch działów. Do tego 10 rozmów w stylu When2Call: asystent ma cztery narzędzia (status zamówienia, anulowanie, dostępność w sklepie, etykieta zwrotna) i musi wybrać, czy odpowiedzieć sam, wywołać narzędzie, dopytać, czy odmówić. Klucz odpowiedzi ustaliłem przed uruchomieniem modeli.
- Modele decyzyjne: 9 modeli z pierwszej wersji rankingu dostępnych na OpenRouterze, przez endpoint /api/alpha/decisions, w jednym wywołaniu dwa pytania: dział (7 opcji) i pilność (tak/nie, próg 0,5).
- Modele językowe: Claude Haiku 5.5 i GPT-6 Luna przez OpenRouter, rozumowanie „low”, temperatura 0, JSON wymuszony schematem.
- Czas mierzyłem z Polski, razem z siecią i pośrednictwem OpenRoutera, więc jest wyższy niż w pomiarach Artificial Analysis.
| Model | Dział (z 47) | Pilność (z 50) | Narzędzia (z 10) |
|---|---|---|---|
| Jev 1.13 | 41 | 46 | 10 |
| Microsoft-Decision-1 | 44 | 42 | 10 |
| Decider v1.1 27B | 44 | 48 | 10 |
| Mercury Decide | 44 | 46 | 9 |
| d1 | 42 | 43 | 10 |
| Clef | 44 | 45 | 10 |
| Clef-Flash | 44 | 44 | 6 |
| Clef-Omni | 42 | 45 | 6 |
| GPT-6 Luna Decisions | 42 | 48 | 10 |
| Claude Haiku 5.5 (low) | 45 | 46 | 10 |
| GPT-6 Luna (low) | 45 | 45 | 10 |
Dlaczego dział z 47, a nie z 50: w trzech zgłoszeniach wszystkie 11 modeli wybrało inną odpowiedź niż mój klucz. „Czy mogę rozłożyć płatność na raty?” oznaczyłem jako sprzedaż, a modele jako płatności; „link do zapłaty zwraca błąd 404” jako awarię, a modele jako płatności; „duplikat paragonu do zwrotu” jako płatności, a modele jako zwrot. Uznałem, że to mój klucz był dyskusyjny, i liczę wynik bez nich. Na pełnych 50 każdy model ma po prostu 3 punkty mniej.
Co pokazał test:
- Na prostej klasyfikacji po polsku różnice są małe. Najlepsze modele decyzyjne (Microsoft-Decision-1, Decider, Mercury Decide, Clef) trafiły 44 z 47, Claude Haiku 5.5 i GPT-6 Luna po 45. Jev zrobił 41 i mylił się głównie przy zgłoszeniach na granicy działów (pusta paczka, iskrzący ekspres, kod rabatowy).
- Pewność modelu decyzyjnego da się wykorzystać. Gdy Jev podawał pewność co najmniej 0,9, miał rację w 37 z 39 zgłoszeń, a jego pomyłki miały zwykle pewność 0,6-0,8. Decider: 39 z 41 przy pewności od 0,9. Taki próg odsiewa przypadki do człowieka albo do większego modelu.
- Próg pilności trzeba ustawić na własnych danych. Jev myli się w pilności przy prawdopodobieństwach 0,49-0,6, czyli tuż przy domyślnym progu 0,5. Microsoft-Decision-1 przy progu 0,5 oznaczył jako pilne 8 spraw, które mogły poczekać.
- Wybór narzędzia po polsku: 7 modeli decyzyjnych i oba LLM-y miały 10 na 10, Mercury Decide 9. Clef-Flash i Clef-Omni tylko 6: wywoływały narzędzie, gdy brakowało numeru zamówienia, i odmawiały odpowiedzi na proste pytanie o 14 dni na zwrot.
- Czas i koszt to główna przewaga. Modele decyzyjne odpowiadały od 2,7 do 5,4 raza szybciej niż Haiku, a milion takich zadań kosztowałby od 4,4 USD (Mercury Decide w promocyjnej cenie) do 26,8 USD (Jev). Jev liczy po polsku więcej tokenów niż inni: średnio 637 na zadanie, przy 273 u Microsoft-Decision-1.
Koszt całego testu: 0,022 USD na OpenRouterze za 660 zapytań. Nowych modeli z czołówki (d1-ultra, SubQ Snap, Elephant 9B, Drex) w tym teście nie było.
Lokalnie na RTX 4090
basal-omni-1.0-mini (19.10)
19 października uruchomiłem najmniejszego basala (plik GGUF Q8_0, 7,9 GB) przez Ollamę i silnik basal-serve na tym samym zestawie co test z 13.10. Zajął 5,1 GB pamięci karty, a cały test trwał 20 sekund. Dział trafił w 42 z 47 zgłoszeń, o jedno więcej niż Jev 1.13 i o dwa mniej niż najlepsze modele z API. Pilność: 47 z 50, wybór narzędzia: 10 z 10, mediana 137 ms na decyzję. Przy pewności od 0,9 miał rację w 35 z 40 przypadków, więc i tu progi trzeba ustawić na własnych danych. Instrukcja dla Windows, llama.cpp i Maca jest w tekście basal lokalnie.
Pierwszy test (5.10)
Pierwszy test zrobiłem 5 października: 30 polskich zgłoszeń (6 działów i pilność), otwarte modele decyzyjne uruchomione lokalnie, LLM-y przez Ollamę i OpenRouter.
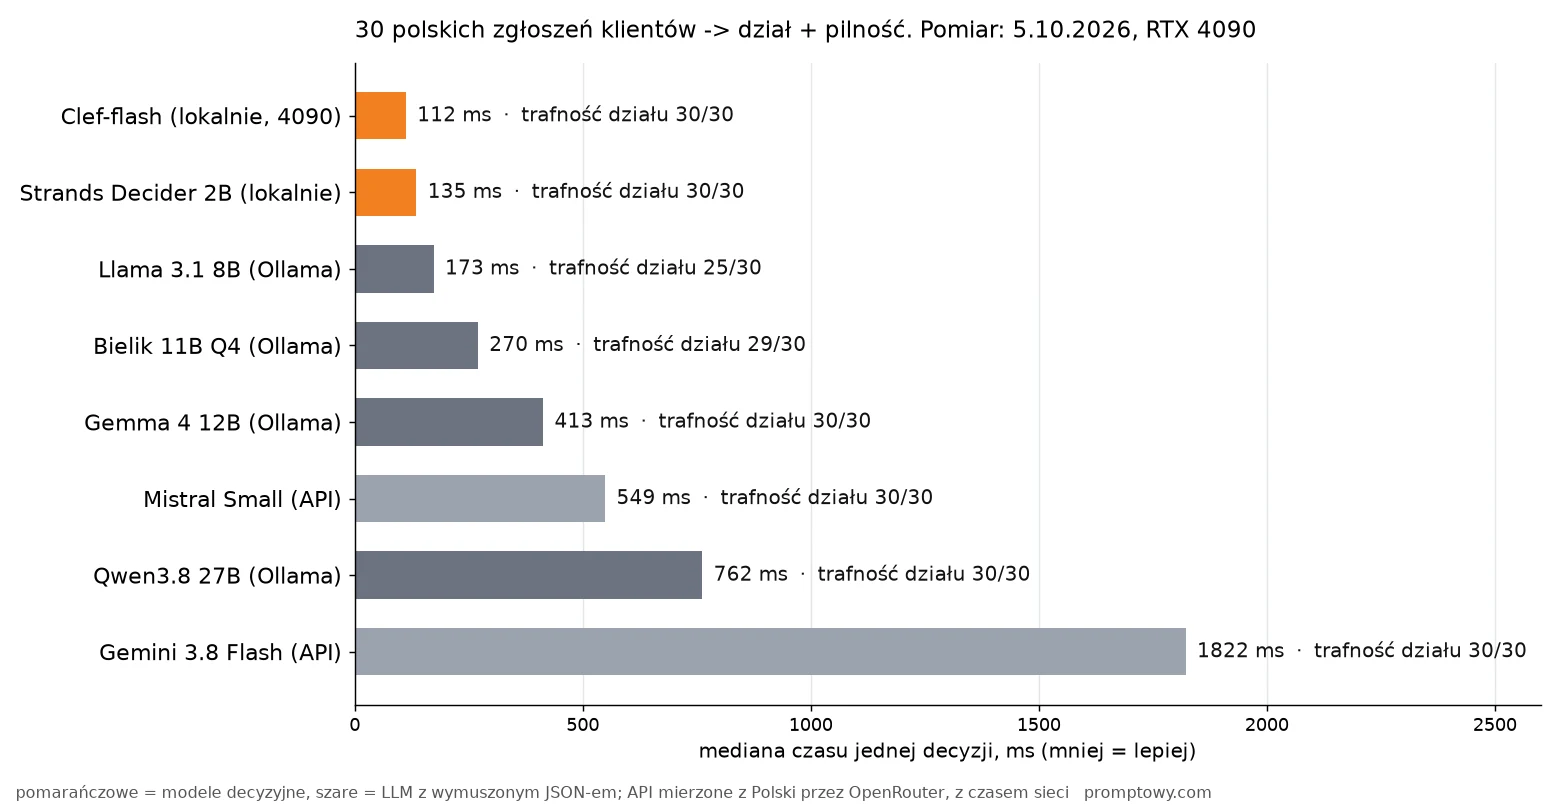
| Model | Dział (PL) | Pilność (PL) | Mediana czasu |
|---|---|---|---|
| Clef-flash (lokalnie) | 30/30 | 26/30 | 112 ms |
| Strands Decider 2B (lokalnie) | 30/30 | 24/30 | 135 ms |
| Llama 3.1 8B (Ollama) | 25/30 | 23/30 | 173 ms |
| Bielik 11B Q4 (Ollama) | 29/30 | 21/30 | 270 ms |
| Gemma 4 12B (Ollama) | 30/30 | 26/30 | 413 ms |
| Qwen3.8 27B (Ollama) | 30/30 | 27/30 | 762 ms |
| Mistral Small 2603 (API) | 30/30 | 19/30 | 549 ms |
| Gemini 3.8 Flash (API) | 30/30 | 26/30 | 1822 ms |
- Lokalnie model decyzyjny jest najszybszy. Clef-flash na tej samej karcie odpowiadał 3,7 raza szybciej niż Gemma 4 12B i prawie 7 razy szybciej niż Qwen3.8 27B.
- Pamięć: Clef-flash zajął 18,3 GB VRAM, Strands Decider 2B 3,8 GB.
- Próg pilności po polsku był przesunięty: Strands Decider przy progu 0,5 nie oznaczył nic jako pilne, przy 0,4 trafiał 26/30. Clef-flash przy 0,95 miał tylko 2 błędy.
- Pełny Clef 27B (55 GB w bf16) nie mieści się na 24 GB bez kwantyzacji, której Cloudflare nie wydał.
Kiedy model decyzyjny, a kiedy LLM
Model decyzyjny ma sens, gdy odpowiedź jest z zamkniętej listy, a decyzji jest dużo:
- klasyfikacja zgłoszeń: dział, pilność, język, czy klient grozi odejściem, kilka pytań w jednym wywołaniu,
- routing: do którego zespołu, modelu albo procesu ma trafić sprawa (przepis z kodem pokazałem w tekście o routingu zgłoszeń),
- moderacja: czy komentarz łamie regulamin, czy prośba jest szkodliwa, czy to spam,
- wybór narzędzia w agencie: odpowiedzieć, wywołać narzędzie, dopytać czy odmówić,
- bramki jakości: przepuścić, poprawić albo eskalować do człowieka, z progiem z prawdopodobieństwa.
Model językowy jest lepszy, gdy trzeba napisać tekst, odpowiedź do klienta albo kod, gdy odpowiedź zależy od wiedzy o świecie, której nie ma w stanie, gdy pytanie jest otwarte i nie da się podać listy opcji albo gdy decyzji jest kilka dziennie i wygoda jednego narzędzia wygrywa z oszczędnością. Najlepiej działa połączenie: model decyzyjny rozstrzyga pewne przypadki, a te poniżej progu idą do LLM-a albo do człowieka.
To samo zadanie da się zrobić LLM-em, któremu każesz zwrócić JSON zgodny ze schematem (structured output). Różnice:
| Model decyzyjny | LLM + structured output | |
|---|---|---|
| Odpowiedź spoza listy | niemożliwa z konstrukcji | wykluczona przy ścisłym schemacie, ale parser może się wyłożyć (patrz model zwraca zły JSON) |
| Pewność | prawdopodobieństwo dla każdej opcji | brak albo liczba „wymyślona” przez model |
| Wiele pytań naraz | w jednym wywołaniu, równolegle | każde pole to kolejne wygenerowane tokeny |
| Uzasadnienie | brak (wyjątek: Celeris-1 na życzenie) | może dopisać, dlaczego |
| Wiedza i trudne rozumowanie | słabiej (AA: wiedza 28-41%) | lepiej (AA: Haiku 5.5 52%, Luna 66%) |
| Koszt w chmurze | tylko wejście | wejście + wyjście (+ rozumowanie) |
Ceny API
Ceny za milion tokenów wejścia z cenników producentów i OpenRoutera, sprawdzone 13 października 2026. Za wyjście nikt nie liczy. Nowszych modeli (d1-ultra, SubQ Snap, Elephant, Drex, Decider v1.2) w tabeli nie ma; ich koszt miliona zadań jest w rankingu wyżej.
| Model | Cena producenta | OpenRouter |
|---|---|---|
| Jev 1.13 (TypeSafe) | 0,042 USD | 0,042 USD |
| GLiDE (Fastino) | 0,15 USD (liczone są też wewnętrzne przejścia) | brak |
| Microsoft-Decision-1 | 0,042 USD (Microsoft Foundry) | 0,042 USD |
| Decider v1.1 27B (Perplexity) | 0,02 USD | 0,02 USD |
| Mercury Decide (Inception) | 0,04 USD, obecnie promocja 0,02 USD | 0,02 USD, jest też wariant darmowy |
| Celeris-1 Decision | 0,04 USD | brak |
| d1 (Liquid AI) | 0,04 USD | 0,04 USD |
| Clef (Cloudflare) | 0,24 USD (Workers AI) | od 0,042 USD (inny dostawca) |
| Clef-Flash (Cloudflare) | 0,038 USD (od 9.10, wcześniej 0,09) | od 0,021 USD |
| Clef-Omni (Cloudflare) | 0,15 USD | 0,15 USD |
| GPT-6 Luna Decisions (OpenAI) | 0,10 USD (+10% przy przetwarzaniu w UE) | 0,10 USD |
Cena za token to nie wszystko. Modele liczą tokeny różnymi tokenizerami, a ten sam polski tekst może u jednego mieć dwa razy więcej tokenów niż u drugiego. Rzeczywisty koszt lepiej czytać z kolumny „koszt 1 mln zadań” w rankingu albo z mojego testu.
Dostęp z Polski
- OpenRouter: jeden klucz do 9 modeli z pierwszej wersji rankingu (Jev 1.13, Microsoft-Decision-1, Decider v1.1 27B, Mercury Decide, d1, Clef, Clef-Flash, Clef-Omni, GPT-6 Luna Decisions). Wszystkie odpowiedziały mi z Polski 13.10.2026. Modele decyzyjne nie działają przez /chat/completions, tylko przez POST /api/alpha/decisions (pola state i questions).
- GLiDE i Celeris-1 Decision: tylko przez API producenta, z kontem. Nie testowałem.
- Microsoft-Decision-1 w Azure: wymaga płatnej subskrypcji. Microsoft podaje wdrożenie Data Zone, czyli przetwarzanie w obrębie UE jest możliwe.
- GPT-6 Luna Decisions: publiczna beta od 6.10.2026, przetwarzanie w Europie (EOG i Szwajcaria) z dopłatą 10%.
- Jev: dokumentacja TypeSafe opisuje przetwarzanie w USA i umowę powierzenia ze standardowymi klauzulami umownymi. Regionu UE nie ma.
- Otwarte wagi: basal, Clef, Clef-Flash, Clef-Omni, Decider v1.1 27B (Apache-2.0) i d1-3B możesz uruchomić na własnym serwerze, wtedy dane nie wychodzą z firmy. Decider potrzebuje około 49 GB pamięci karty.
Przy danych osobowych klientów i RODO wygodniej jest z modelem uruchomionym u siebie albo z regionem UE niż z API przetwarzającym w USA.
Modele decyzyjne: kto, co i gdzie
| Model | Firma | Wagi i dostęp |
|---|---|---|
| d1-ultra, d1 | Liquid AI | d1-ultra przez API; d1-3B otwarte (licencja LFM1.0) |
| SubQ Snap 1.1 | Subquadratic | API Subquadratic |
| Elephant 9B | Baseten | API Baseten |
| Drex Max, Drex 2.0 | Nace.AI | API Nace.AI, wagi niepubliczne |
| Jev 1.13, 1.14 | TypeSafe | zamknięte; API TypeSafe, OpenRouter |
| basal-omni (mini, max, ultra) | Remek Kinas | Apache-2.0, na bazie Gemmy 4; Hugging Face, Ollama, llama.cpp, MLX |
| Decider v1.1 27B, v1.2, Flash v1.2 | Perplexity | v1.1 na Apache-2.0 (Qwen3.8-27B); API Perplexity, v1.1 też na OpenRouterze |
| GLiDE | Fastino Labs | API Fastino |
| Microsoft-Decision-1 | Microsoft | zamknięte (Qwen3.5-9B); Foundry, OpenRouter |
| Mercury Decide | Inception | zamknięte; API Inception, OpenRouter |
| Celeris-1 Decision | Celeris | zamknięte API |
| Clef, Clef-Flash, Clef-Omni | Cloudflare | Apache-2.0; Workers AI, OpenRouter |
| GPT-6 Luna Decisions | OpenAI | Decisions API, OpenRouter |
| Strands Decider 2B | AWS | Apache-2.0, tylko lokalnie |
Jev 1.13 (15.09.2026) był pierwszym modelem tej kategorii i jego format API (stan plus nazwane pytania typu choice, noul i score, w TypeSafe nazwany System One) przejęła większość konkurencji, więc ten sam kod klienta działa z wieloma modelami. OpenAI ma własny format: pole input zamiast state i pytania jako tablica. GLiDE (30.09) najpierw liczy szybki rozkład, a gdy wynik jest niepewny, rozumuje dłużej. Celeris-1 Decision (8.10) i Mercury Decide (30.09) to modele dyfuzyjne, pierwszy najszybszy w rankingu, drugi najwolniejszy. Rodzina Clef (1 i 9.10) bierze zamrożony model Qwen, przepuszcza przez niego wejście raz i oddaje ukryte stany do małej sieci, która ocenia wszystkie opcje naraz. Strands Decider 2B od AWS (1.10) ma 2 mld parametrów i działa nawet na CPU.
Jak zacząć w 10 minut
- Załóż konto i klucz na OpenRouterze. Jeden klucz wystarczy do 9 modeli decyzyjnych z pierwszej wersji rankingu.
- Wyślij pierwsze zapytanie (Python, sama biblioteka standardowa):
import json, urllib.request
body = {
 "model": "perplexity/pplx-decider-v1.1-27b",
 "state": "Pobrali mi opłatę dwa razy",
 "questions": {
  "dzial": {
   "type": "choice",
   "instructions":
     "Do którego działu?",
   "criteria": {
    "platnosci": "płatności",
    "dostawa": "wysyłka i kurier",
    "konto": "logowanie i hasło"}},
  "pilne": {
   "type": "noul",
   "instructions":
     "Czy trzeba zareagować dziś?",
   "criteria": {
    "true": "tak", "false": "nie"}}}}
req = urllib.request.Request(
 "https://openrouter.ai/api/alpha/decisions",
 json.dumps(body).encode(),
 {"Content-Type": "application/json",
  "Authorization": "Bearer TWOJ_KLUCZ"})
res = urllib.request.urlopen(req)
print(json.load(res)["answers"])- W odpowiedzi dostajesz wybraną opcję, prawdopodobieństwo każdej opcji i pewność (confidence), a przy pytaniu tak/nie prawdopodobieństwo „tak”.
- Zbierz 50-100 oznaczonych przykładów ze swoich danych i ustaw próg pewności, poniżej którego sprawa idzie do człowieka albo LLM-a.
- Jeśli dane nie mogą wyjść z firmy, uruchom otwarty model u siebie: basal, Decider v1.1 27B, Clef-Flash, d1-3B albo najmniejszy Strands Decider 2B (pip install strands-decider).
Najczęstsze pytania
Czym jest model decyzyjny AI?
To model, który zamiast generować tekst wybiera odpowiedź z podanej listy i zwraca prawdopodobieństwo dla każdej opcji. Obsługuje zwykle trzy typy pytań: wybór z listy (choice), tak/nie (noul) i ocenę na skali (score).
Jaki jest najlepszy model decyzyjny?
W Decision Index Artificial Analysis (30.10.2026) prowadzi d1-ultra od Liquid AI (65,2 pkt), przed SubQ Snap 1.1 (65,0) i Elephant 9B (64,7). Elephant jest przy tym najtańszy w czołówce: 8,4 USD za milion zadań. W JevBench wśród otwartych modeli prowadzą baselabs mammoth-1 i KnowLine 31B-Gen1 (po 85,2), a wśród usług API kettei-fat od Sqwish (86,3). Czym różnią się oba rankingi i jak ich nie mylić, wyjaśniam w tekście JevBench i Decision Index.
Co to jest basal?
Polski model decyzyjny Remka Kinasa z otwartymi wagami (Apache-2.0) i własnym silnikiem basal-serve. Rodzina basal-omni (mini, max, ultra) jest zbudowana na Gemmie 4. Wersja ultra prowadziła 17.10 wśród otwartych modeli w JevBench, a 29.10 jest 9. z wynikiem 82,1 pkt.
Co to jest JevBench?
Ranking modeli decyzyjnych w serwisie Benchmark Heaven, prowadzony przez Floriana Standhartingera niezależnie od TypeSafe. Mierzy trafność, kalibrację, szybkość i koszt na 1500 decyzjach. Nazwę wziął od Jeva, który jest w nim punktem odniesienia.
Czy model decyzyjny jest lepszy od Claude Haiku 5.5?
Najlepsze już tak: d1-ultra, SubQ Snap 1.1 i Elephant 9B mają w Decision Index więcej punktów niż Haiku 5.5 na low (60,6), przy kilkukrotnie niższym koszcie i czasie. Haiku na wyższych poziomach rozumowania (68,4 na max) wciąż wygrywa, ale kosztuje ponad 2000 USD za milion zadań. W wiedzy o świecie Haiku ma przewagę: 52% trafności wobec najwyżej 41%.
Ile kosztuje model decyzyjny?
Za token od 0,02 do 0,24 USD za milion tokenów wejścia, wyjście jest darmowe. Milion zadań kosztuje według Artificial Analysis od 8,2 USD (Decider Flash v1.2) do 199 USD (Clef w Workers AI).
Czy modele decyzyjne działają po polsku?
Tak. W moim teście z 13.10 trafiały dział w 41-44 z 47 polskich zgłoszeń, a wybór narzędzia w 6-10 z 10 przypadków. Kalibracja bywa przesunięta, więc progi trzeba ustawić na własnych przykładach.
Czym różni się model decyzyjny od function calling?
Function calling to sposób, w jaki LLM generuje wywołanie funkcji z argumentami. Model decyzyjny zrobi część polegającą na wyborze narzędzia albo decyzji „wywołać czy dopytać”, ale argumentów tekstowych nie wygeneruje. W agentach często używa się obu.
Źródła
- Artificial Analysis: Decision Index, ranking na żywo (odczyt 30.10.2026)
- Artificial Analysis: artykuł o Decision Index v1.0 (13.10.2026)
- Artificial Analysis: metodologia Decision Index (odczyt 13.10.2026)
- Benchmark Heaven: JevBench, otwarte modele (stan 29.10.2026, metoda v1.7)
- Benchmark Heaven: JevBench, usługi API (stan 28.10.2026)
- OpenRouter: Decisions API (odczyt 13.10.2026)
- TypeSafe: modele i ceny (odczyt 13.10.2026)
- Fastino: cennik (odczyt 13.10.2026)
- Microsoft Learn: Microsoft-Decision-1 (odczyt 13.10.2026)
- Perplexity: Decisions API (odczyt 13.10.2026)
- Inception: Mercury Decide (odczyt 13.10.2026)
- Celeris: Celeris-1 Decision (odczyt 13.10.2026)
- Liquid AI: otwarte d1 (odczyt 13.10.2026)
- Cloudflare: Introducing Clef (1.10.2026)
- Cloudflare: cennik Workers AI (odczyt 13.10.2026)
- OpenAI: Decisions API (odczyt 13.10.2026)
- Strands Agents: Strands Decider 2B (1.10.2026)
- Hugging Face: kolekcja basal-omni-1.0 (odczyt 19.10.2026)
- Remek Kinas na X (17.10.2026)
- Moje testy: 5.10.2026 (30 zgłoszeń, RTX 4090, Windows 11, Ollama), 13.10.2026 (50 zgłoszeń i 10 decyzji o narzędziach, 11 modeli przez OpenRouter z Polski, koszt 0,022 USD), 19.10.2026 (basal-omni-1.0-mini Q8_0 przez Ollamę 0.40.5 i basal-serve 2.2)
Sprawdzone: 30.10.2026
Czytaj także

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
 Artykuły · Ranking generatorów muzyki AI 2026: Elo i test po polskuRanking generatorów muzyki AI z października 2026: wyniki Elo Artificial Analysis (wokal i instrumental) połączone z moim testem tej samej polskiej...
 Artykuły · Whisper: transkrypcja po polsku, modele, instalacja i test (2026)Wszystko o Whisperze w jednym miejscu: modele i wymagania, instalacja na Windows, programy z okienkiem, API OpenAI i mój pomiar na 22-minutowym...
 Artykuły · Mistral AI: Vibe (Le Chat), modele, ceny i test po polsku (2026)Przewodnik po Mistral AI: nowy Mistral Large 4 („Le Chonk”, 1,05 bln parametrów) i mój test po polsku, czat Vibe (dawniej Le Chat), modele do...
- przelomowy.plModele AI rozpoznają ukryte nadużycia naukowe w 91% przypadków, lecz często i tak pomagają
- generatornia.plKartka świąteczna AI do druku: jak wygenerować polski napis i złożyć plik
- przewagi.plGoogle Ads na Black Friday 2026: agencja od 1 500 zł netto, ChatGPT Ads od 65 zł dziennie i plan na 4 tygodnie
- dygot.plChatGPT zmienia ekran. Nowa aplikacja spycha czat na drugi plan