Whisper: transkrypcja po polsku, modele, instalacja i test (2026)
Wszystko o Whisperze w jednym miejscu: modele i wymagania, instalacja na Windows, programy z okienkiem, API OpenAI i mój pomiar na 22-minutowym nagraniu lektora, w którym jedno ustawienie zmniejszyło liczbę błędów o połowę.
👁 119 przeczytań
- Model large-v3 z ustawieniem condition_on_previous_text=False przepisał 22 minuty nagrania z błędem 2,4% słów w 3 minuty 14 sekund na karcie RTX 4090.
- Najlepszy stosunek jakości do czasu zapewnia large-v3-turbo, który przetwarza 22 minuty w 43 sekundy przy 2,6% błędnych słów.
- Lokalny Whisper działa na licencji MIT i jest bezpłatny, natomiast API OpenAI kosztuje od 0,003 USD za minutę dla gpt-4o-mini-transcribe do 0,006 USD dla whisper-1.
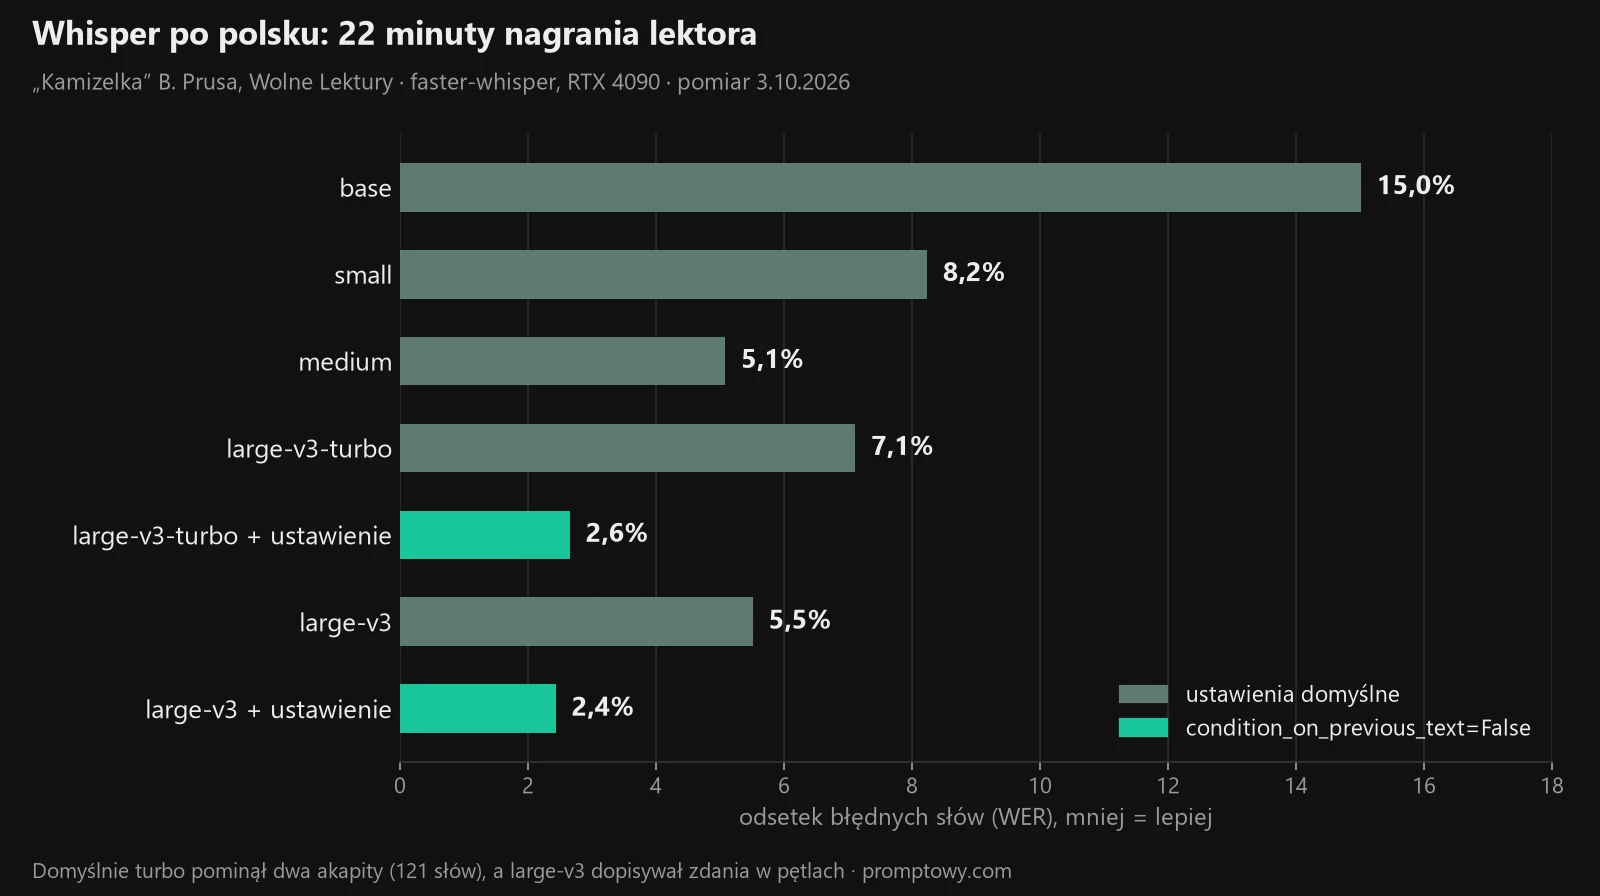
Whisper to otwarty model OpenAI do zamiany mowy na tekst, który uruchomisz za darmo na własnym komputerze, bez limitów i bez wysyłania nagrania w sieć. Po polsku radzi sobie dobrze: w moim pomiarze na karcie RTX 4090 model large-v3 przepisał 22 minuty opowiadania czytanego przez lektora z 2,4% błędnych słów w 3 minuty 14 sekund, ale tylko po zmianie jednego ustawienia. Z ustawieniami domyślnymi ten sam model wpadał w pętle powtórzeń, a szybszy large-v3-turbo pominął dwa akapity.
Stan na 3 października 2026
- Najnowsze modele: large-v3 (listopad 2023) i large-v3-turbo (październik 2024). Modelu „Whisper v4” OpenAI nie wydało, mimo że ta nazwa krąży po porównywarkach.
- Licencja: MIT dla kodu i wag modelu, także do użytku komercyjnego.
- API OpenAI: whisper-1 oznaczony jako starszy (0,006 USD za minutę), do nowych projektów OpenAI poleca gpt-transcribe (0,0045 USD za minutę według zestawień cen).
- Najszybsza droga lokalnie: faster-whisper (CTranslate2), do 4 razy szybszy od oryginału przy tej samej dokładności; na Macach whisper.cpp.
- Mój test: 5 modeli, 4 nagrania, RTX 4090. Najlepiej: large-v3 z 2,4% błędnych słów po zmianie jednego ustawienia.
Co to jest Whisper
Whisper to model rozpoznawania mowy, który OpenAI udostępniło we wrześniu 2022 roku razem z kodem i wagami. Pierwsze wersje uczono na 680 tysiącach godzin nagrań z internetu, a large-v3 na ponad 5 milionach godzin (w większości z automatycznie przygotowanymi napisami), dlatego radzi sobie z akcentami, szumem i słownictwem specjalistycznym lepiej niż starsze systemy. Obsługuje 99 języków, w tym polski, i potrafi:
- przepisać nagranie w języku oryginału (transkrypcja),
- przetłumaczyć mowę od razu na angielski (wszystkie modele poza turbo),
- rozpoznać język nagrania,
- podać czas każdego zdania, a w niektórych narzędziach każdego słowa, co wystarcza do napisów SRT.
Whisper nie rozpoznaje mówców. Przy rozmowie kilku osób dostajesz ciągły tekst bez podziału. Do tego potrzebne są nakładki, np. WhisperX, albo usługi z rozpoznawaniem mówców. Krótsze wprowadzenie do Whispera jest w tekście Whisper: transkrypcja mowy na tekst po polsku.
Modele i wymagania
| Model | Parametry | Pamięć karty (OpenAI) | Szybkość względna | Kiedy użyć |
|---|---|---|---|---|
| tiny | 39 mln | ok. 1 GB | ok. 10x | testy, słabe komputery |
| base | 74 mln | ok. 1 GB | ok. 7x | szybki podgląd treści |
| small | 244 mln | ok. 2 GB | ok. 4x | laptop bez mocnej karty |
| medium | 769 mln | ok. 5 GB | ok. 2x | dobry kompromis |
| large-v3 | 1550 mln | ok. 10 GB | 1x | najwyższa dokładność |
| large-v3-turbo | 809 mln | ok. 6 GB | ok. 8x | prawie jakość large, dużo szybciej |
Wymagania pamięci dotyczą oryginalnej implementacji OpenAI. faster-whisper w trybie float16 albo int8 potrzebuje wyraźnie mniej, więc large-v3 zmieści się na karcie z 6-8 GB pamięci. Bez karty graficznej Whisper też działa, tylko wolniej.
Jak zacząć: Whisper na Windows krok po kroku
Najprostsza droga bez programowania to gotowy program z okienkiem:
- Buzz - darmowy program na Windows, Maca i Linuksa: wybierasz plik, model i język, dostajesz tekst albo napisy.
- Subtitle Edit - darmowy edytor napisów na Windows z wbudowanym Whisperem, wygodny, gdy od razu chcesz poprawiać napisy do filmu.
- MacWhisper - aplikacja na Maca, w podstawowej wersji darmowa.
Ja używam faster-whisper w Pythonie, bo przetwarzam wiele plików naraz. Tak to uruchamiam:
- Zainstaluj Pythona 3.12 z python.org (zaznacz „Add to PATH”).
- W wierszu poleceń wpisz:
pip install faster-whisper. - Dla karty NVIDIA doinstaluj biblioteki CUDA:
pip install nvidia-cublas-cu12 nvidia-cudnn-cu12. U mnie brakujący plik cublas64_12.dll leżał w katalogutorch/libzainstalowanego PyTorcha, więc wystarczyło dodać ten katalog do ścieżki przed importem. - Zapisz skrypt
transkrypcja.py(niżej) i uruchom:python transkrypcja.py nagranie.mp3. - Przy pierwszym uruchomieniu model pobierze się sam (large-v3 to ok. 3 GB), potem działa offline.
Skrypt z ustawieniami, które dały najlepszy wynik w moim teście (działa z plikami MP3, WAV, M4A i wideo, bo dekoduje je wbudowany PyAV):
import sys
from faster_whisper import WhisperModel

model = WhisperModel("large-v3", device="cuda", compute_type="float16")
# bez karty graficznej: WhisperModel("large-v3-turbo", device="cpu", compute_type="int8")
segmenty, info = model.transcribe(sys.argv[1], language="pl", beam_size=5, vad_filter=True,
                                  condition_on_previous_text=False)
with open(sys.argv[1] + ".txt", "w", encoding="utf-8") as f:
    for s in segmenty:
        f.write(s.text.strip() + "\n")
print("Gotowe:", round(info.duration), "s nagrania")
Cztery ustawienia, które robią różnicę po polsku:
language="pl"- bez tego Whisper zgaduje język z pierwszych 30 sekund i przy angielskim wstępie potrafi przetłumaczyć całość na angielski.vad_filter=True- wycina ciszę przed transkrypcją. Zmniejsza ryzyko zmyślonych zdań w pauzach.condition_on_previous_text=False- najważniejsze przy nagraniach dłuższych niż kilka minut. W moim teście zmniejszyło liczbę błędów large-v3 z 4,9-5,5% do 2,4% i usunęło pętle powtórzeń.initial_prompt="Nazwiska: Kowalczyk, Brzęczyszczykiewicz. Firma: Promptowy."- podpowiedź z nazwami własnymi, które model ma znać.
Mój test: Whisper po polsku na RTX 4090
3 października 2026 przepuściłem przez pięć modeli Whispera (faster-whisper 1.2.1, float16 na karcie RTX 4090, beam 5, VAD włączony, język polski) cztery nagrania:
- Kamizelka Bolesława Prusa z Wolnych Lektur, czyta Jan Peszek: 22 minuty 22 sekundy, ok. 2900 słów prozy z XIX-wiecznym słownictwem. Tekst jest w domenie publicznej, więc mam dokładny wzorzec.
- Głos syntetyczny męski (Microsoft Marek): 60 sekund, 146 słów z idiomami, kwotami, procentami, datą i godziną.
- Głos syntetyczny żeński (Microsoft Zofia): ten sam tekst, 65 sekund.
- Głos męski z szumem: to samo nagranie z dodanym szumem różowym, mowa tylko o ok. 4 dB głośniejsza od szumu.
Miarą jest WER, czyli odsetek błędnych słów (zamienionych, pominiętych i dopisanych) po ujednoliceniu wielkości liter, interpunkcji i zapisu liczb. Dla nagrań syntetycznych wzorcem jest tekst w formie czytanej („2026 roku”, a nie „2026 r.”).
| Model | Kamizelka (lektor, 22 min) | Czas dla 22 min | Głos męski | Głos żeński | Głos z szumem |
|---|---|---|---|---|---|
| base | 15,0% | 48 s | 16,4% | 15,8% | 32,9% |
| small | 8,2% | 87 s | 4,8% | 5,5% | 12,3% |
| medium | 5,1% | 160 s | 0,7% | 4,1% | 7,5% |
| large-v3-turbo | 7,1% (domyślnie), 2,6% po zmianie ustawienia | 54 s, po zmianie 43 s | 2,1% | 2,7%* | 6,2% |
| large-v3 | 4,9-5,5% (domyślnie), 2,4% po zmianie ustawienia | 228 s, po zmianie 194 s | 0,0% | 2,7% | 2,1% |
* W tym wyniku są dwa zmyślone słowa doklejone na końcu nagrania („Zjedenska Zjedenski”). „Po zmianie ustawienia” oznacza condition_on_previous_text=False, opisane niżej. Czasy to lepszy z dwóch pomiarów: karta była współdzielona z innymi zadaniami, więc pojedyncze przebiegi wahały się nawet kilkukrotnie (turbo raz 54 s, raz 252 s). Czas ładowania modelu z dysku nie jest wliczony.
Co z tego wynika
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
- Jedno ustawienie zmienia wszystko. Domyślnie Whisper podaje sobie poprzedni fragment jako kontekst do następnego. Przy długim nagraniu raz popełniony błąd się nakręca: large-v3 kilka razy powtórzył całe zdania („niech pan sam powie, co to jest wart, a ja się zgodzę”) i dopisał „nie nie nie nie nie nie”, a turbo po cichu pominął dwa akapity (121 słów). Z
condition_on_previous_text=Falseoba modele przepisały całość bez pętli i bez dziur, a liczba błędów spadła o połowę i więcej. - Wyłączenie VAD nie pomaga, wręcz szkodzi. Bez wycinania ciszy large-v3 dopisał w pętlach 112 słów (7,7% błędów), a turbo dalej pomijał te same akapity.
- Najlepszy stosunek jakości do czasu ma large-v3-turbo: 22 minuty w 43 sekundy, czyli 31 razy szybciej niż w czasie rzeczywistym, przy 2,6% błędów.
- Szum odsiewa małe modele. Gdy mowa była tylko o 4 dB głośniejsza od szumu, large-v3 pomylił 3 słowa na 146, medium 11, small 18, a base 48.
- Base i tiny nie nadają się do polskiego. 15% błędnych słów to poprawianie co siódmego słowa.
- Część „błędów” to stylizacja. Prus zapisuje mowę postaci gwarą („jake kamyzelkie”, „doktór”), a Whisper zapisuje ją poprawną polszczyzną. To podnosi wynik wszystkich modeli o podobną wartość.
Dla porównania: w osobnym teście usługi ElevenLabs Scribe na wywiadzie pełnym nazwisk Scribe nie zrobił żadnego błędu, a Whisper large-v3 pomylił dwa nazwiska. Chmura wygrywa przy nazwach własnych i rozpoznawaniu mówców, Whisper prywatnością i brakiem limitów.
Whisper przez API OpenAI
Jeśli nie chcesz niczego instalować, Whispera i jego następców użyjesz przez API OpenAI. Według dokumentacji OpenAI do nowych projektów poleca gpt-transcribe (pliki) i gpt-live-transcribe (na żywo), a whisper-1 i modele gpt-4o-transcribe oznacza jako starsze. Ceny za minutę nagrania według zestawień z października 2026:
| Model | Cena za minutę | Uwagi |
|---|---|---|
| gpt-transcribe | 0,0045 USD | polecany do plików, podpowiedzi słów i języka |
| gpt-4o-mini-transcribe | 0,003 USD | najtańszy |
| gpt-4o-transcribe-diarize | 0,006 USD | rozpoznaje mówców |
| whisper-1 | 0,006 USD | jedyny ze znacznikami czasu słów i eksportem SRT/VTT |
Godzina nagrania przez gpt-transcribe to ok. 0,27 USD. Lokalnie na własnej karcie płacisz tylko za prąd. Ile kosztuje praca na własnym sprzęcie w porównaniu z API, liczyłem w tekście Lokalny model czy API.
Whisper na tle innych narzędzi
| Narzędzie | Polski | Mówcy | Prywatność | Cena |
|---|---|---|---|---|
| Whisper lokalnie | dobry, lepszy w dużych modelach | nie (WhisperX tak) | nagranie zostaje u Ciebie | 0 zł |
| OpenAI gpt-transcribe | dobry | w wariancie diarize | chmura OpenAI | 0,0045 USD za minutę |
| ElevenLabs Scribe | bardzo dobry na nazwach i liczbach | tak, do 32 | chmura | darmowy plan, API od 0,22 USD za godzinę |
| TurboScribe | jak Whisper (na nim oparty) | tak | chmura | 3 pliki dziennie za darmo |
| Otter.ai | nie obsługuje polskiego | tak | chmura | - |
Darmowe sposoby z limitami minut zebrałem w tekście Transkrypcja po polsku za darmo, a cały proces od nagrania do poprawionego tekstu w poradniku Transkrypcja nagrania. Jeśli z transkrypcji robisz napisy do filmów, zajrzyj do tekstu AI do napisów.
Dla kogo jest Whisper
- Tak: dziennikarze, prawnicy, lekarze i badacze z nagraniami, które nie mogą opuścić komputera; twórcy podcastów i filmów z dziesiątkami godzin materiału; programiści, którzy budują transkrypcję we własnych narzędziach.
- Raczej nie: spotkania wielu osób, gdzie liczy się podział na mówców; osoby bez cierpliwości do instalacji (wtedy TurboScribe albo Scribe); nagrania pełne nazwisk, które muszą być bezbłędne bez poprawek.
Najczęstsze pytania
Czy Whisper jest darmowy?
Tak. Kod i wagi modelu są na licencji MIT, więc uruchamiasz go lokalnie bez opłat i limitów, także komercyjnie. Płatne jest tylko API OpenAI, rozliczane za minutę nagrania.
Jak dobrze Whisper rozumie polski?
Dobrze przy wyraźnej mowie jednej osoby. W moim teście na 22-minutowym nagraniu lektora large-v3 miał 2,4% błędnych słów (po wyłączeniu condition_on_previous_text), a najmniejszy testowany model base 15%. Przy silnym szumie liczba błędów rośnie kilkukrotnie.
Który model Whispera wybrać do polskiego?
Z kartą graficzną 8 GB lub więcej: large-v3 albo large-v3-turbo. Na laptopie bez karty: large-v3-turbo w trybie int8 albo small. Modeli tiny i base do polskiego nie polecam, mylą kilkanaście procent słów.
Czy jest Whisper v4?
Nie. Na 3 października 2026 najnowsze otwarte modele to large-v3 i large-v3-turbo. Strony opisujące „Whisper v4” mówią zwykle o large-v3 albo o nowszych, zamkniętych modelach OpenAI dostępnych tylko przez API.
Czy Whisper działa bez internetu?
Tak. Po pierwszym pobraniu modelu działa całkowicie offline, a nagranie nie opuszcza komputera.
Ile trwa transkrypcja godziny nagrania?
Na RTX 4090 z modelem large-v3 wyszło mi ok. 9 minut na godzinę nagrania, a z large-v3-turbo niecałe 2 minuty. Na procesorze bez karty graficznej licz się z czasem zbliżonym do długości nagrania albo dłuższym.
Dlaczego Whisper dopisuje zdania, których nie było?
To tzw. halucynacje, najczęściej w ciszy na końcu nagrania albo przy szumie. W moim teście model turbo dokleił na końcu czystego nagrania słowa „Zjedenska Zjedenski”. Pomaga włączenie VAD (vad_filter=True), ustawienie condition_on_previous_text=False i przycięcie ciszy na końcu pliku.
Czy Whisper rozpoznaje mówców?
Nie. Do podziału na mówców potrzebujesz nakładki WhisperX (z modelem pyannote) albo usługi takiej jak ElevenLabs Scribe czy gpt-4o-transcribe-diarize w API OpenAI.
Google · Twoje źródłaPromptowy wyżej w Twoim Google - jednym kliknięciemDodaj do preferowanych źródeł →Źródła i data sprawdzenia
Dane i pomiar z 3 października 2026. Nagranie testowe: Bolesław Prus, „Kamizelka”, czyta Jan Peszek, Wolne Lektury (utwór w domenie publicznej, nagranie na licencji Wolnych Lektur).
- OpenAI Whisper - repozytorium, modele i licencja
- faster-whisper - repozytorium
- OpenAI - przewodnik po transkrypcji w API
- Zestawienie cen transkrypcji OpenAI (październik 2026)
- Wolne Lektury - Kamizelka
- Otter.ai - obsługiwane języki
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Link do ElevenLabs jest partnerski: jeśli kupisz przez niego, serwis dostaje prowizję, a Ty płacisz tyle samo. Nie wpływa to na treść, także tam, gdzie piszę krytycznie.
Podobne tematy na Promptowym