

NVIDIA DGX Spark dostępny z 64 GB pamięci - osobisty superkomputer AI rośnie w możliwościach
NVIDIA wprowadza w tym miesiącu konfigurację DGX Spark z 64 GB pamięci unified memory, dostępną u sześciu producentów, która obsługuje modele do 100 miliardów parametrów i pozwala dwóm jednostkom klastrować się bez dodatkowej konfiguracji.
Spis treści 4
Ten news ukazał się 10 min po komunikacie źródła.
👁 177 przeczytań
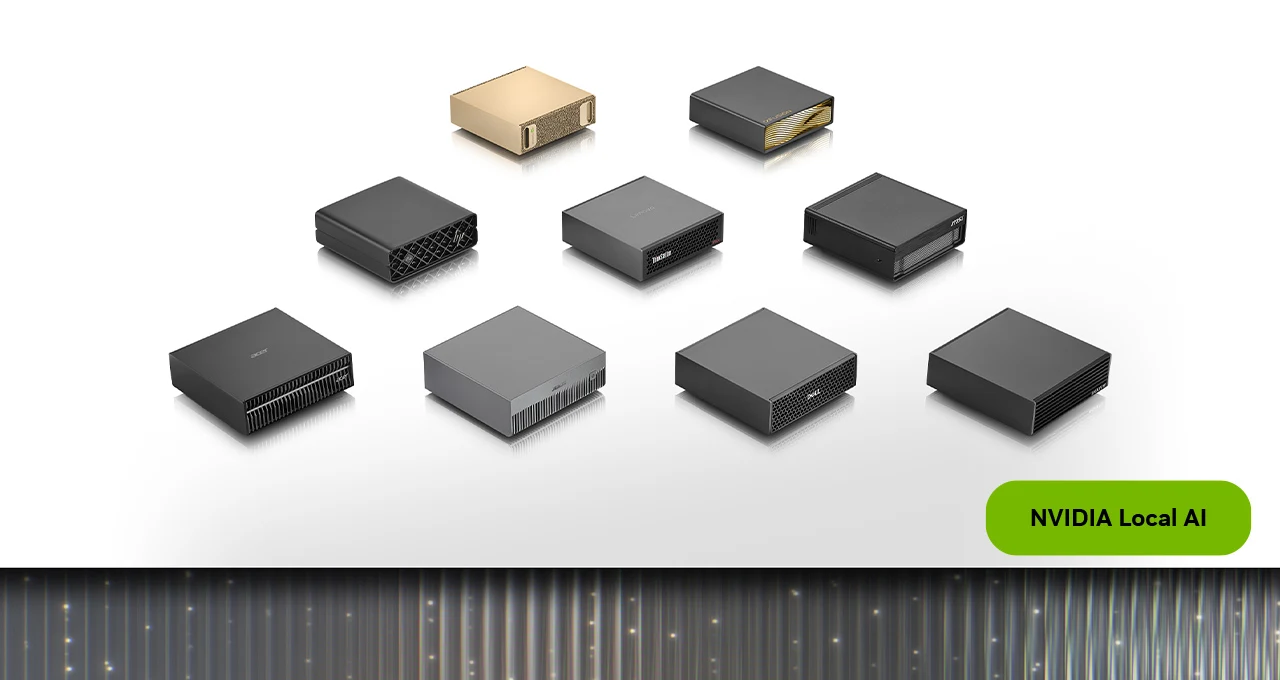
NVIDIA ogłosiła w tym miesiącu nową konfigurację DGX Spark z 64 GB pamięci unified memory, dostępną wyłącznie przez partnerów producenckich: Acer, ASUS, Dell, Gigabyte, HP i MSI. To bezpośrednia odpowiedź na rosnące zapotrzebowanie na lokalną infrastrukturę AI, która nie wymaga stałego połączenia z chmurą i pozwala pracować z wrażliwymi danymi bez opuszczania własnej sieci.
Czym właściwie jest DGX Spark i dlaczego wersja 64 GB ma znaczenie
DGX Spark to kompaktowy komputer osobisty oparty na superchipie GB10 Grace Blackwell - tym samym, który napędza droższą wersję 128 GB. Nowa konfiguracja zachowuje pełny ekosystem: DGX OS, biblioteki CUDA-X AI, NVIDIA Agent Toolkit, modele Nemotron, a także obsługę popularnych runtimów takich jak Ollama, vLLM i PyTorch z CUDA. Innymi słowy, różnica między obiema wersjami sprowadza się wyłącznie do ilości pamięci - nie do możliwości oprogramowania ani jakości układu.
To ważne rozróżnienie. 64 GB unified memory wystarczy do obsługi modeli do 100 miliardów parametrów, co obejmuje zdecydowaną większość otwartych modeli dostępnych dziś na rynku - od Llamy po Qwen, Mistral czy rodzinę modeli Nemotron. Dla programisty, badacza czy entuzjasty AI, który nie potrzebuje jednocześnie trenować wielkich modeli fundamentalnych, a chce mieć lokalne, prywatne i szybkie środowisko do agentów, fine-tuningu i data science, wersja 64 GB staje się realnym wyborem przy niższej cenie niż model 128 GB.
Klasteryzacja bez bólu głowy - Sync Cluster Assistant w praktyce
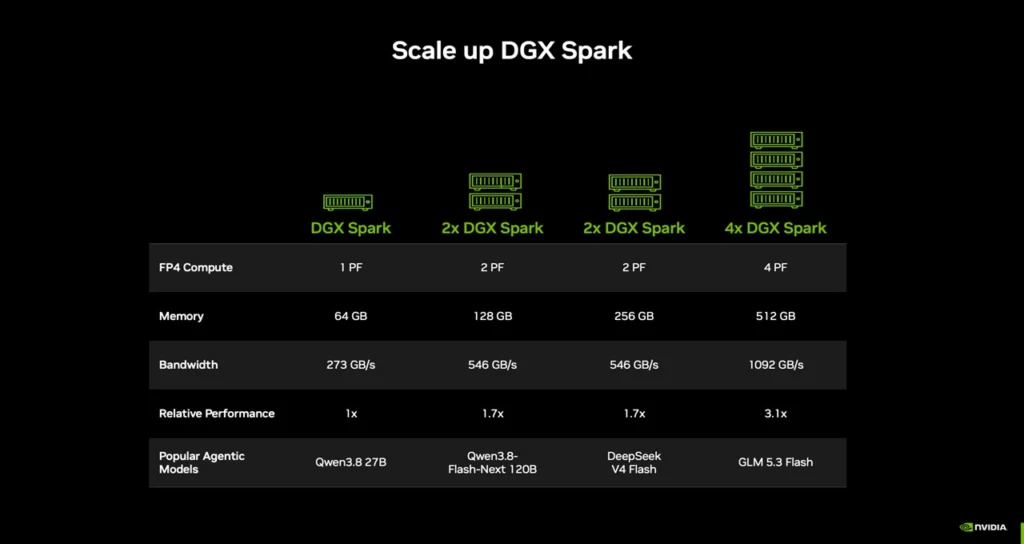
Najbardziej interesującym elementem nowej konfiguracji jest jednak nie sama pamięć, lecz to, co można zrobić z dwiema jednostkami. Każdy DGX Spark ma wbudowaną kartę sieciową NVIDIA ConnectX-7 NIC. Połączenie dwóch urządzeń kablem QSFP tworzy klaster, który sumuje pamięć do 128 GB, podwaja przepustowość pamięci i rozszerza obsługę modeli do 200 miliardów parametrów.
W testach NVIDIA z modelem Qwen3.8 27B dwa sklastrowane systemy 64 GB osiągnęły do 1,7x wyższą wydajność niż pojedyncza jednostka - przy jednoczesnym zachowaniu możliwości dalszego skalowania. Co kluczowe: NVIDIA Sync Cluster Assistant automatycznie wykrywa podłączone urządzenia, waliduje konfigurację i ustawia sieć ConnectX-7. Każdy węzeł korzysta z tego samego stosu oprogramowania NVIDIA, więc nie trzeba nic rekonfigurować przy przejściu z jednej jednostki na dwie. Lokalny model Nvidii do zadań agentowych opisałem w tekście Nemotron Bolt E4B: wymagania i możliwości.
To filozofia, którą NVIDIA konsekwentnie stosuje w segmencie enterprise od lat - teraz schodzi ona na poziom biurka. Deweloper może zacząć z jednym urządzeniem, a gdy projekt urośnie, dołożyć drugie bez przebudowy środowiska. Dla małych zespołów i niezależnych badaczy to model zakupu i skalowania znacznie bardziej przyjazny niż jednorazowa inwestycja w droższy sprzęt.
Ekosystem, który rośnie razem z platformą
DGX Spark od premiery był zaprojektowany z myślą o agentach AI, nie tylko o samym wnioskowaniu. Platforma obsługuje NVIDIA Agent Toolkit i pełen stos CUDA-X, co pozwala budować wieloagentowe pipelines bez wychodzenia do chmury. Dla firm, które przetwarzają dane medyczne, prawne czy finansowe, lokalność jest nie tyle wygodą, ile wymogiem compliance.
Pod koniec miesiąca pojawi się NVIDIA Sync Model Launcher - narzędzie, które ma sprawić, że uruchomienie lokalnego modelu będzie tak proste jak kilka kliknięć. Launcher pobierze i uruchomi np. Qwen3.8 27B na pojedynczym systemie lub klastrze, automatycznie rozdzielając obciążenie między podłączone urządzenia i udostępniając model z laptopa użytkownika. Co więcej, launcher skonfiguruje też OpenCode - środowisko do kodowania w przeglądarce - tak żeby od razu korzystało z lokalnie uruchomionego modelu. Deweloper od włączenia urządzenia do pisania kodu z pomocą lokalnego LLM ma pokonać drogę mierzoną w minutach, nie godzinach.
Blender jako jedna z pierwszych dużych aplikacji kreatywnych zapowiada dedykowany instalator dla DGX Spark, który ma być dostępny do pobrania wkrótce. To sygnał, że platforma zaczyna przyciągać ekosystem partnerów spoza klasycznego środowiska ML - w kierunku twórców 3D, grafików i designerów, dla których lokalne generowanie i edycja zasobów przy pomocy AI staje się praktycznym narzędziem pracy.
Czytasz Promptowego częściej? Dodaj go do preferowanych źródeł w Google, a nowe teksty będą wyżej w Twoich wynikach.
Co to zmienia na rynku lokalnej infrastruktury AI
Kontekst rynkowy jest tu istotny. Przez ostatnie lata deweloperzy AI mieli w zasadzie dwie opcje: chmura (droga w eksploatacji, zależna od dostawcy, problematyczna dla danych wrażliwych) albo samodzielna budowa klastra GPU (droga w zakupie, skomplikowana w utrzymaniu). Segment tak zwanych personal AI supercomputers - kompaktowych, zintegrowanych maszyn z GPU i dużą pamięcią unified - wypełnił lukę między tymi skrajnościami.
Apple Silicon z pamięcią unified do 192 GB udowodnił, że architektura bez osobnej pamięci GPU może obsługiwać sensowne modele lokalnie. NVIDIA idzie tym samym tropem, ale z pełnym stosem CUDA, który jest de facto standardem branżowym dla trenowania i wnioskowania. Dodanie tańszego wariantu 64 GB i mechanizmu prostej klasteryzacji to wyraźny sygnał, że NVIDIA chce uczynić z DGX Spark nie niszowy gadżet dla entuzjastów, lecz realną platformę roboczą dla szerokiej grupy profesjonalistów.
Dla polskich deweloperów, startupów AI i laboratoriów badawczych, które nie mają budżetów na pełne klastry GPU w centrum danych, DGX Spark 64 GB - szczególnie w konfiguracji dwóch sklastrowanych jednostek - otwiera możliwości, które jeszcze rok temu wymagały albo znacznie większych wydatków, albo kompromisu w postaci uzależnienia od API zewnętrznych dostawców.
Rynek lokalnej infrastruktury AI dopiero się kształtuje, ale tempo, w jakim NVIDIA rozbudowuje ekosystem DGX Spark - od oprogramowania, przez partnerów producenckich, po narzędzia dla twórców - sugeruje, że firma traktuje ten segment bardzo poważnie.
Cały temat w jednym miejscu: Nvidia RTX Spark: laptopy, ceny w Polsce i lokalne AI. Porównanie z DGX Spark i MacBookiem Pro: co wybrać do lokalnego AI

Autor
Twórca i autor Promptowego, polskiego serwisu o sztucznej inteligencji. Codziennie śledzi premiery modeli, narzędzia i regulacje AI, i tłumaczy je prostym, konkretnym językiem.
Czytaj dalej
 Newsy · Chipy Nvidia H200 dotarły do ByteDance i Tencenta - przez HongkongByteDance i Tencent otrzymały po około 10 000 procesorów Nvidia H200 - pierwsze realne dostawy po ośmiu miesiącach licencji eksportowych, które...
 Newsy · SK Hynix wyda 38 mld dolarów na dwie nowe fabryki pamięciSK Hynix zainwestuje 54 biliony wonów (38,1 mld dolarów) w budowę dwóch fabryk pamięci DRAM i NAND w Korei Południowej, by nadążyć za popytem...
 Newsy · NVIDIA i Hugging Face o stanie symulacji dla fizycznej AINVIDIA opublikowała na Hugging Face szczegółowy przegląd obecnego stanu symulacji dla fizycznej AI, tłumacząc, dlaczego brak danych to główna...
- dygot.plKanye West z nominacją do Grammy 2027. Akademia nie przestraszyła się zarzutów o AI
- jutropis.plKE konsultuje formularz oceny wpływu AI na prawa podstawowe
- przelomowy.plTransformer w AI: jak mechanizm uwagi z 2017 roku zastąpił sieci rekurencyjne
- przewagi.plChatGPT Ads czy Google Ads w 2026: jak podzielić budżet i ile dać na test