Z-Image Turbo lokalnie: test na 8 promptach i porównanie z Qwen-Image
16 obrazów z tych samych poleceń: Z-Image Turbo robi obraz w 4,2 s i wolno go używać komercyjnie. Oba modele pomyliły polskie litery.
👁 114 przeczytań
- Z-Image Turbo generuje obraz 1344x768 w 4,2 sekundy na RTX 4090, czyli o ponad jedną trzecią szybciej niż Qwen-Image 2.1, który potrzebuje 6,5 sekundy.
- Z-Image Turbo ma licencję Apache 2.0 zezwalającą na użytek komercyjny, podczas gdy Qwen-Image 2.1 działa na licencji Qwen Research zakazującej sprzedaży i reklamy.
- Żaden z testowanych modeli nie napisał poprawnie słowa z czterema polskimi znakami - Z-Image zwrócił "ŽÓŁČ", a Qwen-Image "ŹÓLĆ" zamiast "ŻÓŁĆ".
Z-Image Turbo to darmowy model do generowania obrazów od Alibaby, który działa na własnej karcie graficznej i można go używać komercyjnie. 26 września 2026 roku dałem mu na karcie RTX 4090 osiem tych samych poleceń co Qwen-Image 2.1, drugiemu popularnemu modelowi lokalnemu. Z-Image robił obraz 1344×768 w 4,2 sekundy, Qwen-Image w 6,5 sekundy. Poniżej wszystkie 16 obrazów bez poprawek, z tym, co się udało, i z tym, co nie wyszło.
W skrócie
Z-Image Turbo jest szybszy i ma licencję Apache 2.0, więc obrazy wolno sprzedawać i używać w reklamie. Qwen-Image 2.1 ma licencję badawczą, która zakazuje użytku komercyjnego. Jakość zdjęć jest podobna. Z-Image daje cieplejsze, bardziej „reklamowe” światło, a Qwen dokładniej trzyma się szczegółów polecenia. Oba modele pomyliły polskie litery w szyldzie. Z-Image dopisał też nazwę magazynu do ilustracji, w której napisów miało nie być. Potrzebujesz karty z 12-16 GB pamięci albo cierpliwości przy mniejszej.
Jak wyglądał test
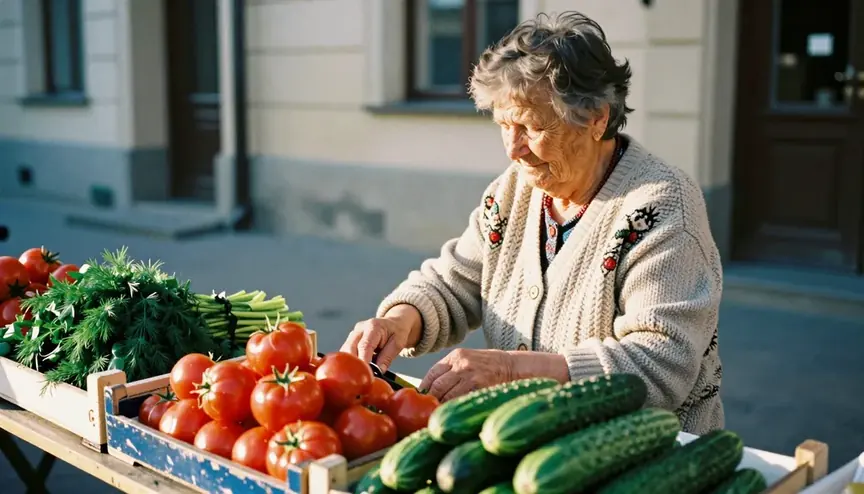
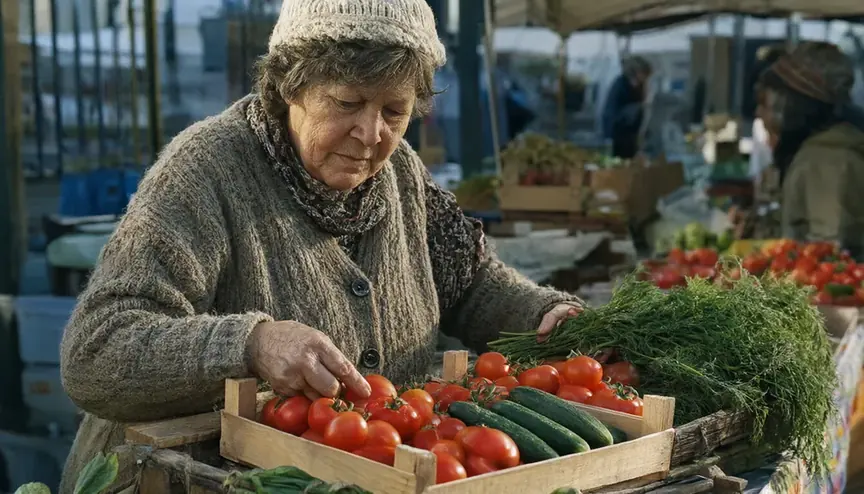
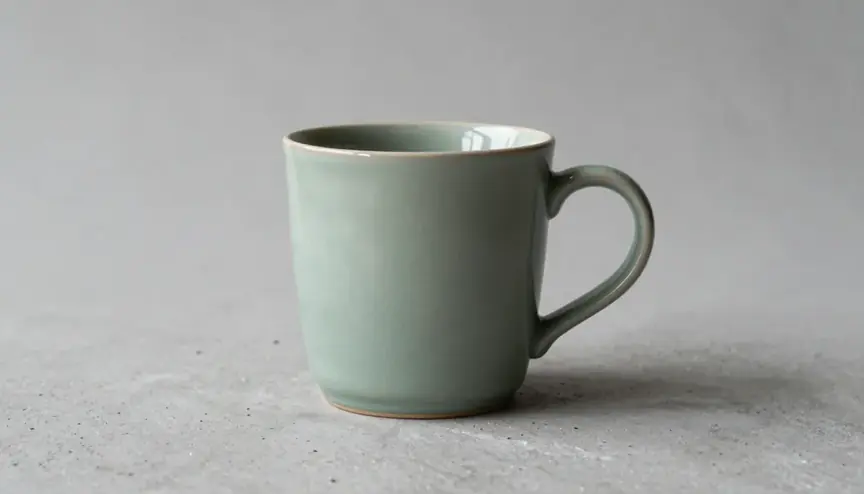
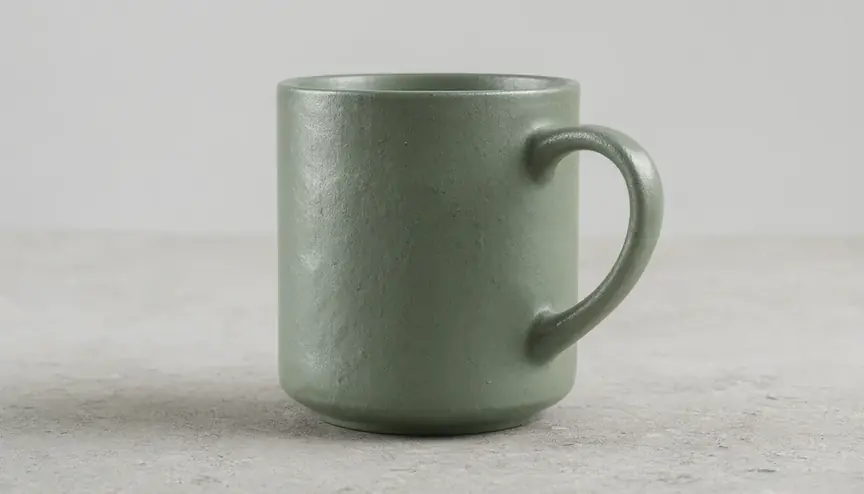
Oba modele uruchomiłem w ComfyUI 0.37 na karcie RTX 4090 z 24 GB pamięci, pod Windowsem 11. Dostały te same osiem poleceń po angielsku, tę samą rozdzielczość 1344×768 i to samo ziarno losowania. Z-Image pracował w 9 krokach z ustawieniami z oficjalnego szablonu ComfyUI, a Qwen-Image 2.1 w 25 krokach. Polecenia były dobrane tak, żeby sprawdzić różne rzeczy: reportaż, zdjęcie produktu, polski napis, ilustrację, pejzaż, wnętrze z PRL-u, portret z dłońmi i zdjęcie jedzenia. Obrazy pokazuję bez retuszu i bez losowania kolejnych wersji.
| Z-Image Turbo | Qwen-Image 2.1 | |
|---|---|---|
| Czas obrazu 1344×768 (model już wczytany) | 4,0-4,5 s | 6,5 s |
| Pierwszy obraz po starcie (wczytanie z dysku) | 434 s | 391 s |
| Pamięć karty zajęta przez ComfyUI | do 18,2 GB | do 16,0 GB |
| Średni pobór mocy karty przy generowaniu | 350 W | 370 W |
| Pliki (model, koder tekstu, VAE) | 20,7 GB | 17,3 GB |
| Licencja | Apache 2.0, komercyjnie tak | Qwen Research, komercyjnie nie |
Pierwsze uruchomienie trwało ponad 6 minut, bo w tym czasie ten sam dysk pobierał kilkadziesiąt gigabajtów innych modeli. Na wolnym dysku NVMe wczytanie zajmuje zwykle kilkadziesiąt sekund. Pamięć karty w tabeli to górna granica: ComfyUI trzyma na karcie wszystko, co się zmieści, a na mniejszej karcie przenosi część modelu do pamięci RAM i działa wolniej.
Galeria: te same polecenia, dwa modele
1. Reportaż: sprzedawczyni na targu
2. Zdjęcie produktu: ceramiczny kubek
3. Polski napis: szyld „PIEKARNIA ŻÓŁĆ”
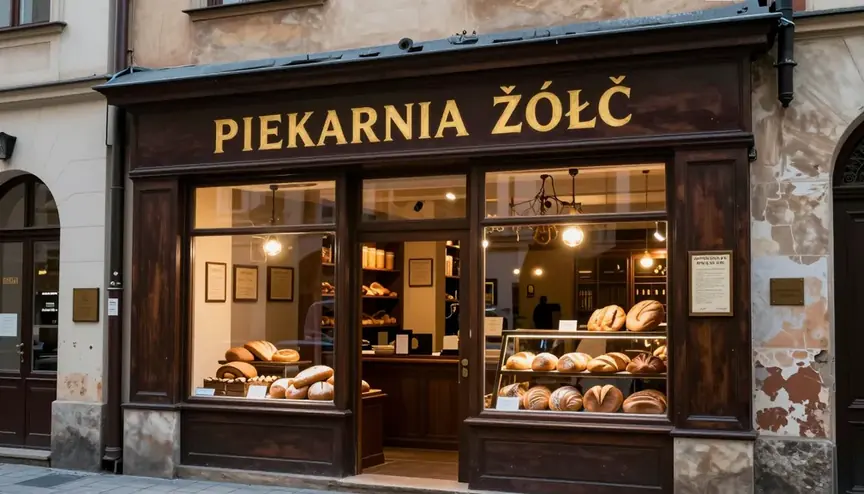
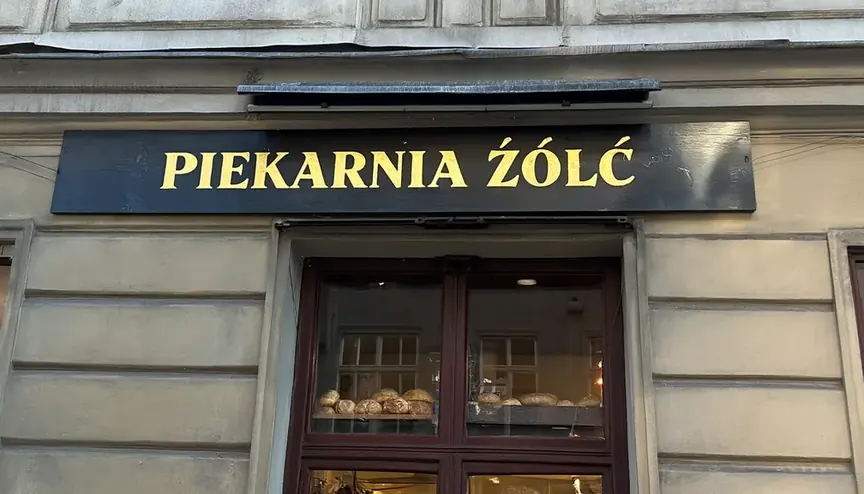
To najważniejsza lekcja z testu: żaden z dwóch lokalnych modeli nie napisał poprawnie słowa z czterema polskimi znakami. Angielski napis wyszedł obu bez zarzutu. Jeśli potrzebujesz polskiego tekstu na grafice, dodaj go później w edytorze. Więcej prób z ogonkami opisałem w teście polskich napisów w Qwen-Image 2.1.
4. Ilustracja w stylu magazynu
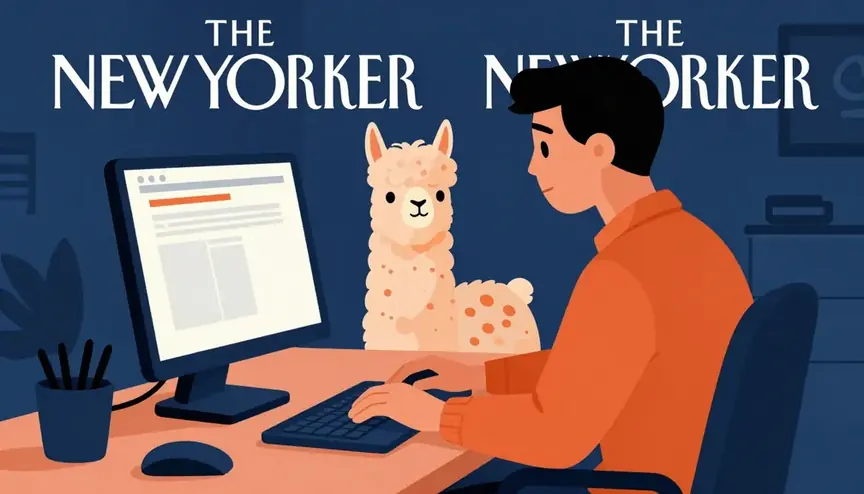
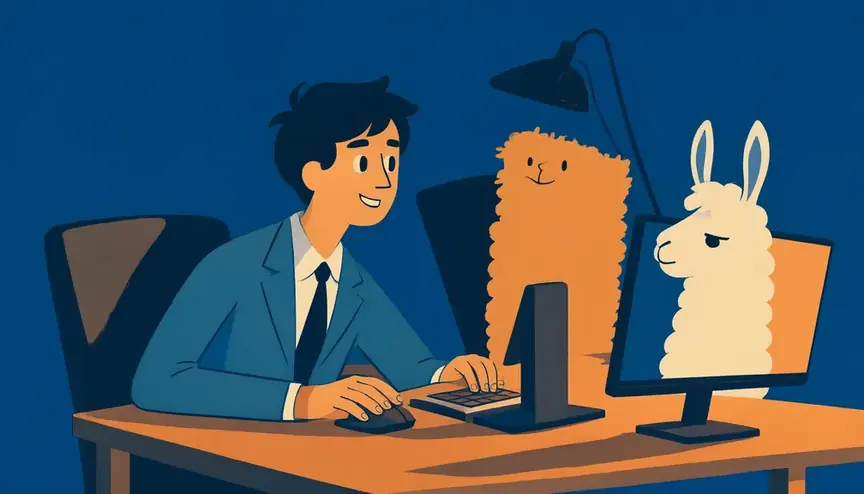
Wzmianka o stylu konkretnego magazynu wystarczyła, żeby Z-Image dorysował jego winietę. Bezpieczniej opisywać styl słowami („płaska ilustracja, ograniczona paleta, grube kontury”) niż nazwą tytułu.
5. Pejzaż: Morskie Oko o świcie
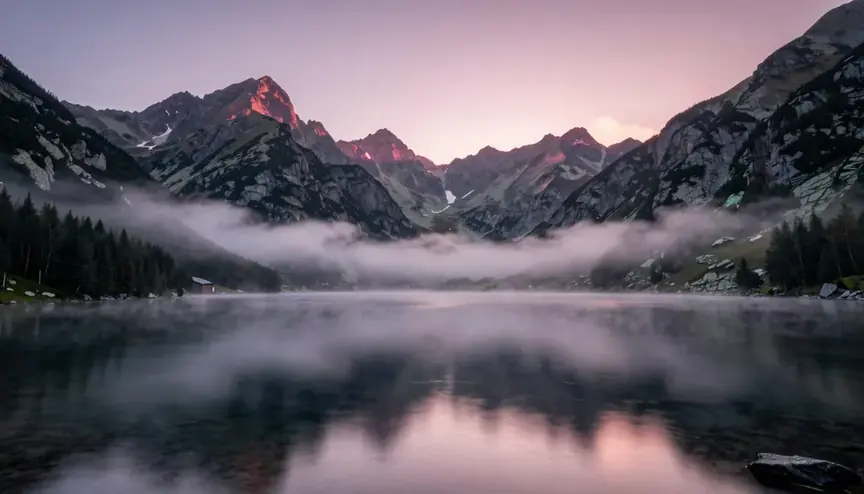
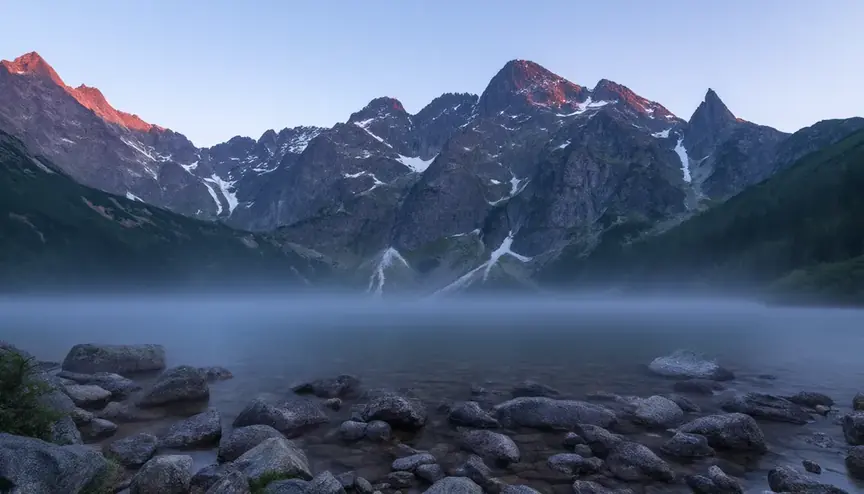
6. Kuchnia z lat 80.
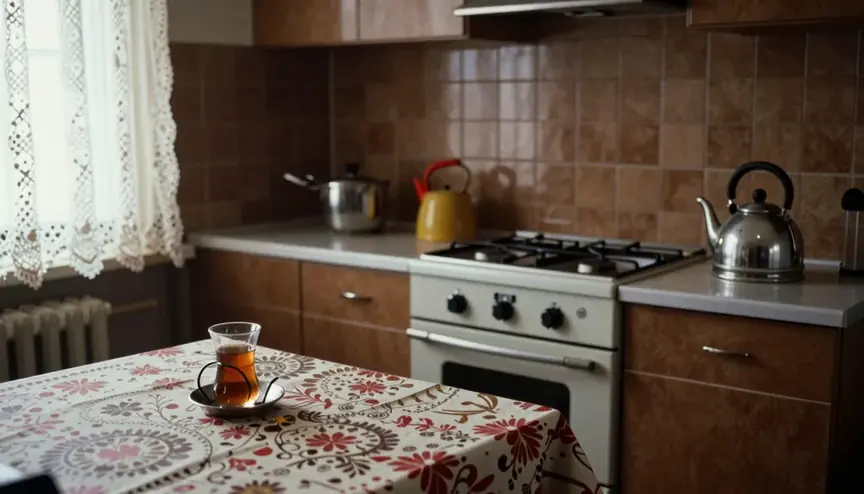
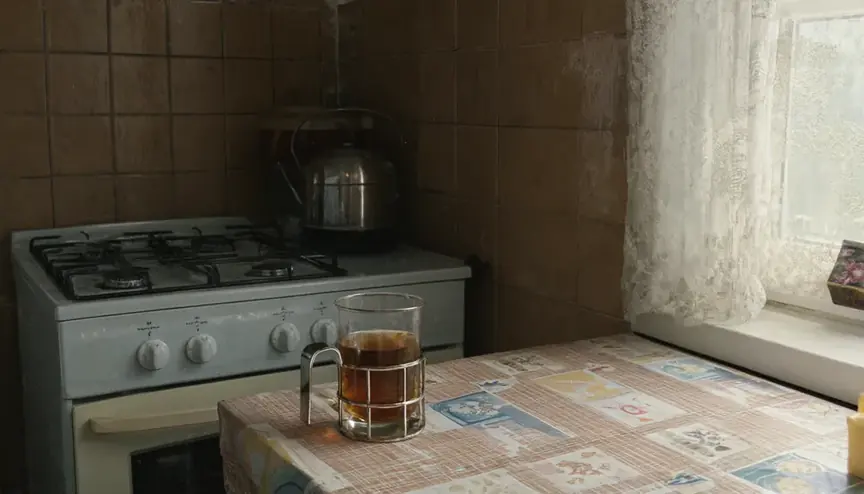
7. Portret z dłońmi
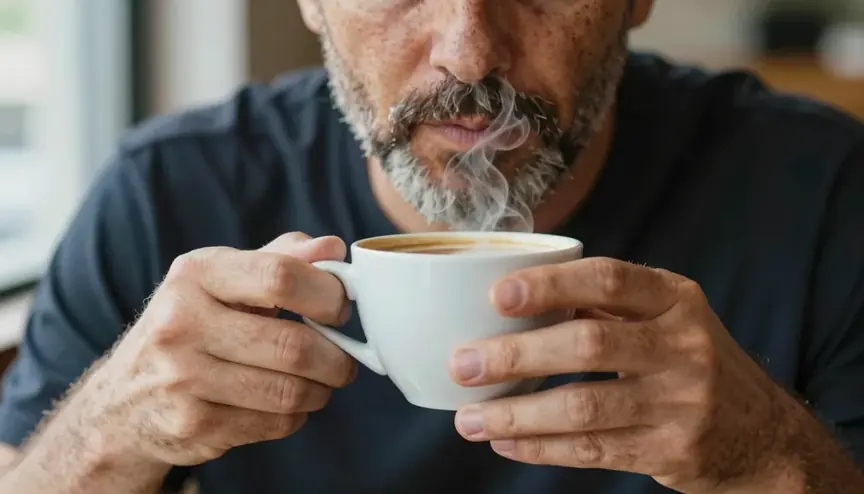
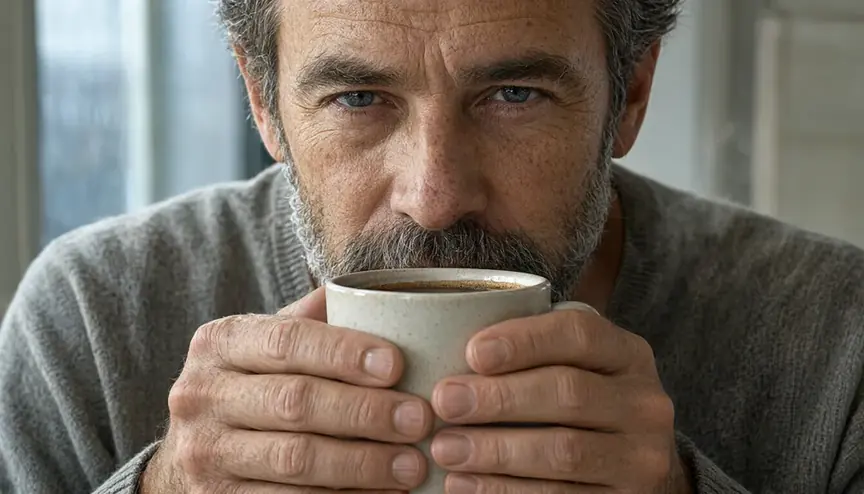
8. Zdjęcie jedzenia: pierogi
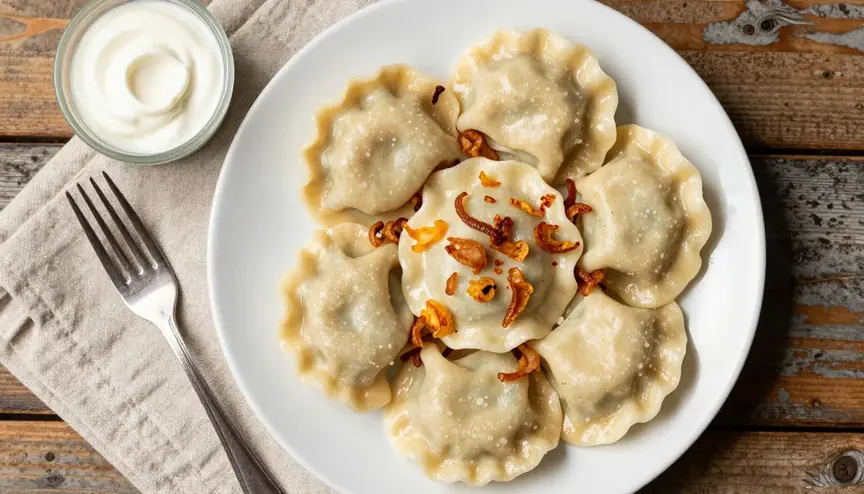
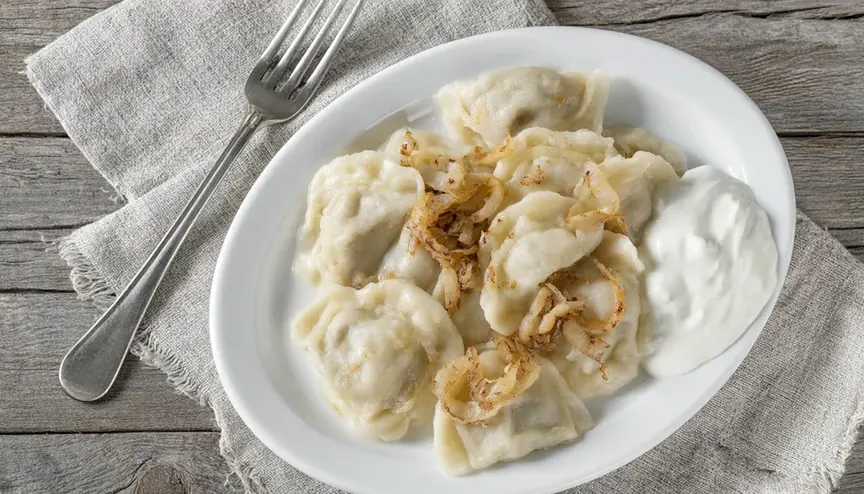
Który wybrać
Jeśli obrazy mają trafić do sklepu, reklamy albo na okładkę, wybór jest prosty: Z-Image Turbo, bo pozwala na to licencja Apache 2.0. Qwen-Image 2.1 jest w tym teście wierniejszy poleceniom i lepiej zna polskie realia, ale jego licencja Qwen Research zakazuje użytku komercyjnego. Pisałem o tym w tekście o Qwen-Image 2.1. To moja opinia: do prywatnych projektów i szkiców warto mieć oba, bo różnią się tam, gdzie jeden zawodzi.
Wymagania są wyższe, niż sugeruje sam rozmiar modelu (6,2 mld parametrów). Pliki w wersji bf16 zajmują 20,7 GB, a w teście ComfyUI zajął do 18 GB pamięci karty. Na kartach z 12-16 GB ComfyUI przeniesie część do RAM-u i obraz powstanie w kilkanaście, a nie w 4 sekundy. Na karcie z 8 GB warto szukać wersji skwantyzowanych (fp8 albo GGUF), które zajmują mniej kosztem jakości.
Ile kosztuje obraz z własnej karty
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Karta pobierała średnio 350 W przez 4,2 sekundy, czyli około 0,0004 kWh na obraz. Przy cenie prądu 1,05 zł za kWh (taryfa G11 z dystrybucją, wrzesień 2026) to 0,04 grosza za obraz, czyli tysiąc obrazów za około 43 grosze. Liczę tylko samą kartę, bez reszty komputera i bez kosztu jej zakupu. Pełny rachunek, także dla modeli tekstowych, jest w tekście lokalny model czy API.
Gotowy skrypt: serie obrazów bez klikania
Wszystkie obrazy z tego testu zrobiłem skryptem, który wysyła polecenia do ComfyUI przez jego API. Wersję do pobrania uprościłem. Podajesz polecenie albo plik z listą poleceń, a skrypt zapisuje obrazy i dziennik CSV z czasem i zużyciem pamięci karty każdego obrazu. Sprawdziłem go 26.09.2026: przy stałym ziarnie kolejne warianty dostają ziarno +1, bo ComfyUI przy identycznym zadaniu oddaje gotowy obraz z pamięci w 0,5 s zamiast liczyć nowy. ComfyUI z modelami postawisz skryptem z poradnika ComfyUI.
- Pobierz: generuj-obrazy.py (6 KB) albo wszystkie 5 skryptów w jednym pliku ZIP (15 KB).
- Jeden obraz:
python generuj-obrazy.py "studio photo of a ceramic mug on concrete" - Seria:
python generuj-obrazy.py --plik polecenia.txt --ile 4 --szer 1024 --wys 1024
Zanim uruchomisz jakikolwiek skrypt z internetu, przeczytaj go. Działa z twoimi uprawnieniami. Dlatego poniżej jest pełny kod, bez skracania, z komentarzami po polsku. Skrypty są na licencji MIT: możesz je zmieniać i używać także w firmie.
"""
generuj-obrazy.py - seria obrazów z Z-Image Turbo przez lokalne ComfyUI, bez klikania (promptowy.com/z-image-turbo/)
Autor: Piotr Olszewski, promptowy.com. Licencja skryptu: MIT. Sprawdzone 26.09.2026: ComfyUI 0.37, RTX 4090.

Wymaga: działającego ComfyUI (http://127.0.0.1:8188) z plikami Z-Image Turbo w folderach models
(skrypt instaluj-comfyui.ps1 pobiera je automatycznie). Tylko biblioteka standardowa Pythona 3.9+.

Przykłady:
  python generuj-obrazy.py "zdjęcie produktowe kubka ceramicznego na betonie"
  python generuj-obrazy.py "plakat z górami o świcie" --ile 4 --szer 1024 --wys 1024
  python generuj-obrazy.py --plik polecenia.txt          (jedno polecenie w linii)

Wynik: folder ./obrazy/ + plik obrazy/log.csv z czasem każdego obrazu i szczytem pamięci karty.
Uwaga: polskie litery na grafice (np. „ŻÓŁĆ”) model zwykle psuje - napisy dodawaj w edytorze.
"""
import argparse, csv, json, os, random, shutil, subprocess, sys, threading, time, urllib.parse, urllib.request, uuid

MODEL = {"unet": "z_image_turbo_bf16.safetensors", "clip": "qwen_3_4b.safetensors", "vae": "ae.safetensors"}


def graf(polecenie, szer, wys, kroki, seed, prefiks):
    # odpowiednik oficjalnego szablonu ComfyUI „Z-Image Turbo text to image”
    return {
        "1": {"class_type": "UNETLoader", "inputs": {"unet_name": MODEL["unet"], "weight_dtype": "default"}},
        "2": {"class_type": "CLIPLoader", "inputs": {"clip_name": MODEL["clip"], "type": "lumina2", "device": "default"}},
        "3": {"class_type": "VAELoader", "inputs": {"vae_name": MODEL["vae"]}},
        "4": {"class_type": "CLIPTextEncode", "inputs": {"clip": ["2", 0], "text": polecenie}},
        "5": {"class_type": "ConditioningZeroOut", "inputs": {"conditioning": ["4", 0]}},
        "6": {"class_type": "ModelSamplingAuraFlow", "inputs": {"model": ["1", 0], "shift": 3.0}},
        "7": {"class_type": "EmptySD3LatentImage", "inputs": {"width": szer, "height": wys, "batch_size": 1}},
        "8": {"class_type": "KSampler", "inputs": {"model": ["6", 0], "seed": seed, "steps": kroki, "cfg": 1.0, "sampler_name": "res_multistep",
                                                    "scheduler": "simple", "positive": ["4", 0], "negative": ["5", 0], "latent_image": ["7", 0], "denoise": 1.0}},
        "9": {"class_type": "VAEDecode", "inputs": {"samples": ["8", 0], "vae": ["3", 0]}},
        "10": {"class_type": "SaveImage", "inputs": {"images": ["9", 0], "filename_prefix": prefiks}},
    }


class PamiecKarty(threading.Thread):
    """Szczyt zajętej pamięci karty (nvidia-smi co 0,5 s). Bez karty Nvidii po prostu zwraca 0."""
    def __init__(self):
        super().__init__(daemon=True); self.stop = False; self.szczyt = 0
    def run(self):
        while not self.stop:
            try:
                o = subprocess.check_output(["nvidia-smi", "--query-gpu=memory.used", "--format=csv,noheader,nounits"], text=True, timeout=5)
                self.szczyt = max(self.szczyt, int(o.split()[0]))
            except Exception:
                return
            time.sleep(0.5)


def api(serwer, sciezka, dane=None):
    req = urllib.request.Request(serwer + sciezka, data=json.dumps(dane).encode() if dane is not None else None,
                                 headers={"Content-Type": "application/json"})
    return json.load(urllib.request.urlopen(req, timeout=30))


def main():
    a = argparse.ArgumentParser(description="Seria obrazów z Z-Image Turbo przez lokalne ComfyUI")
    a.add_argument("polecenie", nargs="?", help="opis obrazu (najlepiej po angielsku)")
    a.add_argument("--plik", help="plik tekstowy z poleceniami, jedno w linii")
    a.add_argument("--ile", type=int, default=1, help="ile wariantów każdego polecenia (domyślnie 1)")
    a.add_argument("--szer", type=int, default=1344); a.add_argument("--wys", type=int, default=768)
    a.add_argument("--kroki", type=int, default=9, help="9 jak w moim teście, szablon ComfyUI ma 8")
    a.add_argument("--seed", type=int, default=None, help="stałe ziarno = powtarzalny wynik")
    a.add_argument("--serwer", default="http://127.0.0.1:8188")
    a.add_argument("--wyjscie", default="obrazy")
    x = a.parse_args()
    polecenia = [x.polecenie] if x.polecenie else []
    if x.plik:
        polecenia += [l.strip() for l in open(x.plik, encoding="utf-8") if l.strip() and not l.startswith("#")]
    if not polecenia:
        a.error("podaj polecenie albo --plik")
    try:
        stat = api(x.serwer, "/system_stats")
    except Exception as e:
        sys.exit(f"Nie mogę połączyć się z ComfyUI pod {x.serwer} ({e}). Uruchom start-comfyui.bat i spróbuj ponownie.")
    os.makedirs(x.wyjscie, exist_ok=True)
    log = open(os.path.join(x.wyjscie, "log.csv"), "a", newline="", encoding="utf-8")
    w = csv.writer(log)
    nr = 0
    for p in polecenia:
        for i in range(x.ile):
            nr += 1
            seed = x.seed + i if x.seed is not None else random.randint(1, 2**31)   # kolejne warianty: ziarno +1
            prefiks = f"promptowy_{uuid.uuid4().hex[:8]}"
            mon = PamiecKarty(); mon.start(); t0 = time.time()
            pid = api(x.serwer, "/prompt", {"prompt": graf(p, x.szer, x.wys, x.kroki, seed, prefiks), "client_id": str(uuid.uuid4())})["prompt_id"]
            while True:
                h = api(x.serwer, f"/history/{pid}")
                if pid in h:
                    break
                time.sleep(0.5)
            czas = time.time() - t0; mon.stop = True
            wynik = h[pid]
            if wynik.get("status", {}).get("status_str") != "success":
                print(f"[{nr}] BŁĄD: {json.dumps(wynik.get('status', {}), ensure_ascii=False)[:400]}"); continue
            img = [o for v in wynik["outputs"].values() for o in v.get("images", [])][0]
            q = urllib.parse.urlencode({"filename": img["filename"], "subfolder": img.get("subfolder", ""), "type": img.get("type", "output")})
            cel = os.path.join(x.wyjscie, f"{nr:03d}_{seed}.png")
            with urllib.request.urlopen(f"{x.serwer}/view?{q}", timeout=60) as r, open(cel, "wb") as f:
                shutil.copyfileobj(r, f)
            w.writerow([time.strftime("%Y-%m-%d %H:%M:%S"), cel, x.szer, x.wys, x.kroki, seed, round(czas, 1), mon.szczyt, p]); log.flush()
            print(f"[{nr}] {cel}  {czas:.1f} s  pamięć karty do {mon.szczyt} MB")
    print("Gotowe. Pierwszy obraz trwa dłużej, bo model wczytuje się z dysku.")


if __name__ == "__main__":
    main()
Najczęstsze pytania
Czy Z-Image Turbo jest darmowy?
Tak. Wagi modelu są udostępnione na Hugging Face na licencji Apache 2.0, która pozwala na użytek komercyjny. Płacisz tylko za prąd i sprzęt.
Jaka karta graficzna jest potrzebna do Z-Image Turbo?
W moim teście wersja bf16 zajęła do 18 GB pamięci karty RTX 4090. Na kartach z 12-16 GB zadziała wolniej, z częścią modelu w pamięci RAM. Na 8 GB potrzebna jest wersja skwantyzowana.
Czy Z-Image Turbo pisze po polsku?
Polecenie po angielsku rozumie dobrze, ale polskie znaki na grafice mu nie wychodzą. W moim teście napisał „ŽÓŁČ” zamiast „ŻÓŁĆ”. Polski tekst lepiej dodać później w edytorze grafiki.
Z-Image Turbo czy Qwen-Image 2.1?
Z-Image jest o jedną trzecią szybszy i można go używać komercyjnie. Qwen-Image w tym teście dokładniej trzymał się poleceń i lepiej oddawał polskie realia, ale jego licencja zakazuje użytku komercyjnego.
Źródła i data sprawdzenia
Test własny: RTX 4090 24 GB, Windows 11, ComfyUI 0.37, 1344×768, ziarno 20260926, Z-Image Turbo bf16 (9 kroków, res_multistep), Qwen-Image 2.1 int8 (25 kroków). Licencje i parametry: Z-Image-Turbo na Hugging Face, Qwen-Image-2.1 na Hugging Face. Pliki dla ComfyUI: Comfy-Org/z_image_turbo. Ceny prądu: rankomat.pl, elektryka.edu.pl. Sprawdzone 26 września 2026.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Najczęstsze pytania
Czy Z-Image Turbo jest darmowy i można go używać komercyjnie?
Tak, Z-Image Turbo jest darmowy i można go używać komercyjnie - wagi modelu dostępne są na Hugging Face na licencji Apache 2.0. Płaci się wyłącznie za prąd i sprzęt, a przy taryfie G11 z września 2026 tysiąc obrazów kosztuje około 43 grosze za energię elektryczną.
Jaka karta graficzna jest potrzebna do uruchomienia Z-Image Turbo lokalnie?
Wersja bf16 zajęła w teście do 18,2 GB pamięci karty RTX 4090. Na kartach z 12-16 GB model zadziała wolniej, bo ComfyUI przeniesie część danych do pamięci RAM, a na karcie z 8 GB potrzebna jest wersja skwantyzowana, np. fp8 lub GGUF.
Czy Z-Image Turbo poprawnie generuje polskie napisy na obrazach?
Nie - w teście zamiast "ŻÓŁĆ" model napisał "ŽÓŁČ", mylą się dwa z czterech polskich znaków. Artykuł zaleca dodawanie polskiego tekstu po wygenerowaniu obrazu, osobno w edytorze grafiki.
Czym różni się Z-Image Turbo od Qwen-Image 2.1 w praktycznym teście?
Z-Image Turbo jest szybszy - 4,2 sekundy wobec 6,5 sekundy na obraz - i ma licencję komercyjną Apache 2.0, podczas gdy Qwen-Image 2.1 ma licencję Qwen Research zakazującą użytku komercyjnego. Qwen-Image 2.1 w testach dokładniej trzymał się szczegółów poleceń i lepiej oddawał polskie realia, np. sceny kuchenno-obyczajowe z lat 80.
Podobne tematy na Promptowym