Przycinanie dużych modeli językowych metodą fizyki: bloki jak sieć spinów Isinga
Badacze z Multiverse Computing opublikowali metodę przycinania dużych modeli językowych, która traktuje wybór bloków do usunięcia jako problem optymalizacyjny znany z fizyki statystycznej - model Isinga.
Ten news ukazał się 2 min po komunikacie źródła.
👁 112 przeczytań
Zespół badaczy z firmy Multiverse Computing opublikował 17 czerwca 2025 roku pracę, w której proponuje zupełnie nowe podejście do kompresji dużych modeli językowych - przycinanie bloków transformera za pomocą optymalizacji Isinga, metody wywodzącej się z fizyki statystycznej. Artykuł dostępny jest na Hugging Face, a jego pełny preprint ukazał się jako arXiv 2602.00161.
Wielki problem małych zasobów
Duże modele językowe, takie jak rodziny Llama czy Mistral, liczą dziesiątki miliardów parametrów rozłożonych w setkach warstw zwanych blokami transformera. Uruchomienie takiego modelu na sprzęcie konsumenckim lub wdrożenie go w infrastrukturze o ograniczonym budżecie obliczeniowym bywa po prostu niemożliwe. Branża od lat szuka skutecznych metod kompresji - od kwantyzacji wag, przez destylację wiedzy, aż po właśnie pruning, czyli dosłowne wycinanie fragmentów sieci neuronowej.
Dotychczasowe podejścia do pruningu bloków były w dużej mierze heurystyczne: usuwano warstwy o najmniejszym wpływie na wynik mierzonym różnymi metrykami podobieństwa lub straty, ale wybór optymalnego zestawu bloków do usunięcia traktowano jako problem zbyt złożony kombinatorycznie, by rozwiązać go dokładnie. Jeśli model ma 32 bloki, liczba możliwych kombinacji do sprawdzenia wynosi 2 do potęgi 32 - ponad cztery miliardy wariantów. Przy 64 blokach to już liczba astronomiczna.
Spin po spinie - logika modelu Isinga
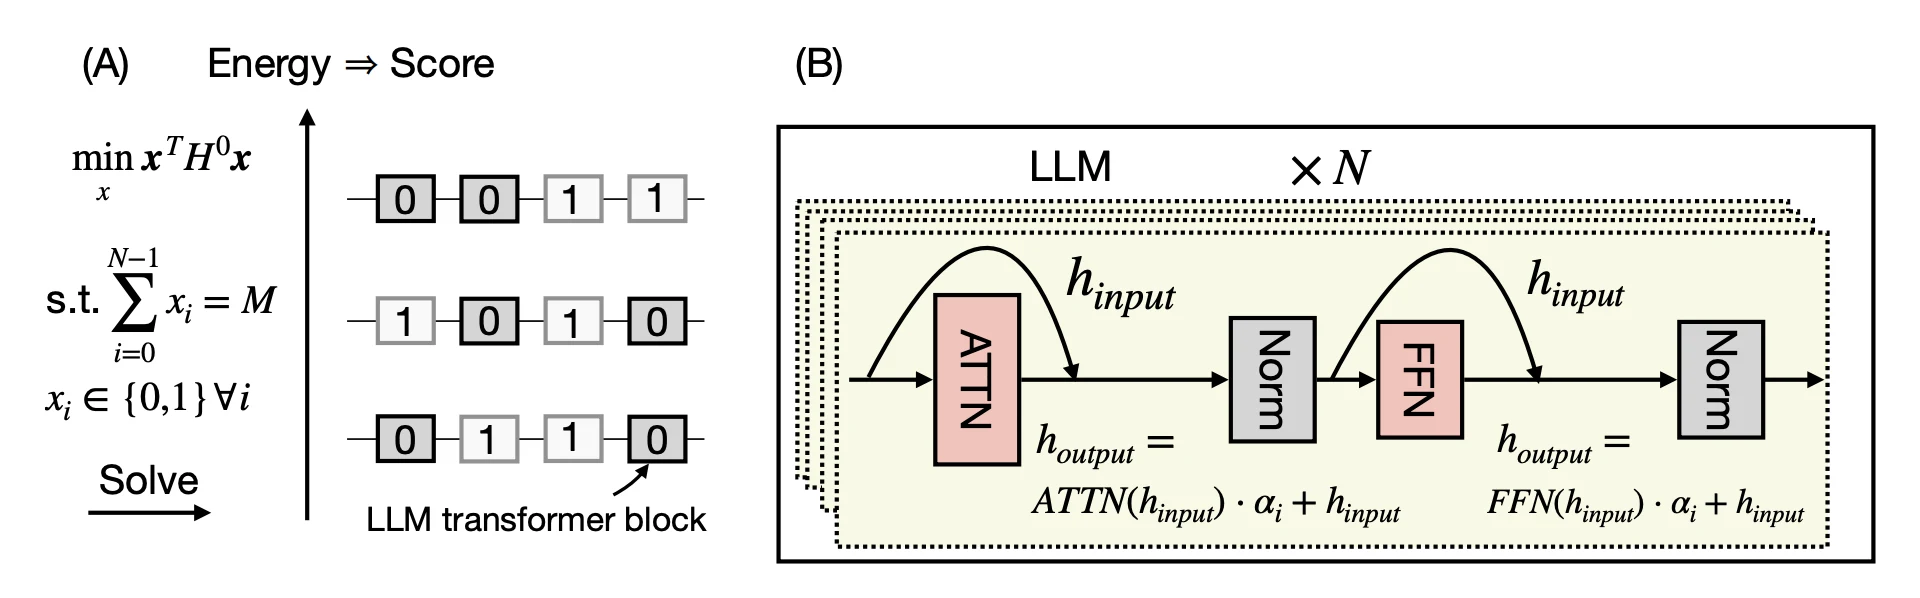
Autorzy pracy proponują przeformułowanie tego problemu. Każdy blok transformera otrzymuje zmienną binarną - zero oznacza usunięcie, jeden oznacza zachowanie. Interakcje między blokami, czyli to, jak usunięcie jednego wpływa na koszt usunięcia innego, kodowane są jako macierz sprzężeń. Powstaje w ten sposób dokładnie struktura znana z modelu Isinga, który fizycy od dekad stosują do opisu układów magnetycznych złożonych z oddziałujących spinów.
Taka reprezentacja nie jest tylko metaforą. Model Isinga ma dobrze zbadane właściwości i - co ważniejsze - istnieją wyspecjalizowane solvery, zarówno klasyczne jak i kwantowe, zdolne efektywnie szukać jego minimów energetycznych. Autorzy korzystają z klasycznych solverów typu QUBO (Quadratic Unconstrained Binary Optimization), by znajdować konfiguracje bloków minimalizujące degradację jakości modelu przy zadanej liczbie usuniętych warstw.
Kluczowym elementem jest sposób wyznaczenia macierzy sprzężeń. Badacze mierzą wpływ par bloków na wartość funkcji straty, używając małego zestawu kalibracyjnego danych. Tam, gdzie usunięcie dwóch bloków jednocześnie powoduje nieaddytywną szkodę - czyli uszkodzenie modelu przekraczające sumę szkód z usunięcia każdego z osobna - pojawia się silne sprzężenie ferromagnetyczne, które solver interpretuje jako sygnał, by zachować przynajmniej jeden z nich. Odwrotnie, bloki, których wspólne usunięcie jest tańsze niż suma indywidualnych kosztów, sprzężone są słabo lub antyferromagnetycznie.
Co to zmienia w praktyce kompresji modeli
Podejście ma kilka praktycznych zalet w porównaniu z klasycznym pruningiem sekwencyjnym lub opartym wyłącznie na rankingu indywidualnych bloków. Po pierwsze, jawnie modeluje interakcje między warstwami, których heurystyki rankingowe nie uwzględniają. Po drugie, przeformułowanie do QUBO otwiera drogę do użycia kwantowych annealerów lub kwantowo inspirowanych solverów - Multiverse Computing jest firmą specjalizującą się właśnie w takich narzędziach, co nadaje pracy wyraźny kontekst komercyjny.
Po trzecie, i być może najważniejsze z perspektywy codziennej pracy inżynierów ML, metoda daje możliwość eksplorowania globalnej przestrzeni kombinatorycznej zamiast zachłannego, lokalnie optymalnego wyboru bloków jeden po drugim. W praktyce zachłanne metody mogą usunąć blok, który samodzielnie ma niewielki wpływ na wyniki, ale którego obecność jest krytyczna dla działania kilku innych warstw. Solver Isinga wyłapuje takie zależności.
Wyniki eksperymentalne przedstawione w pracy pokazują, że metoda pozwala uzyskać lepsze zachowanie metryk jakości - takich jak perplexity na zbiorach testowych - przy tej samej liczbie usuniętych bloków w porównaniu z bazowymi metodami rankingowymi. Autorzy testowali podejście na popularnych architekturach z rodziny Llama, choć szczegółowy zakres benchmarków jest typowy dla wczesnego preprintu: wystarczający, by teza była wiarygodna, ale jeszcze niepoddany recenzji niezależnych badaczy.
Google · Twoje źródłaPromptowy wyżej w Twoim Google - jednym kliknięciemDodaj do preferowanych źródeł →Kwantowe ambicje i klasyczna rzeczywistość
Nie przepłacaj za te subskrypcje
Prowadzę sklep z rocznymi dostępami do narzędzi AI - te same konta, o których piszę wyżej, tylko taniej niż w cenniku producenta.
Nie można pominąć kontekstu instytucjonalnego. Multiverse Computing to firma pracująca na styku optymalizacji kombinatorycznej i technologii kwantowych, a jednym z jej flagowych produktów są właśnie solvery QUBO. Praca jest więc równocześnie badaniem naukowym i demonstracją potencjalnego zastosowania ich własnych narzędzi - to uczciwe, choć warto mieć to na uwadze, czytając wnioski.
Na razie klasyczne solvery QUBO w zupełności wystarczają do rozmiarów modeli stosowanych w eksperymentach - 32 do 64 bloków to problemy, które nowoczesne algorytmy symulowanego wyżarzania lub algorytmy genetyczne rozwiązują w rozsądnym czasie. Kwantowa przewaga pojawiłaby się dopiero przy znacznie większych instancjach lub wyraźnie bardziej skomplikowanych funkcjach kosztu. Ale kierunek jest czytelny: jeśli modele będą rosły, a wraz z nimi potrzeba ich kompresji, optymalizatory kwantowe lub kwantowo inspirowane mogą stać się naturalnym narzędziem w arsenale inżynierów MLops.
Polska społeczność zajmująca się wdrożeniami modeli językowych - od startupów po duże instytucje finansowe i telekomy eksperymentujące z lokalnymi modelami - powinna śledzić ten kierunek badań z co najmniej jednego powodu: koszty infrastruktury. Uruchomienie skompresowanego modelu, który zachowuje 95 procent jakości oryginału przy połowie parametrów, może oznaczać kilkukrotne obniżenie kosztów wnioskowania - a to argument, który trafia do każdego CTO niezależnie od jego stosunku do fizyki statystycznej.
Praca czeka na formalną recenzję, ale już jako preprint wyznacza ciekawy kierunek: fizyka statystyczna jako język dla inżynierii modeli językowych - nieoczywisty sojusz, który może okazać się całkiem praktyczny.
Cały tydzień w AI, w jednym mailu
Wybrane premiery, narzędzia i analizy. Raz w tygodniu, prosto do skrzynki.
Zapisz się za darmo →Podobne tematy na Promptowym