
LoRA-styrka (LoRA weight)
En LoRA är ett smidigt tillägg som lär en bildmodell en specifik stil, karaktär eller produkt, och dess styrka avgör hur mycket tillägget ska påverka slutresultatet. Vid värdet noll sker ingen förändring alls, medan för höga värden gör att stilen tar över och kan förvränga kompositionen. Genom att justera vikten hittar du balansen mellan modellens grundkunskap och det nya konceptet.
Även känd som: LoRA strength, lora scale, strength_model, <lora:namn:0.8>
Före och efter: mitt test
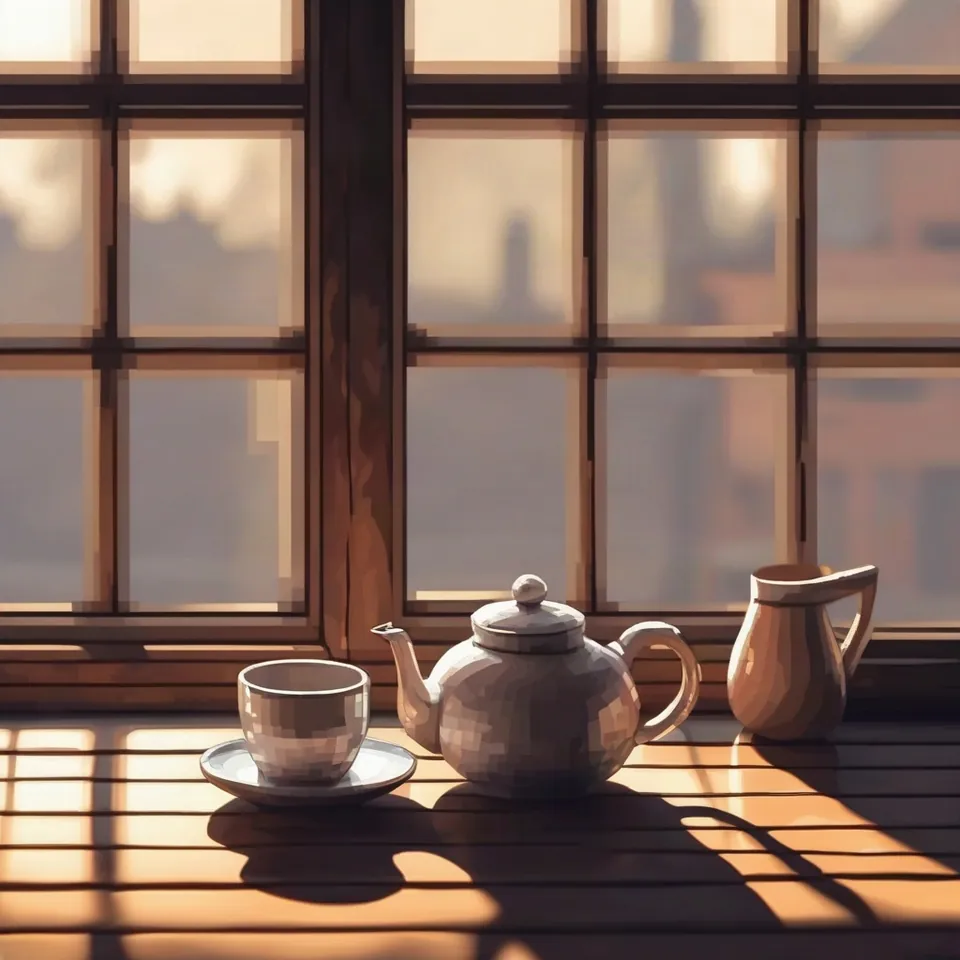
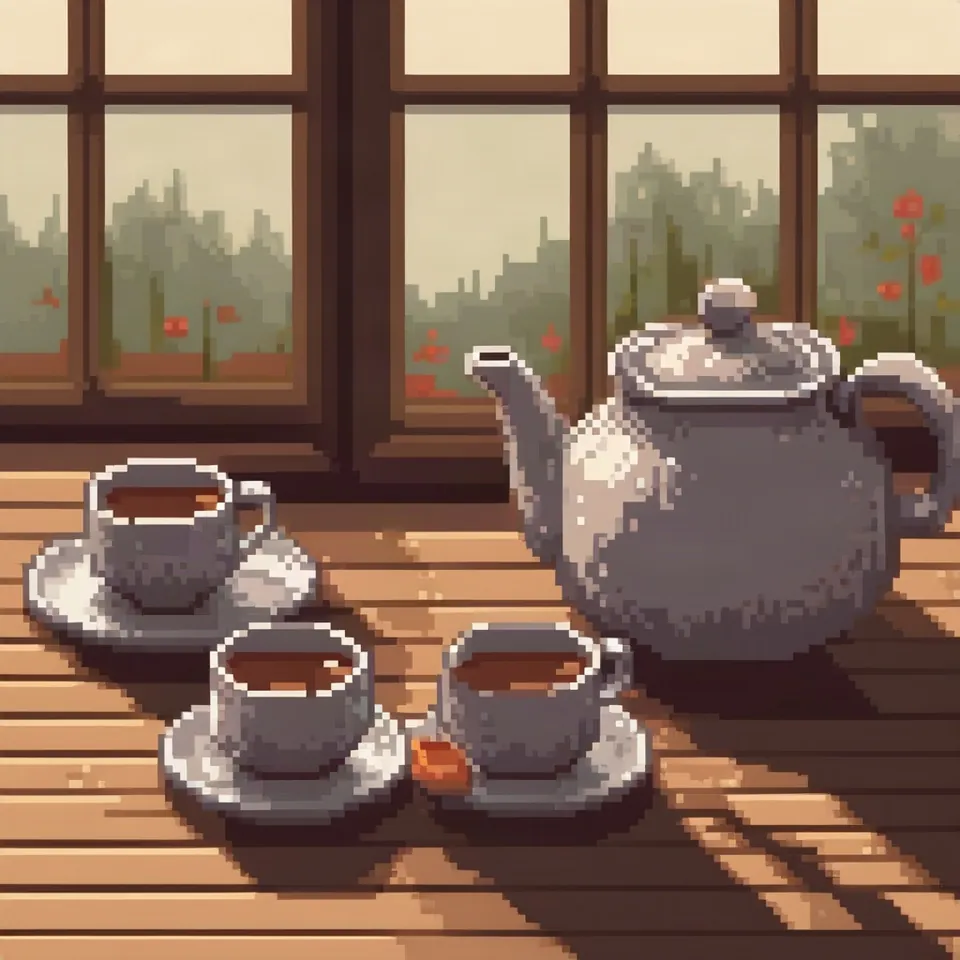
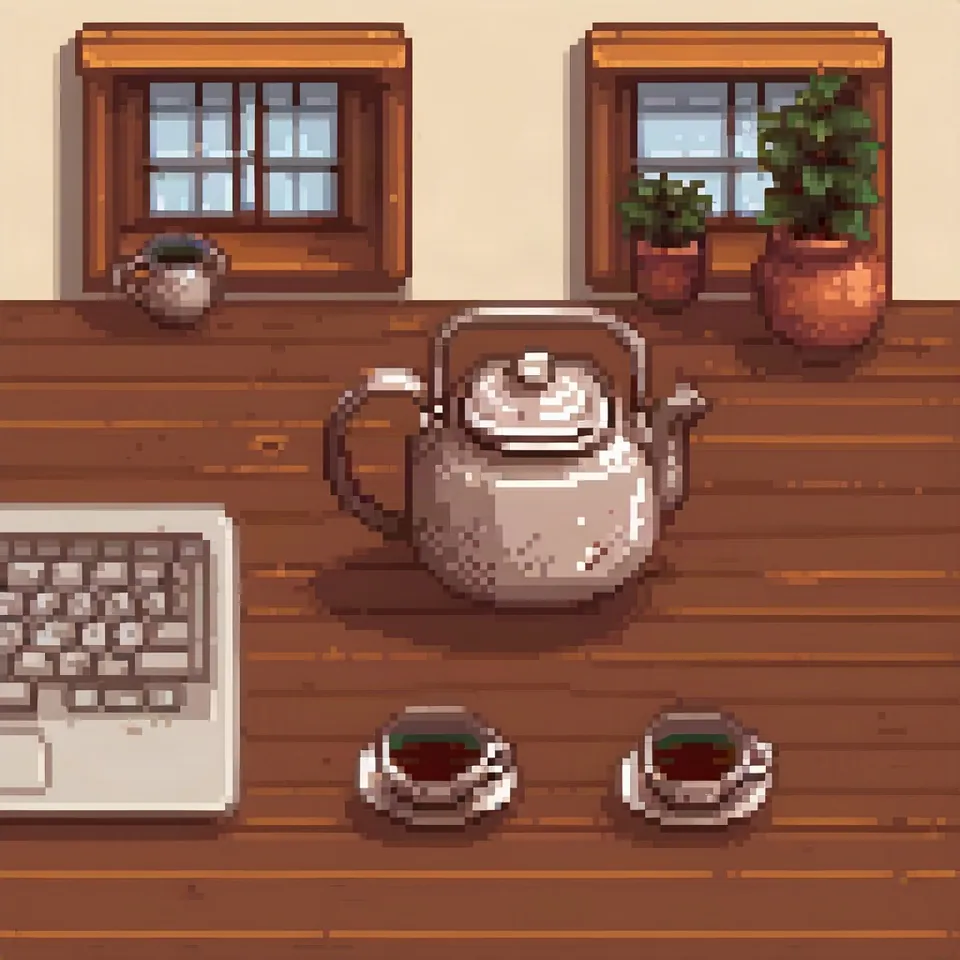
Modell: Stable Diffusion XL 1.0 (przez API fal.ai, 30 kroków, CFG 7,5) + LoRA pixel-art-xl (licencja otwarta, Hugging Face). Inställningar: seed 1411, endast LoRA-styrkan ändras. Datum: 14.11.2026.
Prompt: pixel art, a ceramic teapot and two cups on a wooden table next to a window, soft morning light, still life photo
Vid värdet noll skapade SDXL ett vanligt fotografi, där enbart ordet "pixel art" i prompten inte räckte till alls. Vid 0,6 fick jag ren och snygg pixelgrafik samtidigt som scenens ursprungliga innehåll bevarades. Vid 1,2 blev stilen som kraftigast, men modellen ritade då dit ett laptoptangentbord på bordet trots att det inte efterfrågats. En för hög styrka drar med sig oönskade fragment direkt från träningsdatan.
Vad det kallas i respektive generator
| Generator | Parameter | Värden | Standardvärde |
|---|---|---|---|
| FLUX | LoRA på FLUX 3 Image Klein (öppna vikter) / FLUX.2 [klein] trainingTräning på Klein Base; exempel: rank 32, 20 bilder, 4000 steg, lr 1e-4, ca 4,5 timmar på 1 GPU | LoRA-skala 0.5-1.0 (exempel 0.75 på Distilled) | - |
| Ideogram | custom_model_uri (egna modeller 3.0/4.0)Ingen styrkeparameter | model/<namn>/version/<version> | - |
| ComfyUI | LoraLoader: strength_model, strength_clipStandardvärde och steg från koden i nodes.py; docs.comfy.org anger endast intervall | -100.0 till 100.0, steg 0.01 | 1.0 |
| Midjourney | saknas | - | - |
| GPT Image | saknas | - | - |
| Stability AI (SD 3.5) | saknas i API:et | - | - |
- Källor, kontrollerade 14.11.2026:
- FLUX: docs.bfl.ml/flux_3/flux3_image_klein.md
- Ideogram: developer.ideogram.ai/api-reference/api-reference/generate-v3
- ComfyUI: docs.comfy.org/built-in-nodes/LoraLoader
- Midjourney: docs.midjourney.com/hc/en-us/articles/32859204029709-Parame...
- GPT Image: developers.openai.com/api/docs/guides/image-generation
- Stability AI: docs.stability.ai/llms.txt
När det ska användas
- 0,5 till 0,8 som en trygg utgångspunkt för visuella stilar
- Närmare 1,0 för specifika föremål eller personer som måste återges exakt
- Sänk styrkan på varje enskild LoRA om du kombinerar flera samtidigt, eftersom effekterna adderas
Vanligt misstag
Att glömma LoRA-modellens aktiveringsord (trigger word). Många tillägg kräver en specifik fras i texten, som exempelvis pixel art, för att aktiveras ordentligt: utan den händer ofta ingenting alls. Ett annat vanligt snedsteg är att dra upp styrkan över 1,0 för att vara säker på effekt, vilket snabbt leder till brända färger och trasiga proportioner.
Exempel att kopiera
ComfyUI:  Load LoRA -> strength_model = 0.6, strength_clip = 0.6
AUTOMATIC1111 / Forge:  pixel art, kanna <lora:pixel-art-xl:0.6>
FLUX via API: "loras": [{"path": "...", "scale": 0.6}]Vanliga frågor
Vilken LoRA-styrka ska man välja som standard?
Börja runt 0,6 till 0,8. Om stilen syns för lite kan du öka i steg om 0,1. Börjar ansikten förvanskas eller konstiga detaljer dyka upp bör du sänka styrkan direkt.
Fungerar LoRA i Midjourney eller bildverktyget i ChatGPT?
Nej. LoRA fungerar uteslutande med modeller som har öppna vikter, till exempel Stable Diffusion eller FLUX, som körs på egen hårdvara eller via specialiserade molntjänster.
Kan man använda negativa värden för LoRA-styrka?
Ja, i flera gränssnitt fungerar negativa värden för att tona ned eller motverka stilar och drag som den specifika LoRA-modellen är tränad på.