
Poids du LoRA (LoRA weight)
Un LoRA est un module d'ajustement compact greffé sur un modèle de génération d'images pour lui apprendre un style, un visage ou un objet précis. Son poids, ou sa force, détermine l'intensité avec laquelle cette modification s'applique à la création. À zéro, le modèle ignore totalement le LoRA, tandis qu'une valeur trop élevée écrase les détails du prompt et dégrade le rendu final.
Aussi appelé : LoRA strength, lora scale, strength_model, force du LoRA, <lora:nom:0.8>
Avant et après : mon test
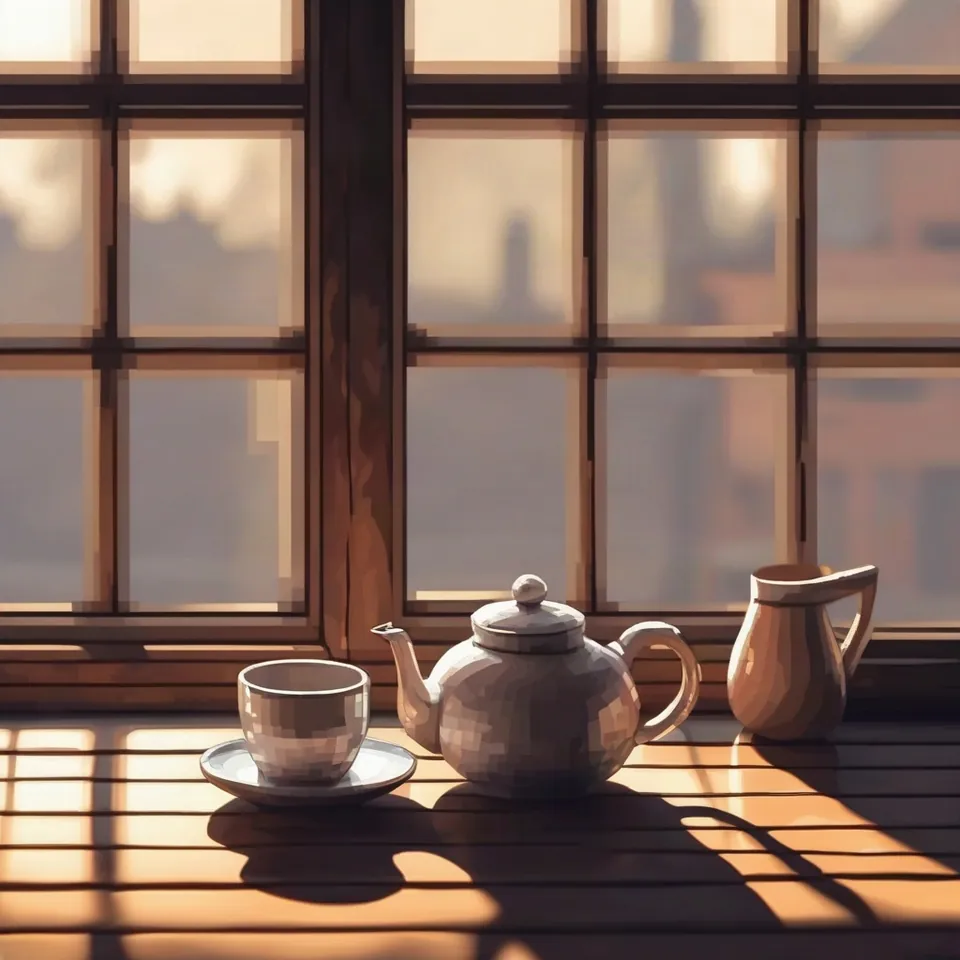
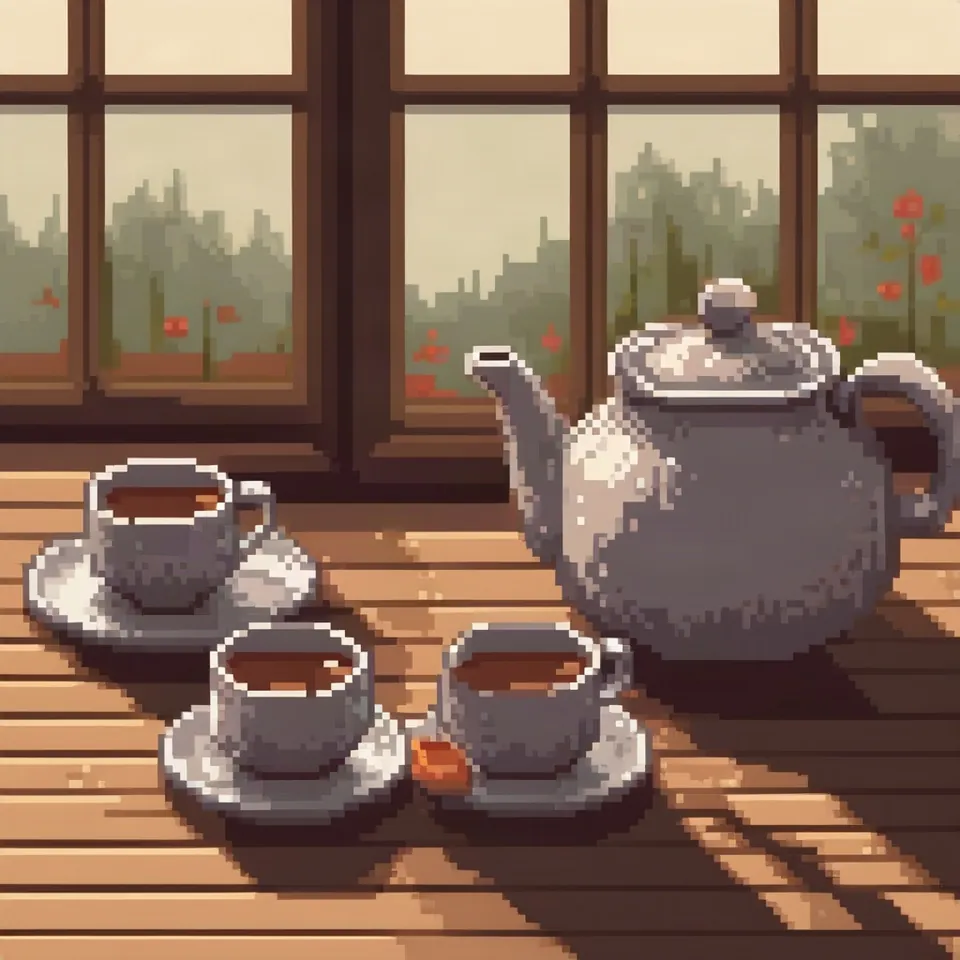
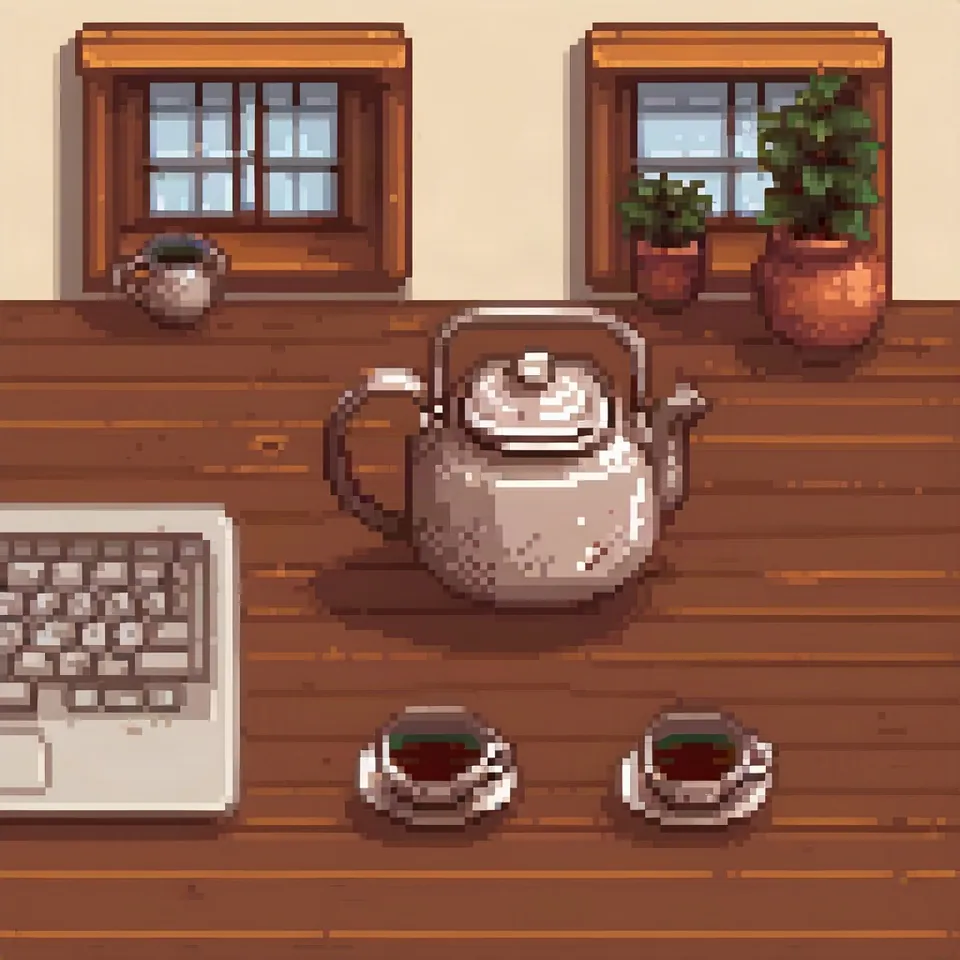
Modèle: Stable Diffusion XL 1.0 (przez API fal.ai, 30 kroków, CFG 7,5) + LoRA pixel-art-xl (licencja otwarta, Hugging Face). Réglages: seed 1411, seule la force du LoRA varie. Date: 14.11.2026.
Prompt: pixel art, a ceramic teapot and two cups on a wooden table next to a window, soft morning light, still life photo
À zéro, SDXL a simplement généré une photo classique : le terme « pixel art » dans mon invite n'a pas suffi. À 0,6, j'ai obtenu une esthétique pixel art très nette tout en conservant fidèlement la composition de la scène. À 1,2, le style était au maximum, mais le modèle a ajouté de lui-même un clavier d'ordinateur sur la table, absent de ma demande. Une force excessive réinjecte des éléments parasites issus de la base d'apprentissage du LoRA.
Nom selon le générateur
| Générateur | Paramètre | Valeurs | Par défaut |
|---|---|---|---|
| FLUX | LoRA sur FLUX 3 Image Klein (open weights) / entraînement FLUX.2 [klein]Entraînement sur Klein Base; exemple: rank 32, 20 images, 4000 étapes, lr 1e-4, env. 4,5 h sur 1 GPU | échelle LoRA 0.5-1.0 (exemple 0.75 sur Distilled) | - |
| Ideogram | custom_model_uri (modèles personnalisés 3.0/4.0)Aucun paramètre de force | model/<nom>/version/<version> | - |
| ComfyUI | LoraLoader: strength_model, strength_clipValeur par défaut et pas issus du code nodes.py; docs.comfy.org n'indique que la plage | -100.0 à 100.0, pas de 0.01 | 1.0 |
| Midjourney | aucun | - | - |
| GPT Image | aucun | - | - |
| Stability AI (SD 3.5) | aucun dans l'API | - | - |
- Sources, vérifiées le 14.11.2026 :
- FLUX: docs.bfl.ml/flux_3/flux3_image_klein.md
- Ideogram: developer.ideogram.ai/api-reference/api-reference/generate-v3
- ComfyUI: docs.comfy.org/built-in-nodes/LoraLoader
- Midjourney: docs.midjourney.com/hc/en-us/articles/32859204029709-Parame...
- GPT Image: developers.openai.com/api/docs/guides/image-generation
- Stability AI: docs.stability.ai/llms.txt
Quand l'utiliser
- Entre 0,5 et 0,8 comme point de départ standard pour appliquer un style visuel sans déformer la scène
- Autour de 0,9 à 1,0 pour un personnage ou un objet technique qui doit rester rigoureusement conforme à la référence
- Baissez la valeur de chaque LoRA vers 0,3 ou 0,4 si vous en superposez plusieurs, car leurs influences s'additionnent rapidement
Erreur fréquente
Oublier d'insérer le mot déclencheur (trigger word) dans l'invite. La plupart des LoRA restent dormants sans ce terme clé (ici : pixel art), rendant le réglage du poids totalement inefficace. Une autre erreur courante consiste à pousser la valeur au-delà de 1,0 par réflexe, ce qui provoque des distorsions d'anatomie, des artéfacts criards et des hallucinations visuelles.
Exemple prêt à copier
ComfyUI : Load LoRA -> strength_model = 0.6, strength_clip = 0.6
AUTOMATIC1111 / Forge : pixel art, pichet <lora:pixel-art-xl:0.6>
FLUX via API (ex. fal) : "loras": [{"path": "...", "scale": 0.6}]Questions fréquentes
Quelle force de LoRA choisir par défaut ?
Une valeur située entre 0,6 et 0,8 constitue le meilleur compromis. Si les traits caractéristiques manquent d'impact, augmentez par paliers de 0,1. Réduisez immédiatement le curseur si des textures bizarres apparaissent sur l'image.
Les LoRA fonctionnent-ils sur Midjourney ou ChatGPT ?
Non. Les LoRA nécessitent des architectures ouvertes où l'on peut charger des fichiers de poids additionnels, comme Stable Diffusion ou FLUX exécutés localement ou sur des serveurs cloud dédiés.
Pourquoi trouve-t-on deux réglages, strength_model et strength_clip, dans ComfyUI ?
strength_model ajuste l'impact sur le réseau visuel principal, tandis que strength_clip dose l'influence sur la compréhension du texte. Conserver la même valeur sur les deux curseurs est la méthode la plus fiable pour débuter.