
LoRA-vekt (LoRA strength)
LoRA er en liten ekstrapakke til bildemodellen som lærer den en helt spesifikk stil, figur eller gjenstand. LoRA-vekt bestemmer hvor kraftig dette tillegget skal påvirke sluttresultatet. Settes verdien til null merker du ingenting, mens for høye verdier gjør at stilen overtar helt og ødelegger bildet.
Også kjent som: LoRA strength, lora scale, strength_model, <lora:navn:0.8>
Før og etter: min test
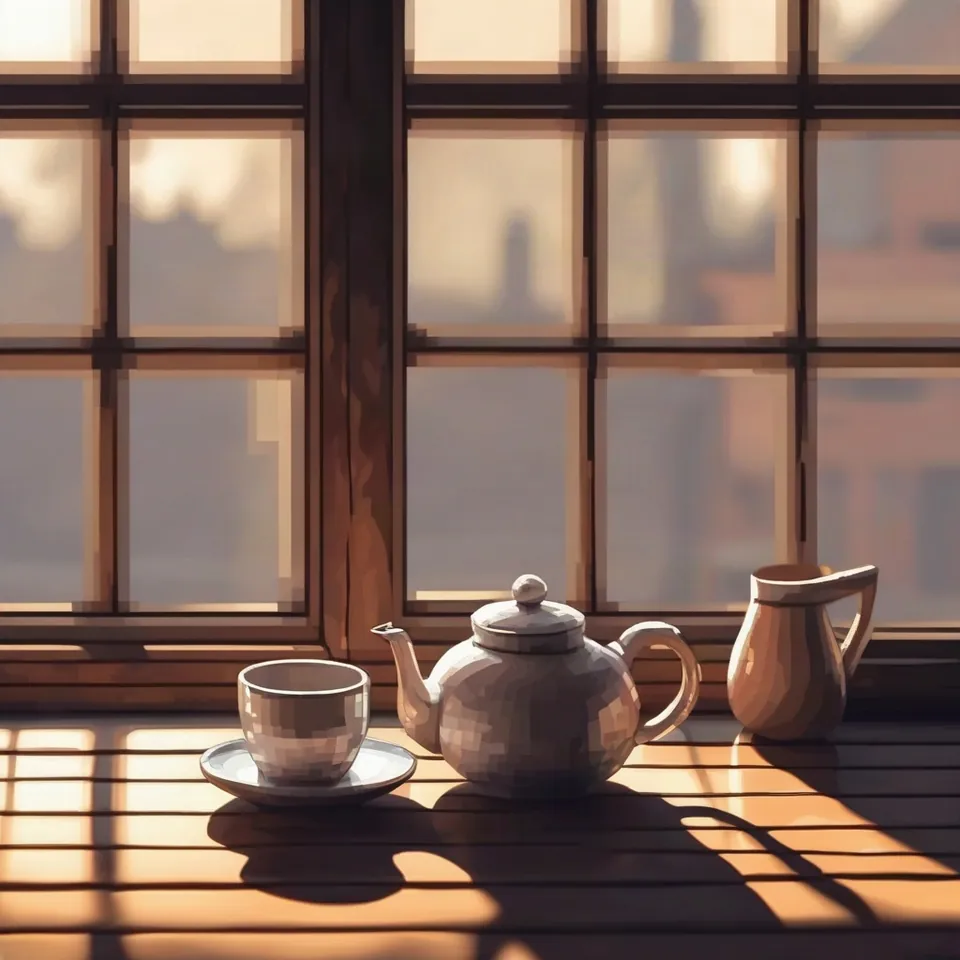
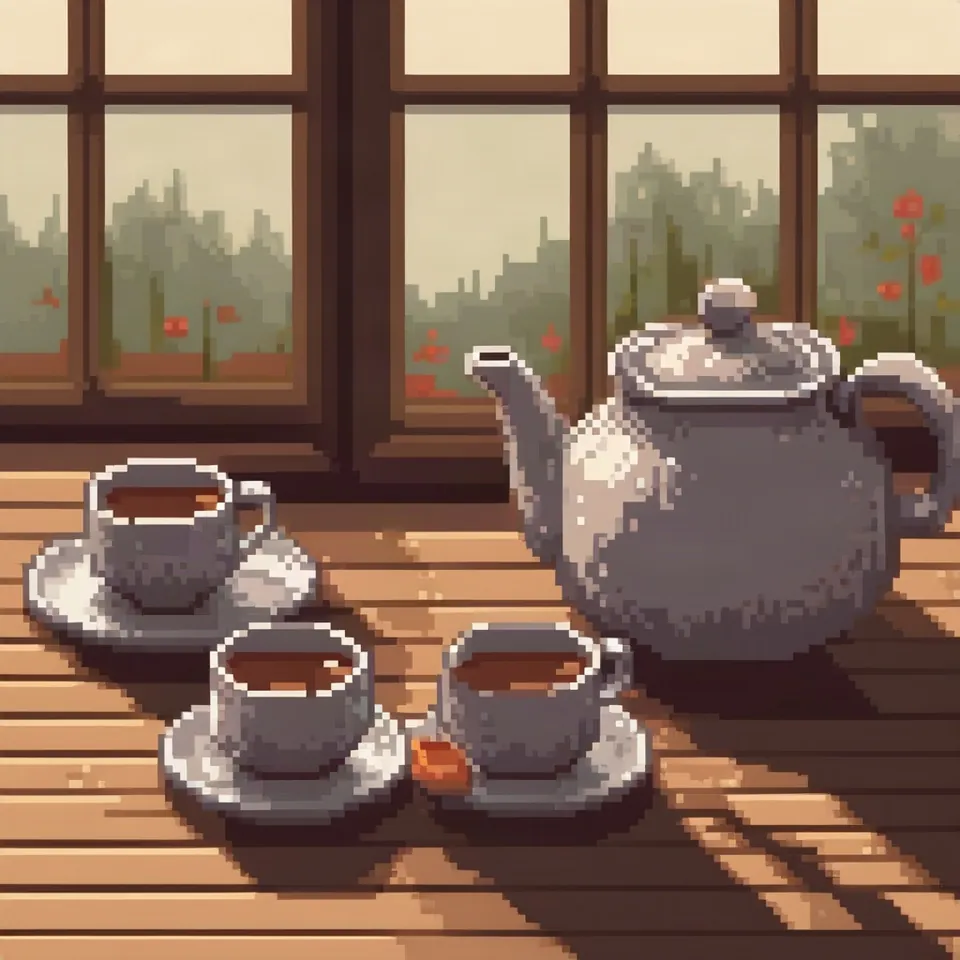
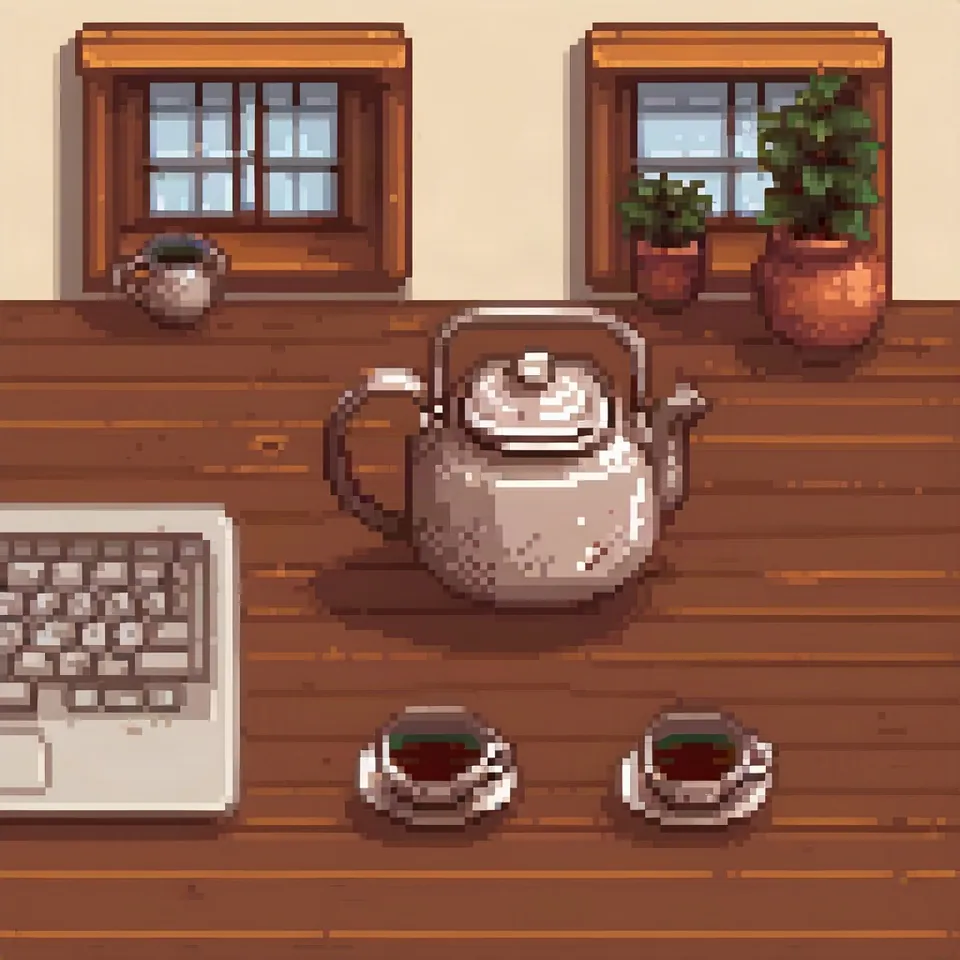
Modell: Stable Diffusion XL 1.0 (przez API fal.ai, 30 kroków, CFG 7,5) + LoRA pixel-art-xl (licencja otwarta, Hugging Face). Innstillinger: seed 1411, bare LoRA-vekt endres. Dato: 14.11.2026.
Prompt: pixel art, a ceramic teapot and two cups on a wooden table next to a window, soft morning light, still life photo
Da jeg satte verdien til 0, genererte SDXL et helt vanlig fotografi, og nøkkelordet 'pixel art' i prompten alene utgjorde ingen forskjell. På 0,6 fikk jeg ren pikselkunst der komposisjonen i scenen var godt bevart. Da jeg skrudde opp til 1,2 ble stilen ekstremt markant, men modellen la plutselig til et laptop-tastatur på bordet som aldri var nevnt i prompten. For høy styrke drar med seg uønskede elementer direkte fra bildene LoRA-modellen opprinnelig ble trent på.
Hva det kalles i de ulike generatorene
| Generator | Parameter | Verdier | Standardverdi |
|---|---|---|---|
| FLUX | LoRA for FLUX 3 Image Klein (open weights) / FLUX.2 [klein] trainingTrening på Klein Base; eksempel: rank 32, 20 bilder, 4000 trinn, lr 1e-4, ca. 4,5 t på 1 GPU | LoRA-skala 0.5-1.0 (eksempel 0.75 på Distilled) | - |
| Ideogram | custom_model_uri (egne modeller 3.0/4.0)Ingen styrkeparameter | model/<navn>/version/<versjon> | - |
| ComfyUI | LoraLoader: strength_model, strength_clipStandardverdi og trinn fra koden nodes.py; docs.comfy.org oppgir bare område | -100.0 til 100.0, trinn 0.01 | 1.0 |
| Midjourney | ingen | - | - |
| GPT Image | ingen | - | - |
| Stability AI (SD 3.5) | finnes ikke i API-et | - | - |
- Kilder, sjekket 14.11.2026:
- FLUX: docs.bfl.ml/flux_3/flux3_image_klein.md
- Ideogram: developer.ideogram.ai/api-reference/api-reference/generate-v3
- ComfyUI: docs.comfy.org/built-in-nodes/LoraLoader
- Midjourney: docs.midjourney.com/hc/en-us/articles/32859204029709-Parame...
- GPT Image: developers.openai.com/api/docs/guides/image-generation
- Stability AI: docs.stability.ai/llms.txt
Når det bør brukes
- 0,5-0,8 er et trygt utgangspunkt for kunstneriske stiler
- Nærmere 1,0 når du gjenskaper konkrete figurer eller produkter som må være helt presise
- Reduser vekten på hver enkelt dersom du kombinerer flere LoRA-modeller samtidig, ettersom effektene forsterker hverandre
Typisk feil
Den vanligste feilen er å glemme modellens triggerord. Mange LoRA-er krever et spesifikt kodeord i prompten for å aktiveres skikkelig, og uten dette skjedde det absolutt ingenting i mitt første forsøk. En annen klassisk tabbe er å sette vekten over 1 bare for å være sikker, noe som nesten alltid fører til visuelle feil og overmettede piksler.
Eksempel klart til kopiering
ComfyUI:  Load LoRA -> strength_model = 0.6, strength_clip = 0.6
AUTOMATIC1111 / Forge:  pixel art, kaffekanne <lora:pixel-art-xl:0.6>
FLUX.2 via API (f.eks. fal): "loras": [{"path": "...", "scale": 0.6}]Ofte stilte spørsmål
Hvilken LoRA-vekt bør jeg starte med?
Start gjerne mellom 0,6 og 0,8. Hvis effekten oppleves for svak, kan du øke med 0,1 om gangen. Ser du rare feil eller unaturlige detaljer, bør du senke vekten straks.
Fungerer LoRA i Midjourney eller ChatGPT?
Nei, LoRA kan bare brukes med modeller som har åpne vekter, for eksempel Stable Diffusion, lokale varianter av FLUX eller Qwen-Image.
Kan jeg bruke negative verdier for LoRA-vekt?
Ja, enkelte brukergrensesnitt tillater negative tall for å fjerne eller motvirke en bestemt stil, men resultatet blir ofte uforutsigbart.