
LoRA-Stärke (LoRA Weight)
Ein LoRA ist ein kompaktes Zusatzmodul für Bildmodelle, das einen bestimmten Stil, eine konkrete Figur oder ein Produkt nachträglich beibringt. Die LoRA-Stärke legt fest, wie intensiv diese Modifikation in das Gesamtbild eingreift. Ein Wert von null schaltet den Effekt ab, während zu hohe Werte die Ästhetik dominieren und Bildfehler erzeugen.
Auch bekannt als: LoRA strength, lora scale, strength_model, <lora:nazwa:0.8>
Vorher und nachher: Praxistest
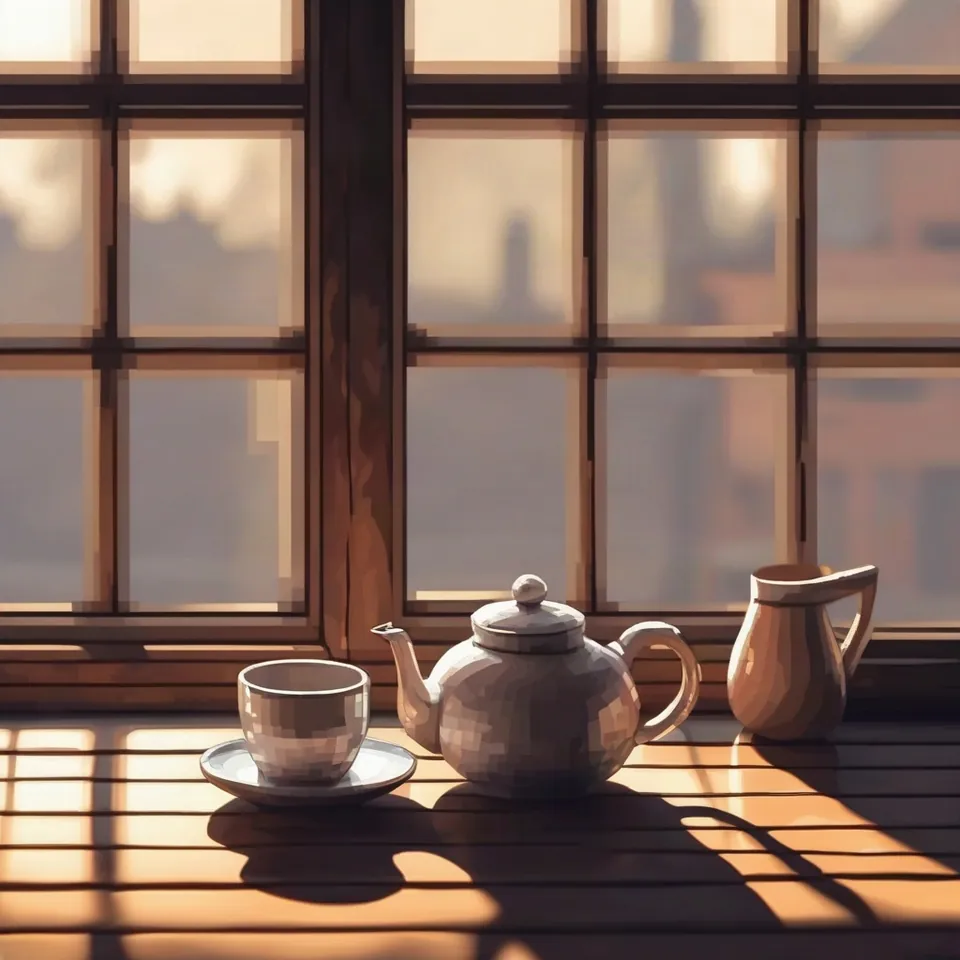
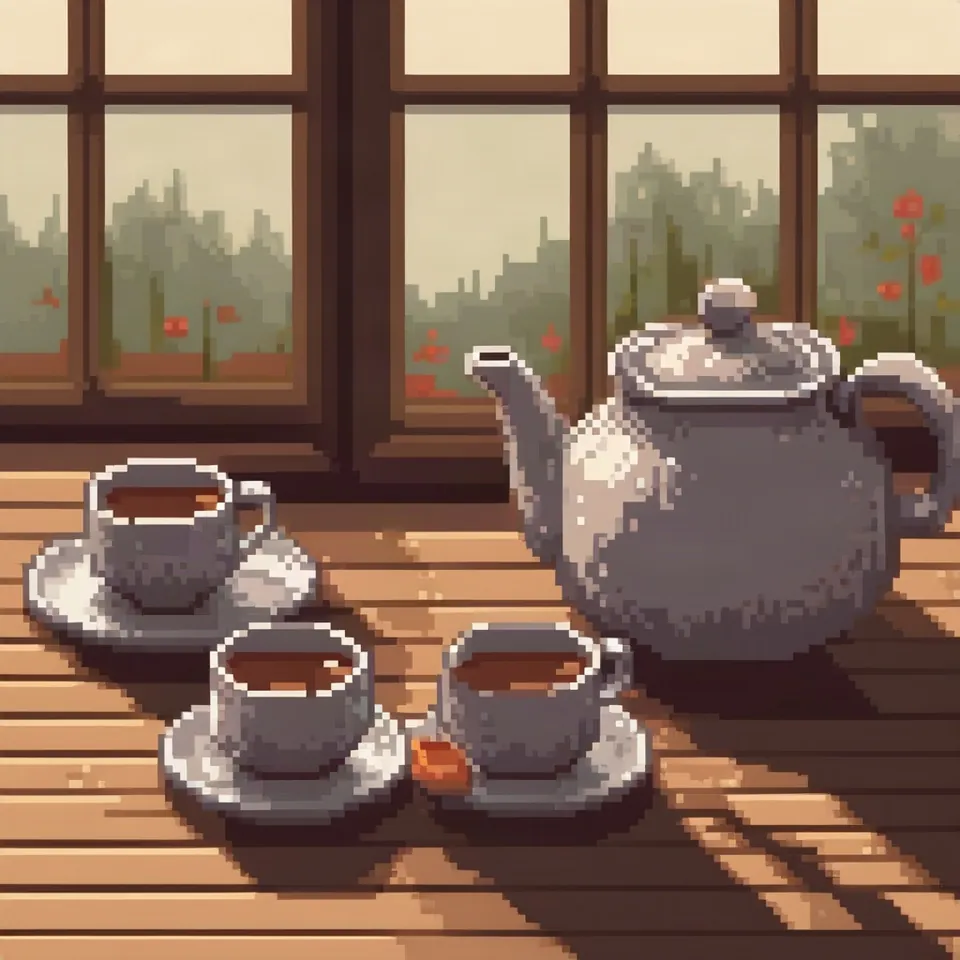
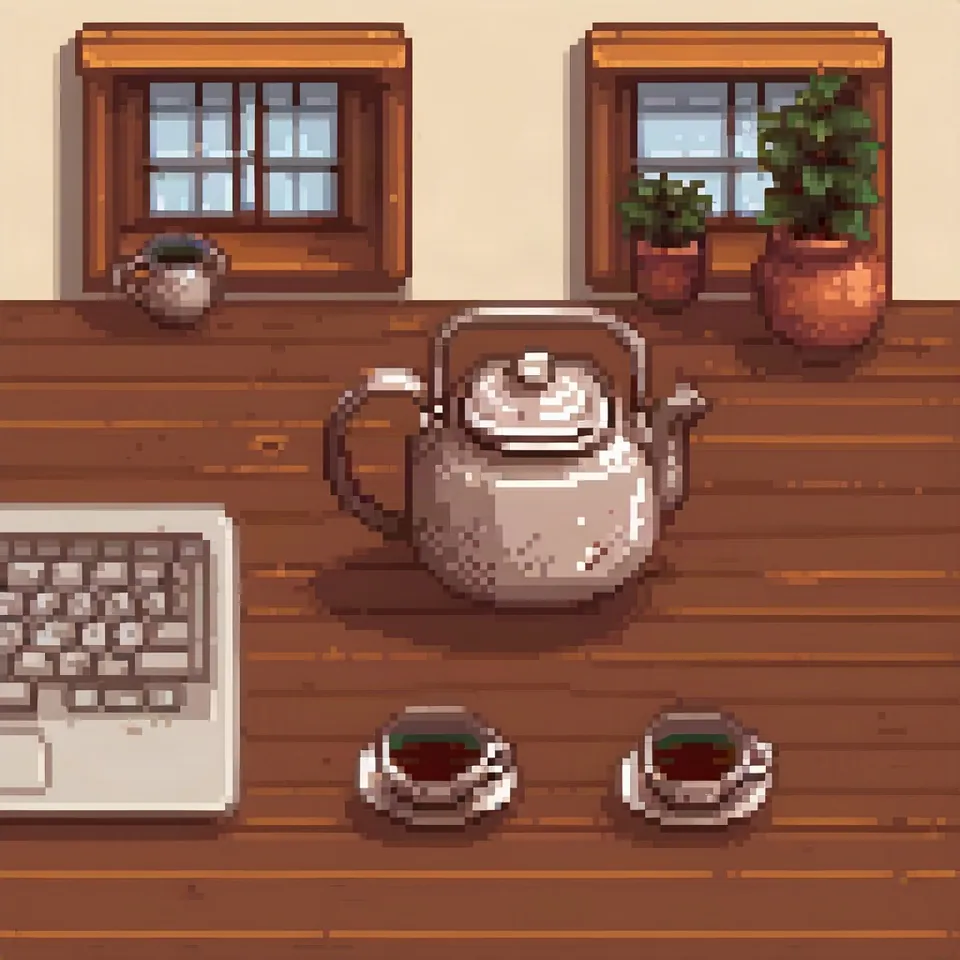
Modell: Stable Diffusion XL 1.0 (przez API fal.ai, 30 kroków, CFG 7,5) + LoRA pixel-art-xl (licencja otwarta, Hugging Face). Einstellungen: Seed 1411, variiert wurde ausschließlich die LoRA-Stärke. Datum: 14.11.2026.
Prompt: pixel art, a ceramic teapot and two cups on a wooden table next to a window, soft morning light, still life photo
Bei einem Wert von 0 lieferte SDXL ein gewöhnliches Foto ab, denn der Zusatz 'pixel art' im Prompt reichte allein nicht aus. Bei 0,6 erhielt ich eine saubere Pixelgrafik, bei der die ursprüngliche Bildkomposition vollständig erhalten blieb. Bei 1,2 trat der Stil extrem markant hervor, allerdings zeichnete das Modell plötzlich eine Laptop-Tastatur auf den Tisch, die gar nicht im Prompt stand. Eine zu hohe Stärke schleust oft ungeplante Versatzstücke aus dem Trainingsmaterial der LoRA ein.
Bezeichnung je Generator
| Generator | Parameter | Werte | Standard |
|---|---|---|---|
| FLUX | LoRA für FLUX 3 Image Klein (Open Weights) / FLUX.2 [klein] trainingTraining auf Klein Base; Beispiel: rank 32, 20 Bilder, 4000 Schritte, lr 1e-4, ca. 4,5 h auf 1 GPU | LoRA-Skala 0.5-1.0 (Beispiel 0.75 bei Distilled) | - |
| Ideogram | custom_model_uri (eigene Modelle 3.0/4.0)Kein Stärkeparameter | model/<Name>/version/<Version> | - |
| ComfyUI | LoraLoader: strength_model, strength_clipStandardwert und Schritt aus Code nodes.py; docs.comfy.org gibt nur den Bereich an | -100.0 bis 100.0, Schritt 0.01 | 1.0 |
| Midjourney | nicht vorhanden | - | - |
| GPT Image | nicht vorhanden | - | - |
| Stability AI (SD 3.5) | nicht in der API vorhanden | - | - |
- Quellen, geprüft am 14.11.2026:
- FLUX: docs.bfl.ml/flux_3/flux3_image_klein.md
- Ideogram: developer.ideogram.ai/api-reference/api-reference/generate-v3
- ComfyUI: docs.comfy.org/built-in-nodes/LoraLoader
- Midjourney: docs.midjourney.com/hc/en-us/articles/32859204029709-Parame...
- GPT Image: developers.openai.com/api/docs/guides/image-generation
- Stability AI: docs.stability.ai/llms.txt
Wann einsetzen
- 0,5 bis 0,8 als zuverlässiger Richtwert für künstlerische Bildstile
- Werte nahe 1,0 für exakte Gesichter, Produkte oder wiederkehrende Charaktere
- Niedrigere Einzelwerte, wenn mehrere LoRAs kombiniert werden, da sich deren Effekte gegenseitig verstärken
Typischer Fehler
Das fehlende Trigger-Wort im Prompt ist die häufigste Fehlerquelle. Viele LoRA-Dateien reagieren erst, wenn ein festgelegter Signalbegriff mitgegeben wird; ohne ihn passierte bei meinem ersten Versuch schlichtweg gar nichts. Ebenso problematisch ist der Reflex, den Wert rein vorsorglich über 1,0 zu setzen, was das Bild meist durch Artefakte und Detailverfälschungen unbrauchbar macht.
Beispiel zum Kopieren
ComfyUI:  Load LoRA -> strength_model = 0.6, strength_clip = 0.6
AUTOMATIC1111 / Forge:  pixel art, krug <lora:pixel-art-xl:0.6>
FLUX.2 über API (z. B. fal): "loras": [{"path": "...", "scale": 0.6}]Häufig gestellte Fragen
Welche LoRA-Stärke sollte man als Standard wählen?
Ein Startwert zwischen 0,6 und 0,8 ist ideal. Falls der Effekt zu schwach bleibt, lässt sich die Stärke in Schritten von 0,1 erhöhen. Schleichen sich unerwünschte Artefakte ein, regelt man den Wert wieder leicht nach unten.
Funktionieren LoRAs auch mit Midjourney oder GPT Image?
Nein, LoRAs setzen den direkten Zugriff auf die Modellgewichte voraus. Sie funktionieren ausschließlich mit Open-Weight-Systemen wie Stable Diffusion, FLUX-Varianten oder lokal betriebenen Modellen.
Warum unterscheidet ComfyUI zwischen Model- und CLIP-Stärke?
Die Model-Stärke beeinflusst die eigentlichen Bildmuster im Generator, während die CLIP-Stärke steuert, wie präzise der Text-Encoder die LoRA-Begriffe verarbeitet. Meist stellt man beide Werte identisch ein.