
LoRA-painotus (LoRA weight)
LoRA on kompakti lisäkoulutettu tiedosto, joka opettaa kuvageneraattorille tietyn tyylin, hahmon tai esineen. LoRA-painotus määrittää, kuinka voimakkaasti tämä lisäosa vaikuttaa lopputulokseen. Nolla-arvolla malli toimii ilman lisäosaa, kun taas liian korkea arvo pakottaa tyylin läpi niin vahvasti, että kuva alkaa vääristyä ja hajota.
Tunnetaan myös nimellä: LoRA strength, lora scale, strength_model, <lora:nimi:0.8>
Ennen ja jälkeen: oma testini
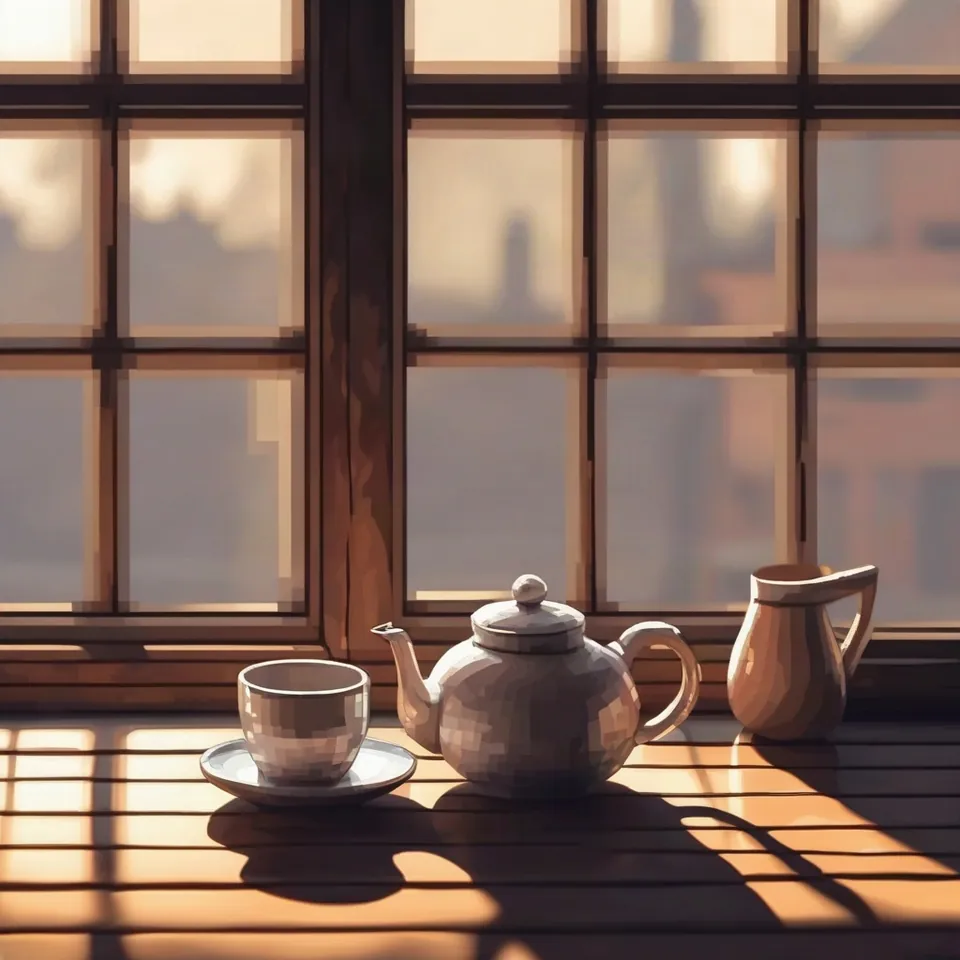
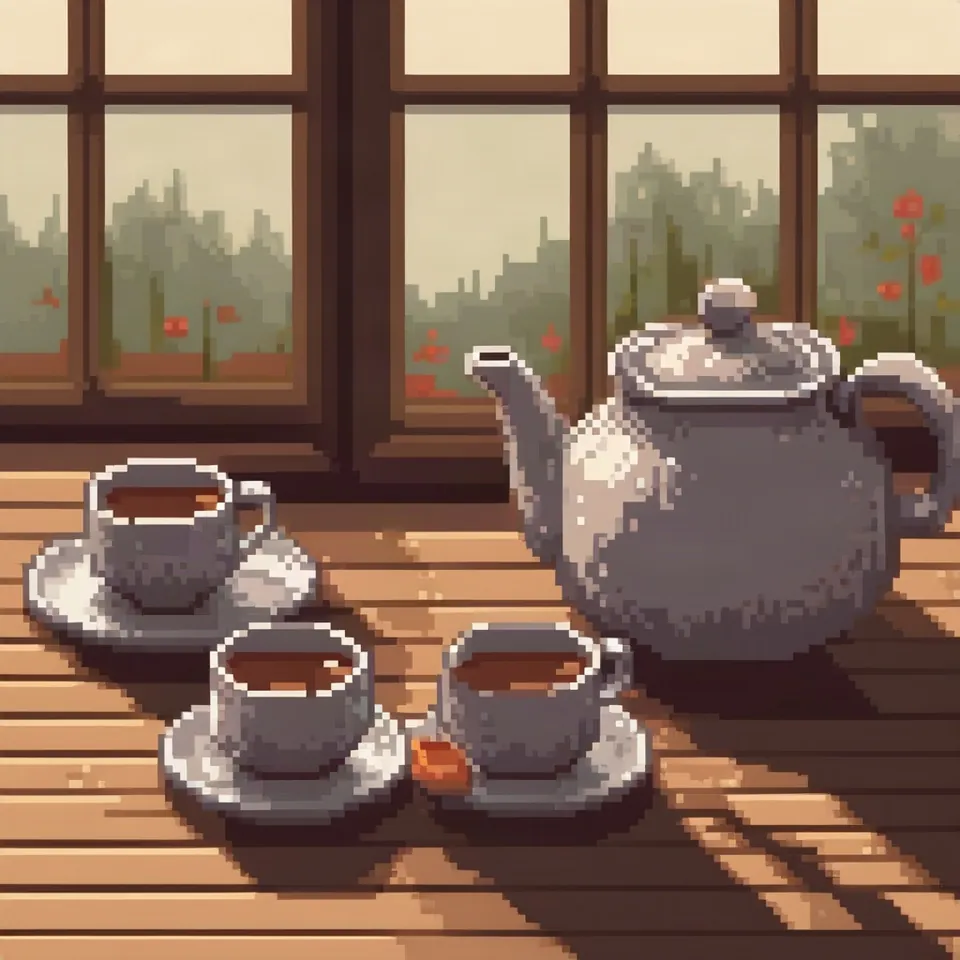
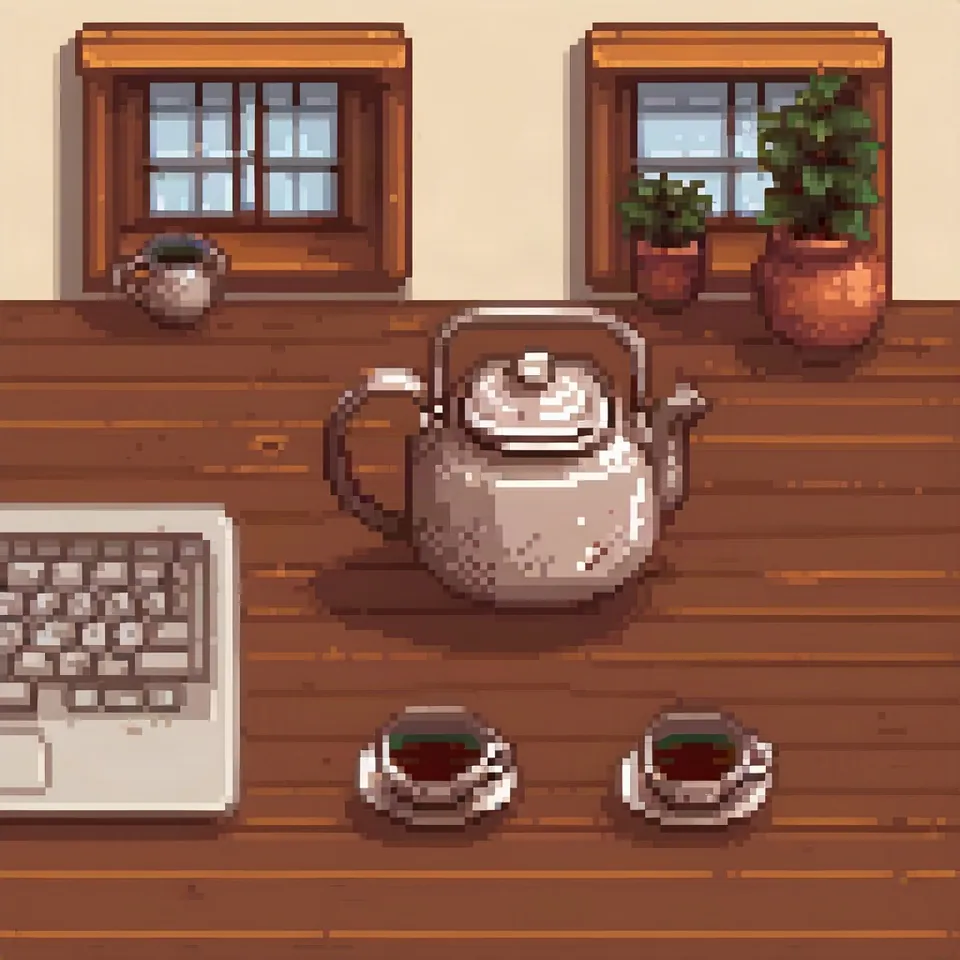
Malli: Stable Diffusion XL 1.0 (przez API fal.ai, 30 kroków, CFG 7,5) + LoRA pixel-art-xl (licencja otwarta, Hugging Face). Asetukset: siemenluku 1411, ainoastaan LoRA-painotusta muutetaan. Päivämäärä: 14.11.2026.
Kehote: pixel art, a ceramic teapot and two cups on a wooden table next to a window, soft morning light, still life photo
Arvolla 0 SDXL loi aivan tavallisen valokuvan, sillä pelkkä 'pixel art' kehötteessä ei riittänyt toivottuun tyyliin. Arvolla 0,6 sain puhdasta pikseligrafiikkaa, jossa itse kohtaus säilyi täysin selkeänä. Arvolla 1,2 pikselityyli oli voimakkain, mutta malli piirsi pöydälle kannettavan tietokoneen näppäimistön, jota en ollut lainkaan pyytänyt. Liian korkea painotus tuo kuvaan väkisin elementtejä LoRAn omasta opetusdatasta.
Termi eri generaattoreissa
| Generaattori | Parametri | Arvot | Oletus |
|---|---|---|---|
| FLUX | LoRA kohteelle FLUX 3 Image Klein (open weights) / FLUX.2 [klein] trainingKoulutus Klein Base -mallilla; esimerkki: rank 32, 20 kuvaa, 4000 vaihetta, lr 1e-4, n. 4,5 h yhdellä GPU:lla | LoRA-asteikko 0.5-1.0 (esimerkki 0.75 Distilled-mallissa) | - |
| Ideogram | custom_model_uri (omat mallit 3.0/4.0)Ei voimakkuusparametria | model/<nimi>/version/<versio> | - |
| ComfyUI | LoraLoader: strength_model, strength_clipOletus ja askelväli tiedostosta nodes.py; docs.comfy.org ilmoittaa vain alueen | -100.0 - 100.0, askelväli 0.01 | 1.0 |
| Midjourney | ei ole | - | - |
| GPT Image | ei ole | - | - |
| Stability AI (SD 3.5) | ei API:ssa | - | - |
- Lähteet, tarkistettu 14.11.2026:
- FLUX: docs.bfl.ml/flux_3/flux3_image_klein.md
- Ideogram: developer.ideogram.ai/api-reference/api-reference/generate-v3
- ComfyUI: docs.comfy.org/built-in-nodes/LoraLoader
- Midjourney: docs.midjourney.com/hc/en-us/articles/32859204029709-Parame...
- GPT Image: developers.openai.com/api/docs/guides/image-generation
- Stability AI: docs.stability.ai/llms.txt
Milloin käyttää
- Käytä arvoa 0,5-0,8 hyvänä aloituspisteenä yleisille tyyleille
- Nosta arvoa lähelle 1,0, kun hahmon tai tietyn tuotteen täytyy toistua täsmällisesti
- Laske jokaisen lisäosan arvoa, jos käytät useampaa LoRA-mallia samanaikaisesti, koska niiden vaikutukset kertaantuvat
Tyypillinen virhe
Yleisin virhe on herätesanan eli liipaisinsanan unohtaminen kehötteestä. Moni LoRA aktivoituu kunnolla vasta tietyn avainsanan avulla (kuten tässä tapauksessa: pixel art), ja ilman sitä lisäosa ei omassa kokeilussani muuttanut kuvaa lainkaan. Toinen tyypillinen harhaluulo on vääntää painotus varmuuden vuoksi reilusti yli ykkösen, mikä aiheuttaa kuvaan suttua ja ylimääräisiä häiriöitä.
Kopioitava esimerkki
ComfyUI:  Load LoRA -> strength_model = 0.6, strength_clip = 0.6
AUTOMATIC1111 / Forge:  pixel art, kannu <lora:pixel-art-xl:0.6>
FLUX.2 API:n kautta (esim. fal): "loras": [{"path": "...", "scale": 0.6}]Usein kysytyt kysymykset
Mikä on paras LoRA-painotus aloittelijalle?
Turvallinen lähtökohta useimmille malleille on 0,6-0,8. Jos tyyli tuntuu liian laimealta, nosta lukua 0,1 kerrallaan. Jos taas kuvaan ilmestyy outoja ylimääräisiä esineitä tai värivirheitä, laske arvoa.
Toimiiko LoRA Midjourneyssä tai ChatGPT:n kuvatyökalussa?
Ei toimi. LoRA-tiedostot on tarkoitettu vain avoimiin malleihin, kuten paikallisesti ajettavaan Stable Diffusioniin, avoimeen FLUX-malliin tai Qwen-Imageen.
Voiko useampaa LoRA-mallia yhdistää samaan kuvaan?
Kyllä voi, esimerkiksi yhdistämällä yhden LoRAn hahmoa varten ja toisen taustatyyliksi. Tällöin kummankin LoRAn painotus kannattaa kuitenkin säätää maltilliseksi, esimerkiksi tasolle 0,4-0,6, jotta ne eivät riitele keskenään.