
ControlNet (peso de controle)
O ControlNet é uma extensão que orienta o modelo de imagem a seguir rigorosamente a estrutura de uma imagem guia, como linhas de contorno, mapas de profundidade ou poses humanas. O peso de controle, também chamado de conditioning scale, define a intensidade com que a IA deve obedecer a esse esqueleto geométrico. Valores menores concedem liberdade para a IA improvisar, enquanto valores altos forçam o alinhamento pixel por pixel.
Também conhecido como: ControlNet, conditioning scale, controlnet strength, canny, depth, pose
Antes e depois: meu teste
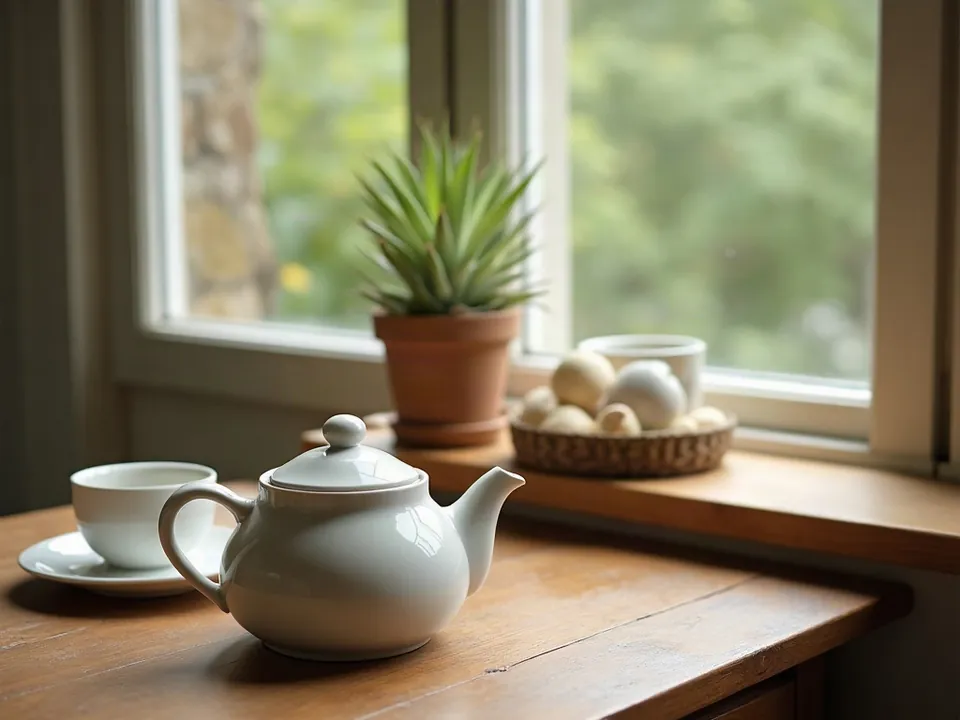
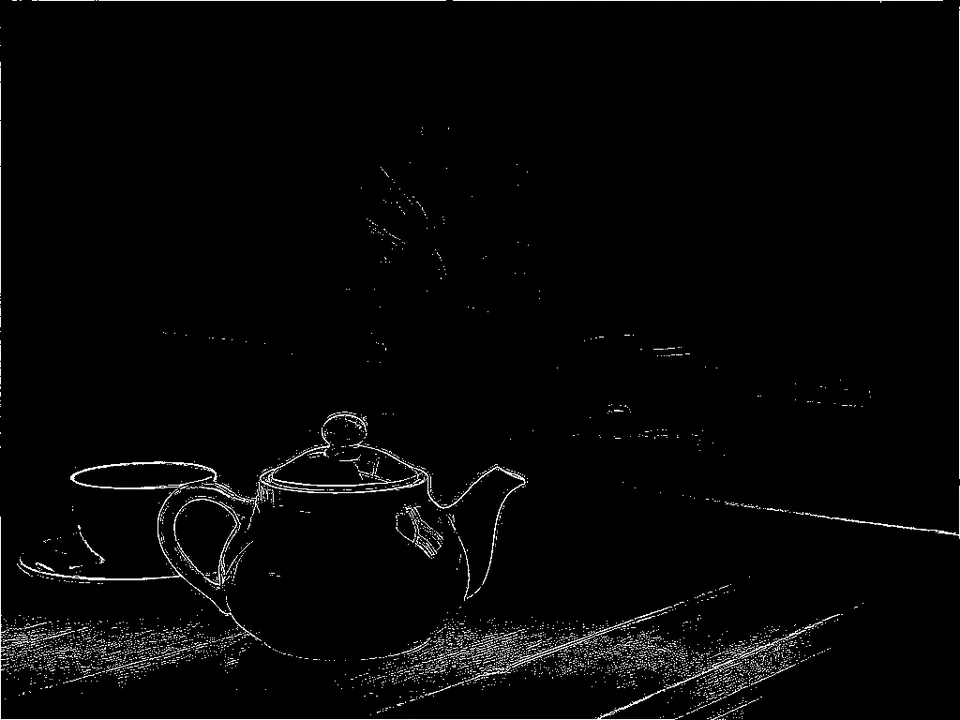
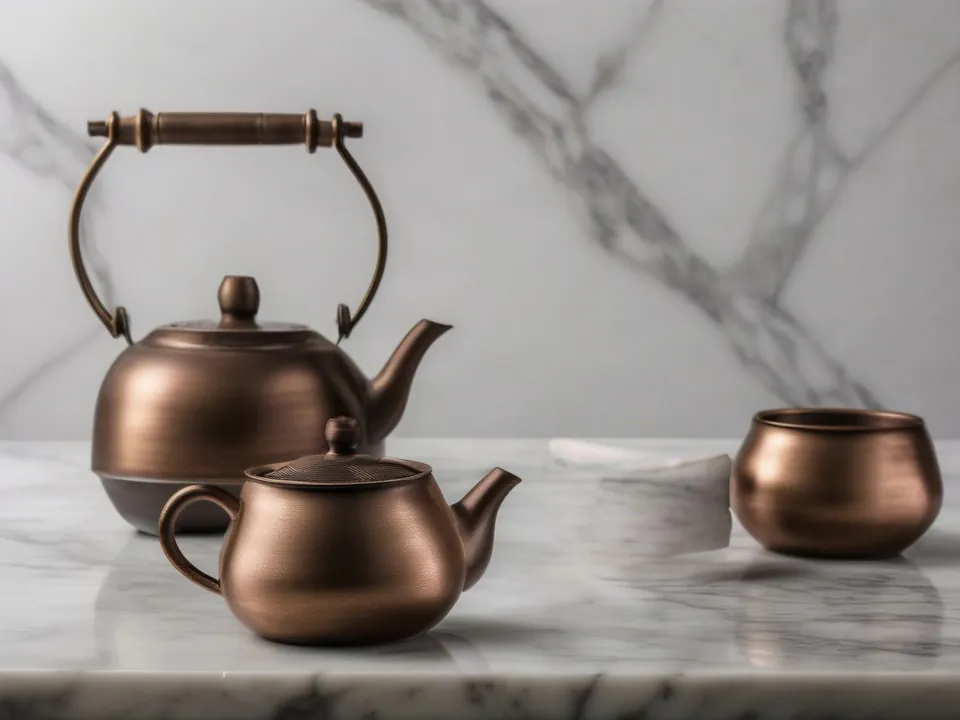
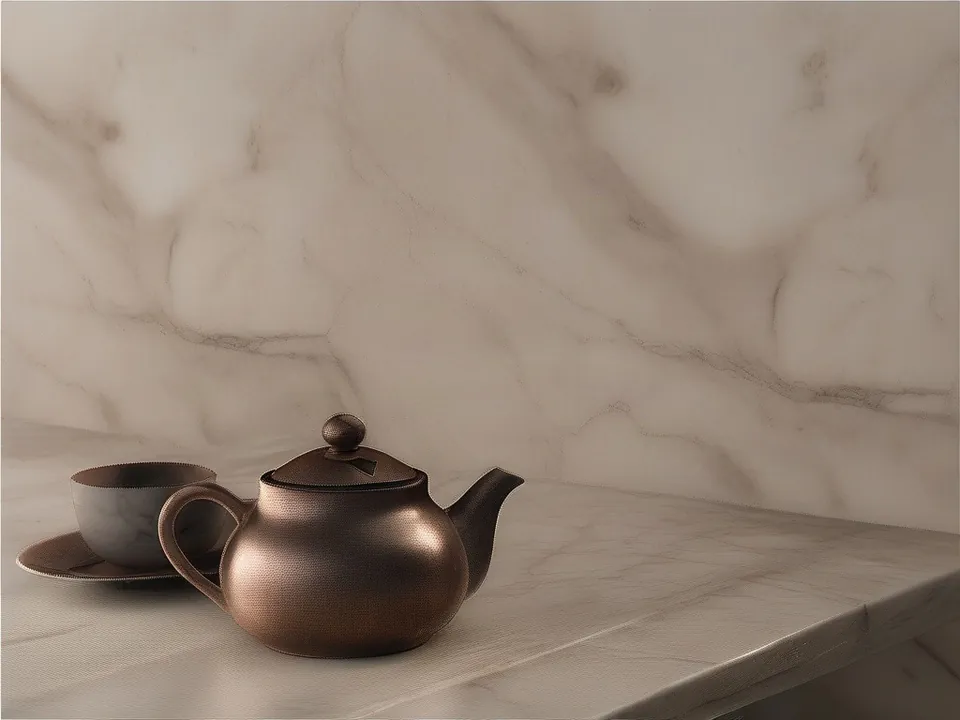
Modelo: Stable Diffusion XL 1.0 (przez API fal.ai, 30 kroków, CFG 7,5) + ControlNet canny SDXL. Configurações: contornos da imagem do verbete sobre passos, seed 1411, variando apenas conditioning_scale. Data: 14.11.2026.
Prompt: a bronze metal teapot and two cups on a marble table, studio photo
Ao testar com força em 0,3, o modelo tratou os contornos com bastante liberdade: adicionou uma segunda chaleira com alça e uma tigela, deixando a disposição da mesa tomar outro rumo. Quando passei para 0,9, a jarra e a xícara foram desenhadas com precisão matemática na mesma posição e escala do traço guia, enquanto o prompt apenas forneceu os acabamentos de bronze e mármore. Como gerei a máscara com um filtro simples de detecção de bordas, o sistema também captou o ruído das ranhuras da madeira, transferindo essas falhas indesejadas para a imagem final.
Como é chamado em cada gerador
| Gerador | Parâmetro | Valores | Padrão |
|---|---|---|---|
| Stability AI (SD 3.5) | Control: Structure / Sketch - control_strengthValor do endpoint Structure | 0-1 | 0.7 |
| ComfyUI | ControlNetApplyAdvanced: strength, start_percent, end_percentIntervalos do código nodes.py (docs.comfy.org não os fornece) | strength 0.0-10.0 (passo 0.01); start/end 0.0-1.0 (passo 0.001) | strength 1.0; start 0.0; end 1.0 |
| Midjourney | nenhum | - | - |
| FLUX | sem ControlNet na API; composição por bounding boxes (FLUX 3) | boxes [top, left, bottom, right] na grade 0-1000 | - |
| Ideogram | nenhum (bbox em prompts JSON 4.0/4.5) | - | - |
| GPT Image | nenhum | - | - |
- Fontes consultadas em 14.11.2026:
- Stability AI: docs.stability.ai/api-reference/control/structure.md
- ComfyUI: raw.githubusercontent.com/comfyanonymous/ComfyUI/master/nod...
- Midjourney: docs.midjourney.com/hc/en-us/articles/32859204029709-Parame...
- FLUX: docs.bfl.ml/flux_3/flux3_image_overview.md
- Ideogram: docs.ideogram.ai/prompting/text-in-images
- GPT Image: developers.openai.com/api/docs/guides/image-generation
Quando usar
- Preservar a composição espacial de uma fotografia ao mudar materiais, iluminação ou clima da cena
- Fixar a pose corporal exata de um personagem em storyboards e ilustrações conceituais
- Manter linhas de perspectiva e geometria de móveis em projetos de interiores e arquitetura
Erro comum
Trabalhar com peso de controle em 1,0 ou superior quando a imagem de contorno está poluída ou com ruído visual excessivo, pois a IA vai reproduzir fielmente cada artefato sujo no resultado. Outro erro comum é carregar arquivos de ControlNet projetados para uma arquitetura diferente da do modelo gerador que está ativo.
Exemplo pronto para copiar
ComfyUI:  Apply ControlNet -> strength = 0.8, start_percent = 0.0, end_percent = 1.0
Stability (Control):  /control/structure com "control_strength": 0.7
Perguntas frequentes
O que faz o pré-processador canny no ControlNet?
Ele detecta as bordas e os contrastes da sua imagem original, transformando tudo em um desenho de linhas brancas sobre fundo preto que serve de guia rígido para a nova criação.
Qual é a faixa ideal para o peso de controle?
Na maioria dos fluxos criativos, valores situados entre 0,6 e 0,8 oferecem um ponto de equilíbrio saudável, garantindo fidelidade geométrica sem travar a riqueza de texturas do prompt.
O que ocorre se o peso for definido muito próximo de zero?
O modelo praticamente ignora o mapa de entrada, criando elementos aleatórios e usando a referência estrutural apenas como uma sugestão vaga de composição.
Posso combinar mais de um ControlNet ao mesmo tempo?
Sim, é comum associar uma camada de pose humana com uma camada de mapa de profundidade, equilibrando os pesos de cada uma para não sobrecarregar a geração.